Meta发布开源模型Muse Glimmer,30B参数,Apache 2.0许可
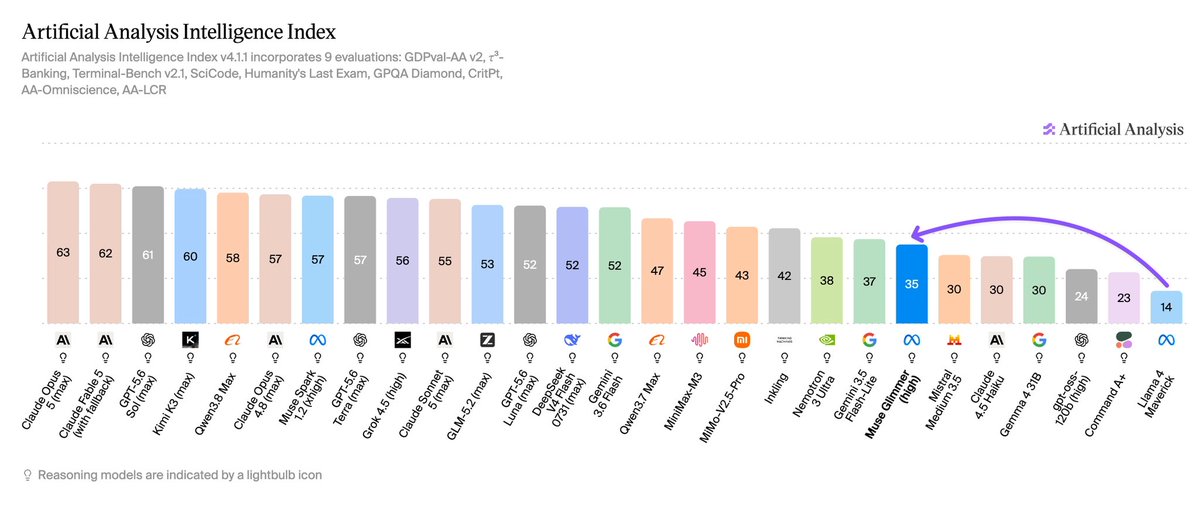
转推 @ArtificialAnlys: Meta回归开源权重:Muse Glimmer,自Llama 4以来首个开源权重发布,在Artificial Analysis Intelligence Index上得分35。这是一个30B参数模型,也是Meta首个以Apache 2.0许可发布的模型。
Muse Glimmer(high)在Llama 4之后16个月发布,比Meta上次开源权重发布Llama 4 Maverick(14)高出21分。它与Kimi K2.5(推理,36)并列,仅次于Qwen3.6 27B(推理,38)和Ling 3.0 Flash(38),并与专有旗舰Muse Spark 1.2(xhigh,57)一起构成Meta的双层产品线。
@AIatMeta在公开发布前与我们共享了访问权限用于基准测试。祝贺@AIatMeta、@finkd和@alexandr_wang发布!
关键要点:
➤ Meta的开源权重线回归,采用迄今最宽松的许可。此前Meta的每次开源发布都使用Llama License;Muse Glimmer使用Apache 2.0,对商业使用或衍生品几乎不加限制。
➤ 在参数数量上表现出色。在30B参数下,Muse Glimmer得分比同尺寸的Gemma 4 31B(推理,30)高5分,并以33倍少的参数有效匹配1T总参数的Kimi K2.5(推理,36)。Qwen3.6 27B(推理,38)在智能与参数前沿上仍领先,且尺寸略小。
➤ 足够小,可在单个GPU上自托管,即使在完全上下文长度下。Muse Glimmer是一个30B稠密模型(包括约1.8B视觉编码器),权重在BF16下约60GB,4位下约18GB。它采用混合注意力机制,每个全局层有三个滑动窗口层,将KV缓存内存使用控制在扩展前128K上下文下约1.8GB(最小值)。这意味着模型可以在BF16精度下在单个H100上全上下文运行,或在较高配置的MacBook或RTX 5090上以4位运行,如果不需要视觉编码器则有更多空间。
➤ 代理知识工作是相对于其尺寸类别的弱点。Muse Glimmer在GDPval-AA v2上得分953 Elo,低于1000的人类基线,落后于同智能水平的其他模型,包括类似尺寸的Qwen3.6 27B(推理,1141)和Gemini 3.5 Flash-Lite(1141)。知识校准遵循相同模式:其AA-Omniscience Index为-33,低于其智能水平,主要由于82%的幻觉率(Qwen3.6 27B:49%)而非准确性,在准确性上与其同行相当。代理工具使用是个例外,Muse Glimmer在Tau3-Banking上得分24%,领先Gemini 3.5 Flash-Lite(18%)和Qwen3.6 27B(17%),属于同类最佳。
其他模型详情:
➤ 参数:30B稠密
➤ 上下文窗口:128K tokens,外加扩展
➤ 许可:Apache 2.0
➤ 开放指数:44,表明相对其他主要开源权重模型较高的开放性/透明性
➤ 定价和输出速度:发布时Meta未在其API上提供服务;定价和服务速度取决于第三方提供商。