编码agent的harness对模型表现影响巨大,小模型配好harness也能超越大模型。
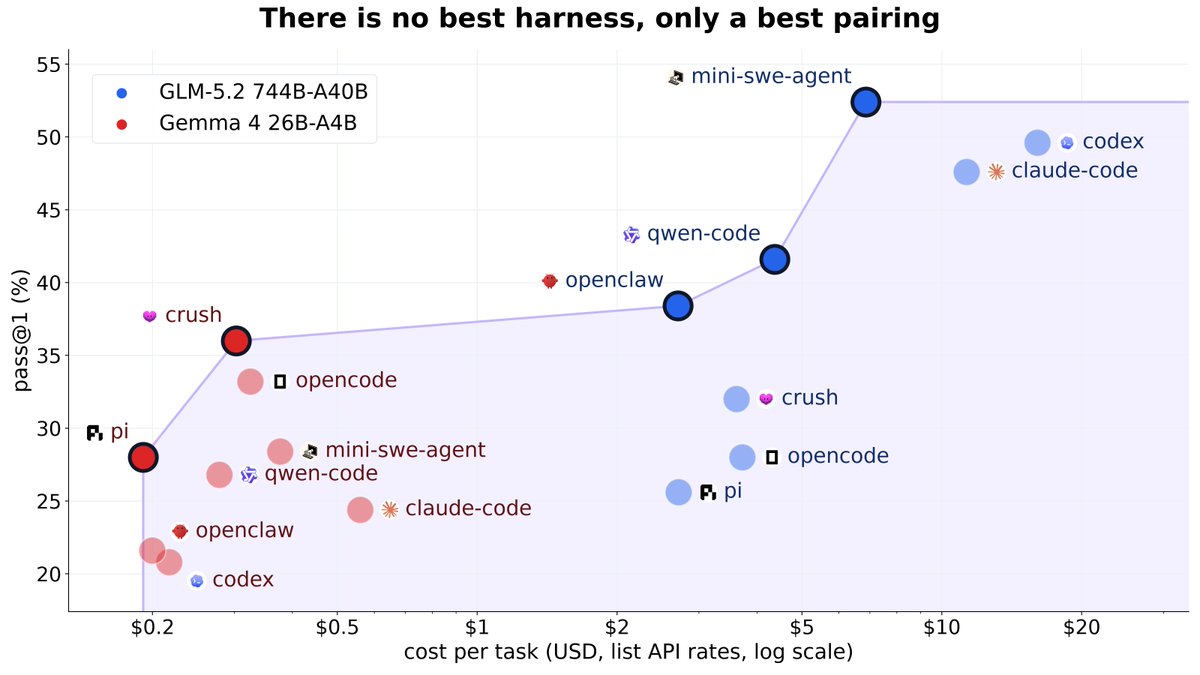
转推 @joelniklaus: Codex 对大型模型过度优化:它在 GLM 5.2 的 10 个中排名第 2,但在 Gemma-4 上却跌至第 9!这个领域的几乎所有精力都花在调整权重上。我们想知道最终数字有多少是由包裹在模型外的 harness(测试框架)决定的,于是我们在 SWE-bench Pro 上用两个模型运行了 10 个编码 agent harness。结果发现,影响很大。更换 harness 使 pass@1 在 GLM-5.2 上从 23% 提升到 52%,在 Gemma 4 26B-A4B 上从 15% 提升到 36%——这比大多数模型发布带来的提升还大。而且排名不具备迁移性。两个模型的 harness 排行榜之间的秩相关系数为 -0.05,也就是说:毫无相关性。Codex 并非孤例。每个模型厂商自带的 harness 在小模型上排名都会下降——Codex 从第 2 跌到第 9,Claude Code 从第 3 跌到第 7,Qwen Code 从第 4 跌到第 6——而模型无关的 harness 则上升:crush 从第 7 升到第 1,opencode 从第 8 升到第 2,pi 从第 9 升到第 4。最明显的例子是 crush,在 GLM-5.2 上排第 7,在 Gemma 4 上排第 1。在两个模型上运行相同的脚手架,小模型以 1/12 的价格、每个任务 $0.30 对比 $3.61,反而高出 4 个点。Gemma 4 的最佳 harness 胜过 GLM-5.2 最差的四个。正确脚手架下的 26B 模型与错误脚手架下的 744B 模型相差无几。每个已解决任务的成本:Gemma 4 + crush 为 $0.84,成功率 36%。表现相当的 GLM-5.2 最便宜配置是 openclaw,成功率 38%,成本 $7.05。每个任务的输出 token 数量在不同 harness 间从 16k 到 621k 不等:你支付的费用有 39 倍差异,而获得的结果只有 2 倍差异。97% 的输入 token 是重新发送的对话前缀,因此 prompt 缓存非常重要。实验设置:每个 harness 在两个模型上运行相同的 250 个 SWE-bench Pro 任务,各做一次 rollout,价格按实际消耗的 token 以列表 API 费率计算。图中,深色环表示该组合位于两个模型的 Pareto 前沿上,淡色点表示你可以在别处以更低成本获得更高分数;为清晰起见,10 个 harness 中有 2 个(goose 和 hermes)未在图中显示。