DeepSeek 模型在 M5 Max 上达 55-36 tokens/s,使用 UD-Q2KXL 量化与 MXFP4 草稿模型。
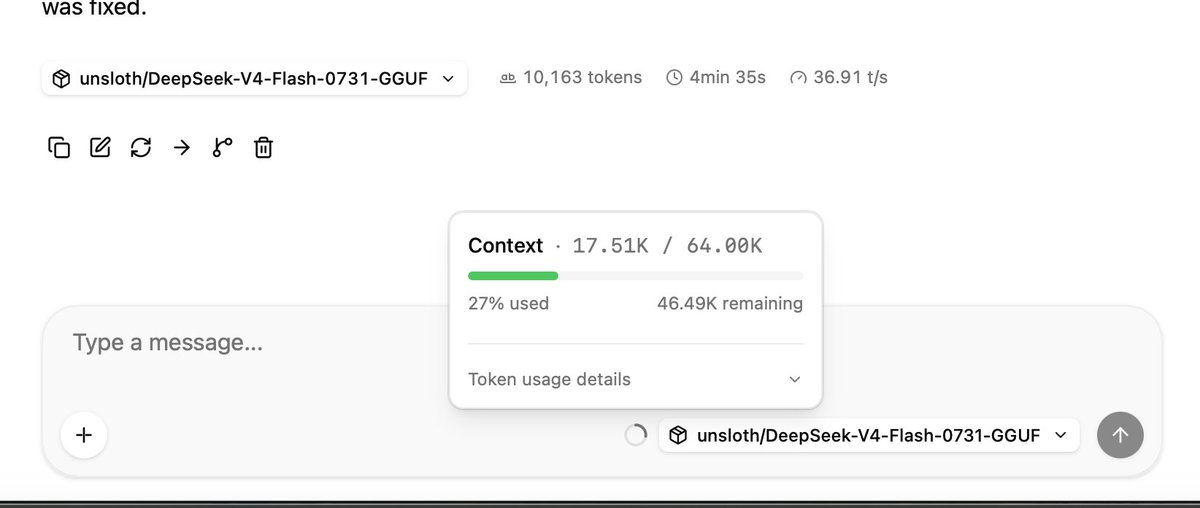
转推 @alekgrygier:超现实。DeepSeek-V4-Flash-0731 在我的 M5 Max MacBook Pro 上,使用 15k+ 上下文,速度达到 55-36 tokens/s。我用了 @unsloth 的 UD-Q2_K_XL 量化 + @ggml_org 的 MXFP4 DSpark 草稿模型。 https://t.co/u3j8Uy908I