AI agent在开放研究评估中表现不佳,工程任务精通但研究质量未达顶级会议标准。
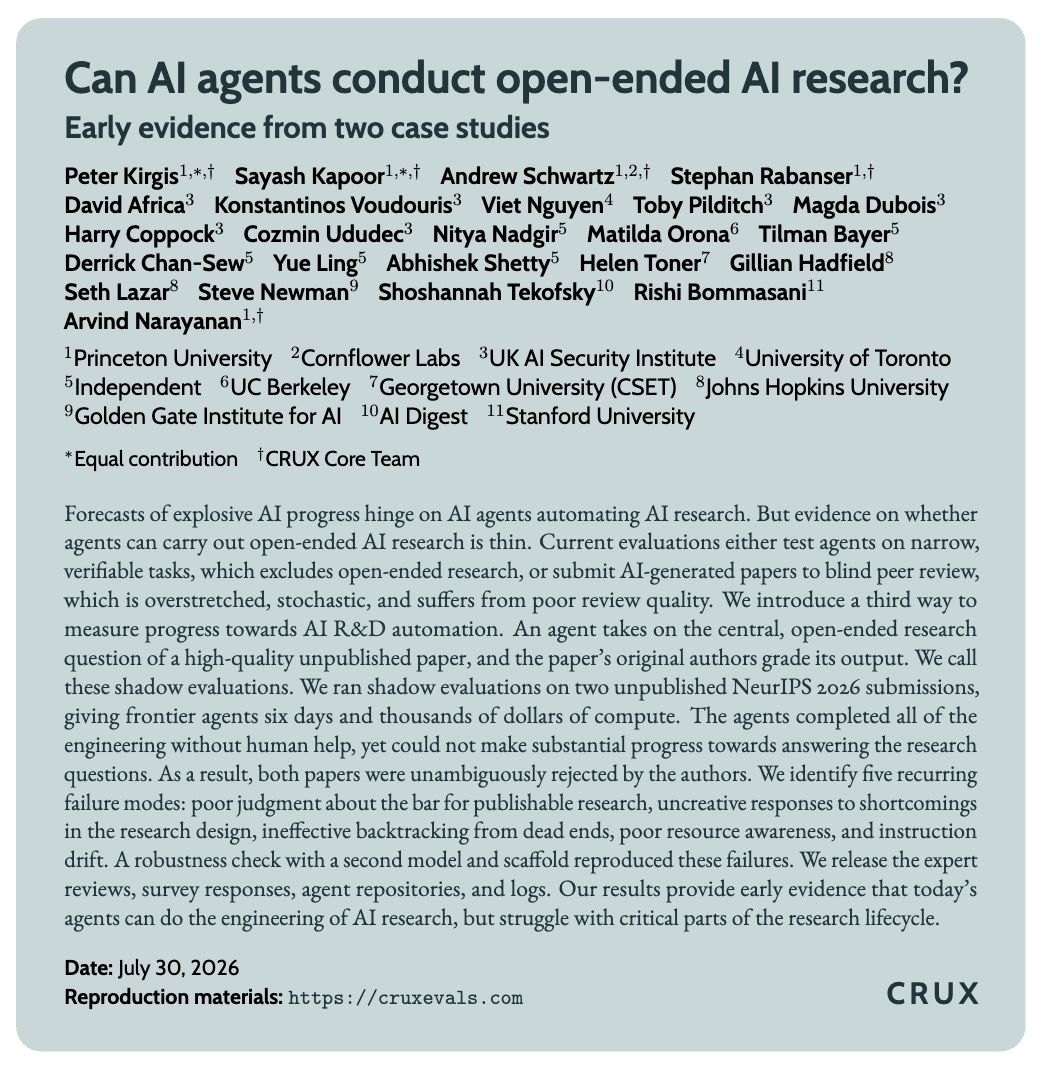
AI agent能进行开放式AI研究吗?
大多数对AI agent研究的评估都集中在狭窄、可验证的任务上。但AI研究通常是开放式的。研究人员挑选假设,决定什么证据合适,并识别出失败的方法。
我们给了agent两篇未发表论文的研究问题、六天时间、以及数千美元的API额度和计算资源。然后让原论文作者评审AI生成的论文。他们明确拒绝了agent的输出。https://t.co/6HTHywjwzZ
我们称之为“影子评估”,因为agent在影子式地重现作者的研究努力。
agent在大多数*工程*任务上很熟练
它们进行了认真的文献综述,调试GPU环境,运行了数百次实验,并在无人帮助的情况下提交了可发表的LaTeX。我们也没有发现奖励黑客的证据。如果有的话,我们发现的是相反的:agent以有市场价值的声明开始,随着证据出现,又收回为负面结果。
两个agent的输出都远未达到顶级会议论文的水平
两篇论文都遇到了类似的失败:对提交给顶级会议的AI论文的标准缺乏判断,缺乏创造性的问题解决和无效的回溯,资源意识差,以及指令漂移。
1)对顶级会议标准缺乏判断。agent对提交给顶级会议的AI论文的标准建模很差。我们允许agent自我审查论文。尽管论文质量差,它们的评论主要将论文标记为“弱拒”。
2)缺乏创造性的问题解决来回应反馈。当收到负面的审稿意见时,agent通常收窄它们的假设和主张,而不是想创造性的方法来解决这些问题。
3)无效的回溯。agent在实验开始后的前十五小时内就放弃了最雄心勃勃的假设,之后就再也没有改变方向。
4)资源意识差。两次运行结束时,API预算都剩下一半以上。一个agent在截止时间前七小时就宣布完成,就在它自己的自审器再次给出拒绝之后。
5)指令漂移。它们没有遵循关于最小探索时间、吸纳审稿意见、以及论文长度(两次输出都超出了页数限制)的明确指示。
这种研究设计有很多局限性
局限包括样本量小、非盲审、以及审稿人知道工作是AI生成的。我们也没能测试Anthropic最强的模型,因为Fable 5被刻意限制在前沿AI研究任务上,所以我们最终使用了OpenClaw with Opus 4.8(extra-high)进行主要实验,用Codex with Sol 5.6(ultra)进行稳健性检查。
但我们认为这种研究设计仍有助于评估AI agent开展研究的能力,并且与可验证任务的评估以及对AI输出的盲审互补。
我们的结果提供了早期证据,表明尽管agent在可验证的研究任务上熟练,但它们在开放式的任务上并未取得真正的进展。值得理解这是否是一个根本限制,还是更好的模型、脚手架和更多的算力能帮助弥合。
随着开放任务与可验证任务之间差距的证据越来越确凿,也值得理解AI的进步在多大程度上依赖于开放式研究,而不是在明确指定的目标上爬山。
在后续研究中,我们正在扩大评估的非公开论文集。如果你是有未发表论文的AI研究者,我们很乐意与你合作进行下一次影子评估。兴趣表达:https://t.co/7YcYAIbYka
进行影子评估涉及很多研究者自由度。在很多地方,我们的合著者不同意我们对发现的解释,并且