Inkling-Small模型发布,性能媲美大模型
RT @andimarafioti: Thinking Machines 刚刚发布了 Inkling-Small:总参数量276B,激活12B。一个更快的 Inkling,在许多基准测试中匹配或超越其975B的大兄弟。
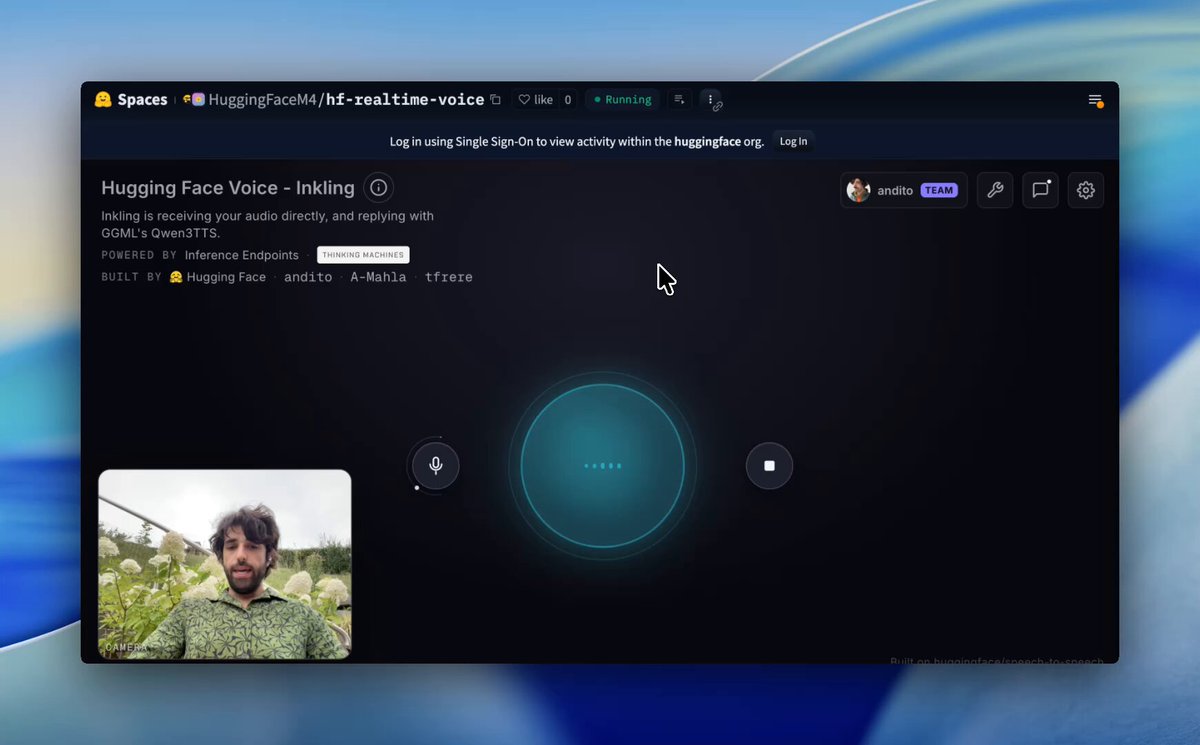
为测试其速度,我们将其接入 HF 的语音到语音管道。音频直接输入模型,并使用 faster-Qwen3TTS 进行回复。运行在8块 RTX Pro 6000 Blackwell 上,我们在500ms内得到音频回传。
普通 Inkling 需要2TB显存,这个版本只需要一台节点。
由于模型听到的是音频而非转录文本,它可以感知你的语调和情绪。你可以在视频中查看。
或者直接去空间试试!非常有趣的模型:
https://t.co/KBwMUx0G7l
https://t.co/2uIvWG1pYU
为测试其速度,我们将其接入 HF 的语音到语音管道。音频直接输入模型,并使用 faster-Qwen3TTS 进行回复。运行在8块 RTX Pro 6000 Blackwell 上,我们在500ms内得到音频回传。
普通 Inkling 需要2TB显存,这个版本只需要一台节点。
由于模型听到的是音频而非转录文本,它可以感知你的语调和情绪。你可以在视频中查看。
或者直接去空间试试!非常有趣的模型:
https://t.co/KBwMUx0G7l
https://t.co/2uIvWG1pYU