CoRT通过反事实回放改进GRPO的token级信用分配,提升4.4分
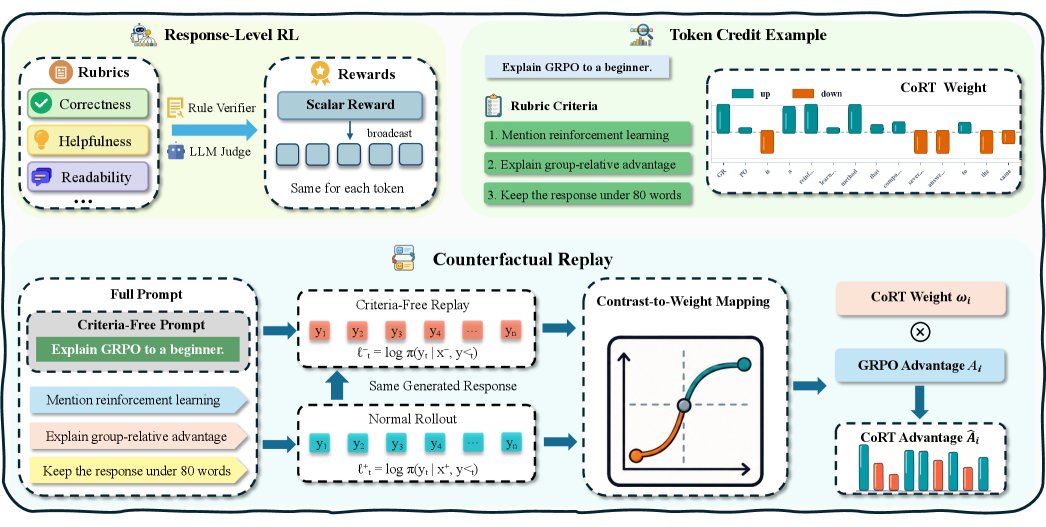
RT @HuggingPapers: CoRT:基于规则引导强化学习的令牌级信用分配
GRPO中的规则反馈被压缩为单一标量奖励,均匀广播给每个令牌。CoRT通过反事实回放修复了这个问题,使响应级GRPO平均提升4.4分。https://t.co/vh8vqk0tHo
GRPO中的规则反馈被压缩为单一标量奖励,均匀广播给每个令牌。CoRT通过反事实回放修复了这个问题,使响应级GRPO平均提升4.4分。https://t.co/vh8vqk0tHo