公司和个人的知识散落在各处:PDF、邮箱、网盘、工单。大多数建立在其上的 AI 工具,要么检索出一堆文本块,要么让智能体通过 MCP 和 API 调用去搜索、靠猜。它很慢,还烧 token,而且你不总能看出答案来自哪里。我们想要能核验的答案。所以我们做了 yggy,把这一团乱麻变成自动构建的知识图谱。
工作原理:引入数据。上传文档、连接你的系统,或通过 API push 数据。yggy 负责结构化。它会读取所有内容,把实体和关系抽取进你的 ontology,对重复项做 merge,并把每条事实链接回来源。随你使用。在应用里提问,基于 REST API 开发,或通过 MCP 把图谱接入你的智能体。 我们在意什么透明:每个答案都指向它的来源,你能看到 yggy 做了什么以及为什么。符合 ontology:事实落到我们和你共同定义的结构里,而不是一堆松散文本。开发者优先:REST API、MCP、CLI 和 SDK,文档专为构建者写。多租户且安全:每个组织和项目都隔离,支持 SSO、带作用域的 API token 和审计日志。可修复:merge 可回滚,不明确的情况会进入审核队列。属于你:托管在欧盟,GDPR 优先。只想把自己的笔记放进图谱?我们专门做了 yggy notes 就是为此。
我们是 Dominik、Carlos 和 Max,也是 yggy 背后的团队,很高兴终于能把它展示给你们。
公司和个人的知识散落在各处:PDF、邮箱、网盘、工单。大多数建立在其上的 AI 工具,要么检索出一堆文本块,要么让智能体通过 MCP 和 API 调用去搜索、靠猜。它很慢,还烧 token,而且你不总能看出答案来自哪里。我们想要能核验的答案。所以我们做了 yggy,把这一团乱麻变成自动构建的知识图谱。
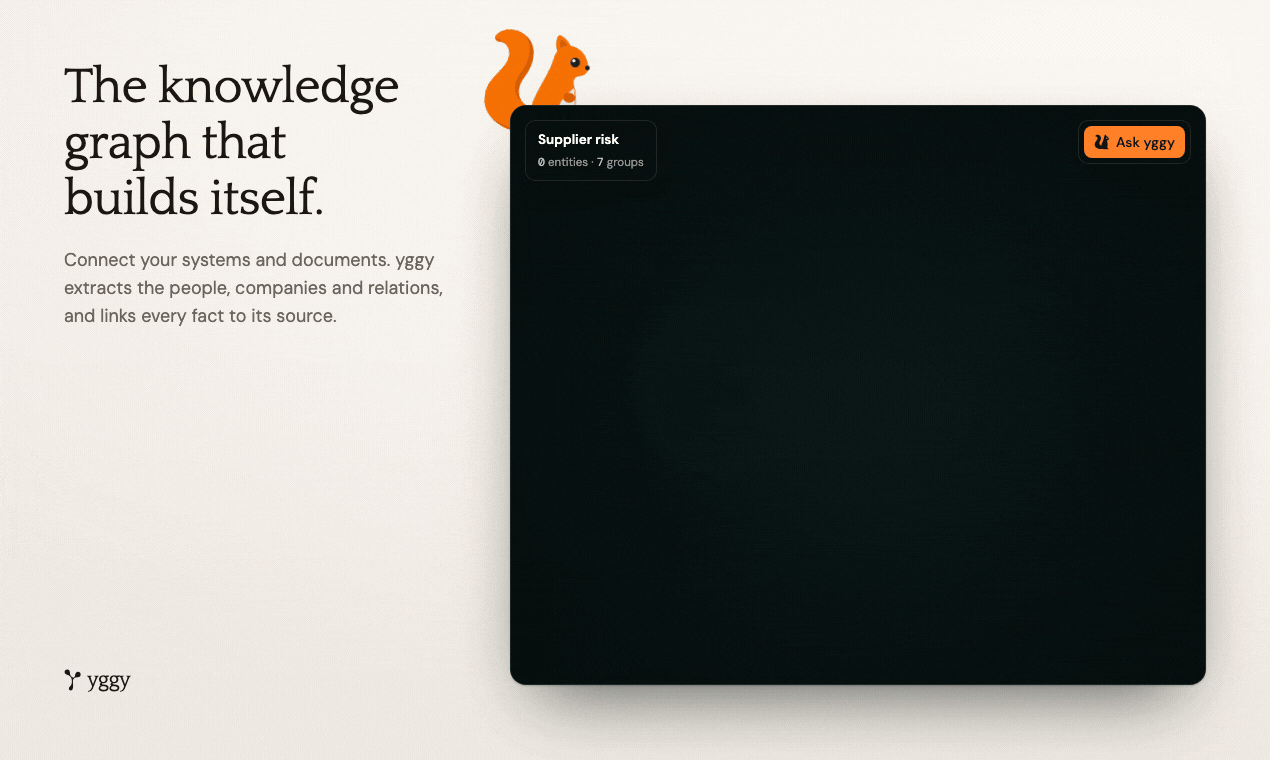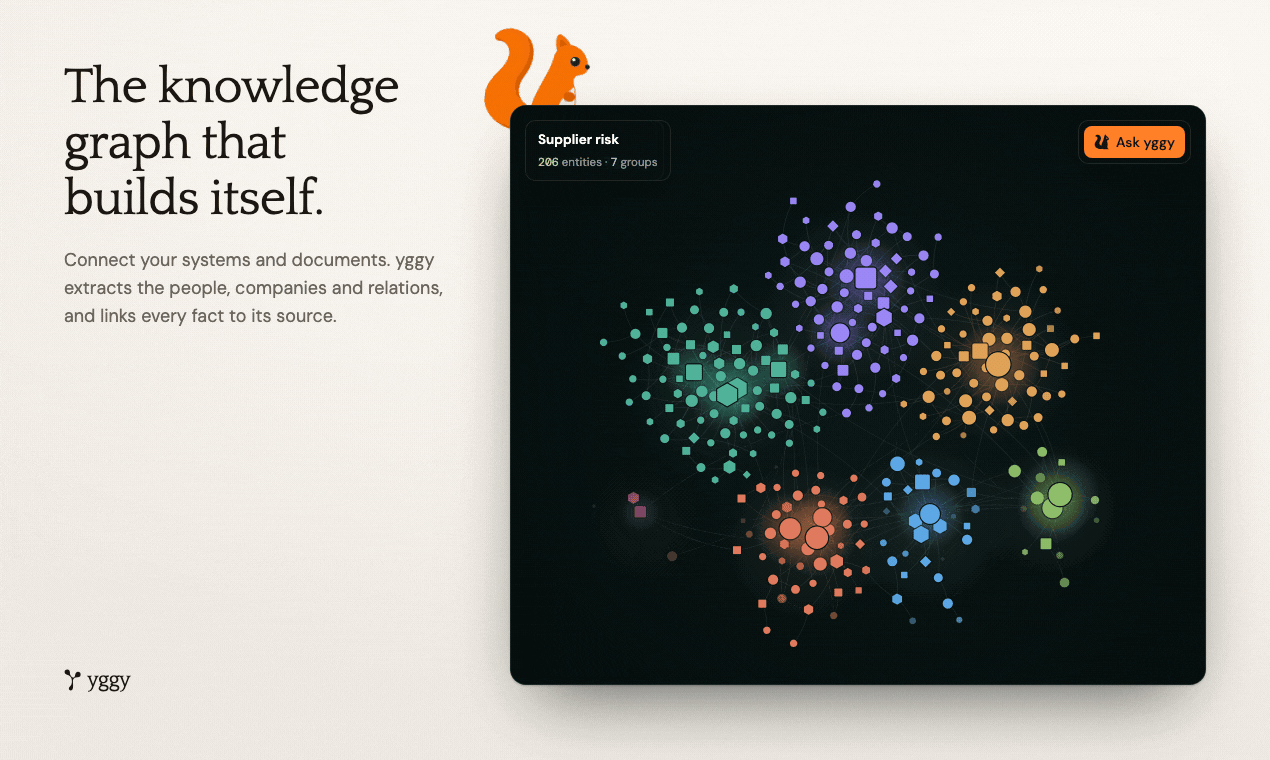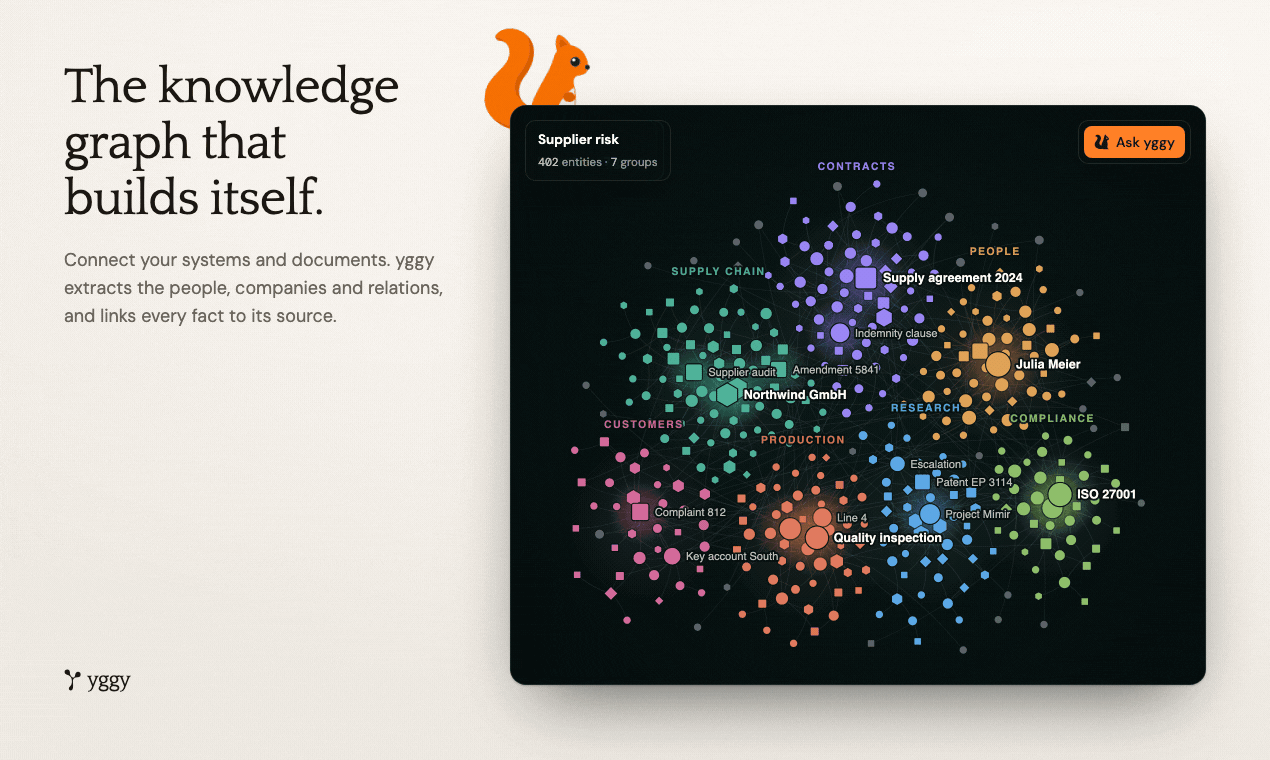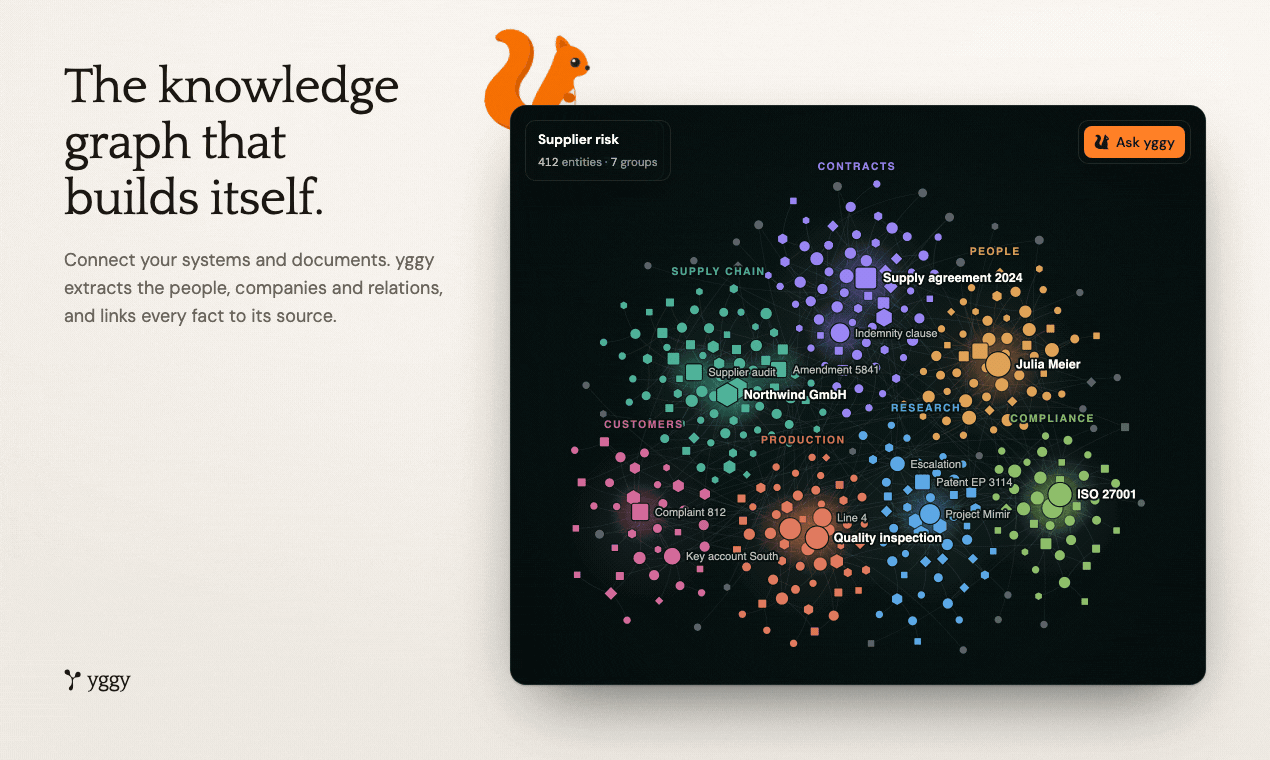
工作原理:引入数据。上传文档、连接你的系统,或通过 API push 数据。yggy 负责结构化。它会读取所有内容,把实体和关系抽取进你的 ontology,对重复项做 merge,并把每条事实链接回来源。随你使用。在应用里提问,基于 REST API 开发,或通过 MCP 把图谱接入你的智能体。
我们在意什么透明:每个答案都指向它的来源,你能看到 yggy 做了什么以及为什么。符合 ontology:事实落到我们和你共同定义的结构里,而不是一堆松散文本。开发者优先:REST API、MCP、CLI 和 SDK,文档专为构建者写。多租户且安全:每个组织和项目都隔离,支持 SSO、带作用域的 API token 和审计日志。可修复:merge 可回滚,不明确的情况会进入审核队列。属于你:托管在欧盟,GDPR 优先。只想把自己的笔记放进图谱?我们专门做了 yggy notes 就是为此。
欢迎提问、抛来最难的挑战,或者单纯聊聊。我们全天在线,每条评论都会看。
Dominik、Carlos 和 Max