Twigg Twigg 是面向开发者的有状态 LLM 调用 API,自动保存对话状态、压缩上下文并路由模型请求,帮团队省去自建上下文管理层的成本。 热门评论 PH 用户Hi Product Hunt过去一年我们一直在做 AI 工作空间,而每次要发布新东西之前,最后都会重新造同一个轮子:上下文层。对话放在哪里、怎么适配进模型的上下文窗口、工具调用和文件怎么回放。我们真正想要的,是一个托管、有状态的 LLM API,而且不只支持一家提供商。大概就像 OpenAI 的 Responses API 和 OpenRouter 的结合体。我们不想花时间搭那些并非产品核心的基础设施和代码。既然大部分模块我们已经做好了,就把它们变成了 Twigg:面向所有 LLM 的有状态 API。工作原理是这样:你创建一个 chat,拿回一个 ID。之后你只要发送下一个 prompt 或工具结果。你不需要发送,甚至不需要存储上下文,Twigg 会替你管。想换个模型?在下一次请求里改一个字段就行。Twigg 会获取、组装上下文,并把它适配到正确的 schema,然后返回响应。它甚至会自动压缩对话,所以你永远不用操心 chat 变得太长。思路就是把 LLM 应用需要的所有样板逻辑和基础设施,都挪到一个统一的 API 后面。v0.1.0 今天上线了。它包含按用户组织 chat 的命名空间,一个管理 system prompts、tool schemas 和上下文预算的仪表盘。它还会追踪每次运行的成本和用量,方便你向自己的用户计费。把你的智能体指向 twigg.ai/llms.txt,看完整说明!我们很想听听你的想法,也想知道有没有人遇到过和我们一样的上下文烦恼。感谢来看看!PH 用户把上下文压缩做成服务,不错。每个智能体团队都得重造一遍,而且从来都不轻松 😅 恭喜!!PH 用户不错!我真的很喜欢这个。PH 用户这听起来真的非常方便,因为我光是为了让 Claude 理解我项目的所有上下文,就花了好多 token。PH 用户truncate/compact-to-fit-schema 这部分,总是我最后手搓得很烂的那块。好奇 Twigg 在 chat 超出目标模型的上下文窗口时,是怎么决定丢掉什么的——是简单地从最旧的消息开始裁,还是会尽量保留比如固定的 system instructions 和后续轮次仍然依赖的 tool call 结果?PH 用户Twigg 支持 branch 式对话吗,比如从同一个上下文里尝试两种不同的工具选择? 热门产品Matti De Beer2026-09-16原文 打开互动版
过去一年我们一直在做 AI 工作空间,而每次要发布新东西之前,最后都会重新造同一个轮子:上下文层。对话放在哪里、怎么适配进模型的上下文窗口、工具调用和文件怎么回放。
我们真正想要的,是一个托管、有状态的 LLM API,而且不只支持一家提供商。大概就像 OpenAI 的 Responses API 和 OpenRouter 的结合体。我们不想花时间搭那些并非产品核心的基础设施和代码。
既然大部分模块我们已经做好了,就把它们变成了 Twigg:面向所有 LLM 的有状态 API。
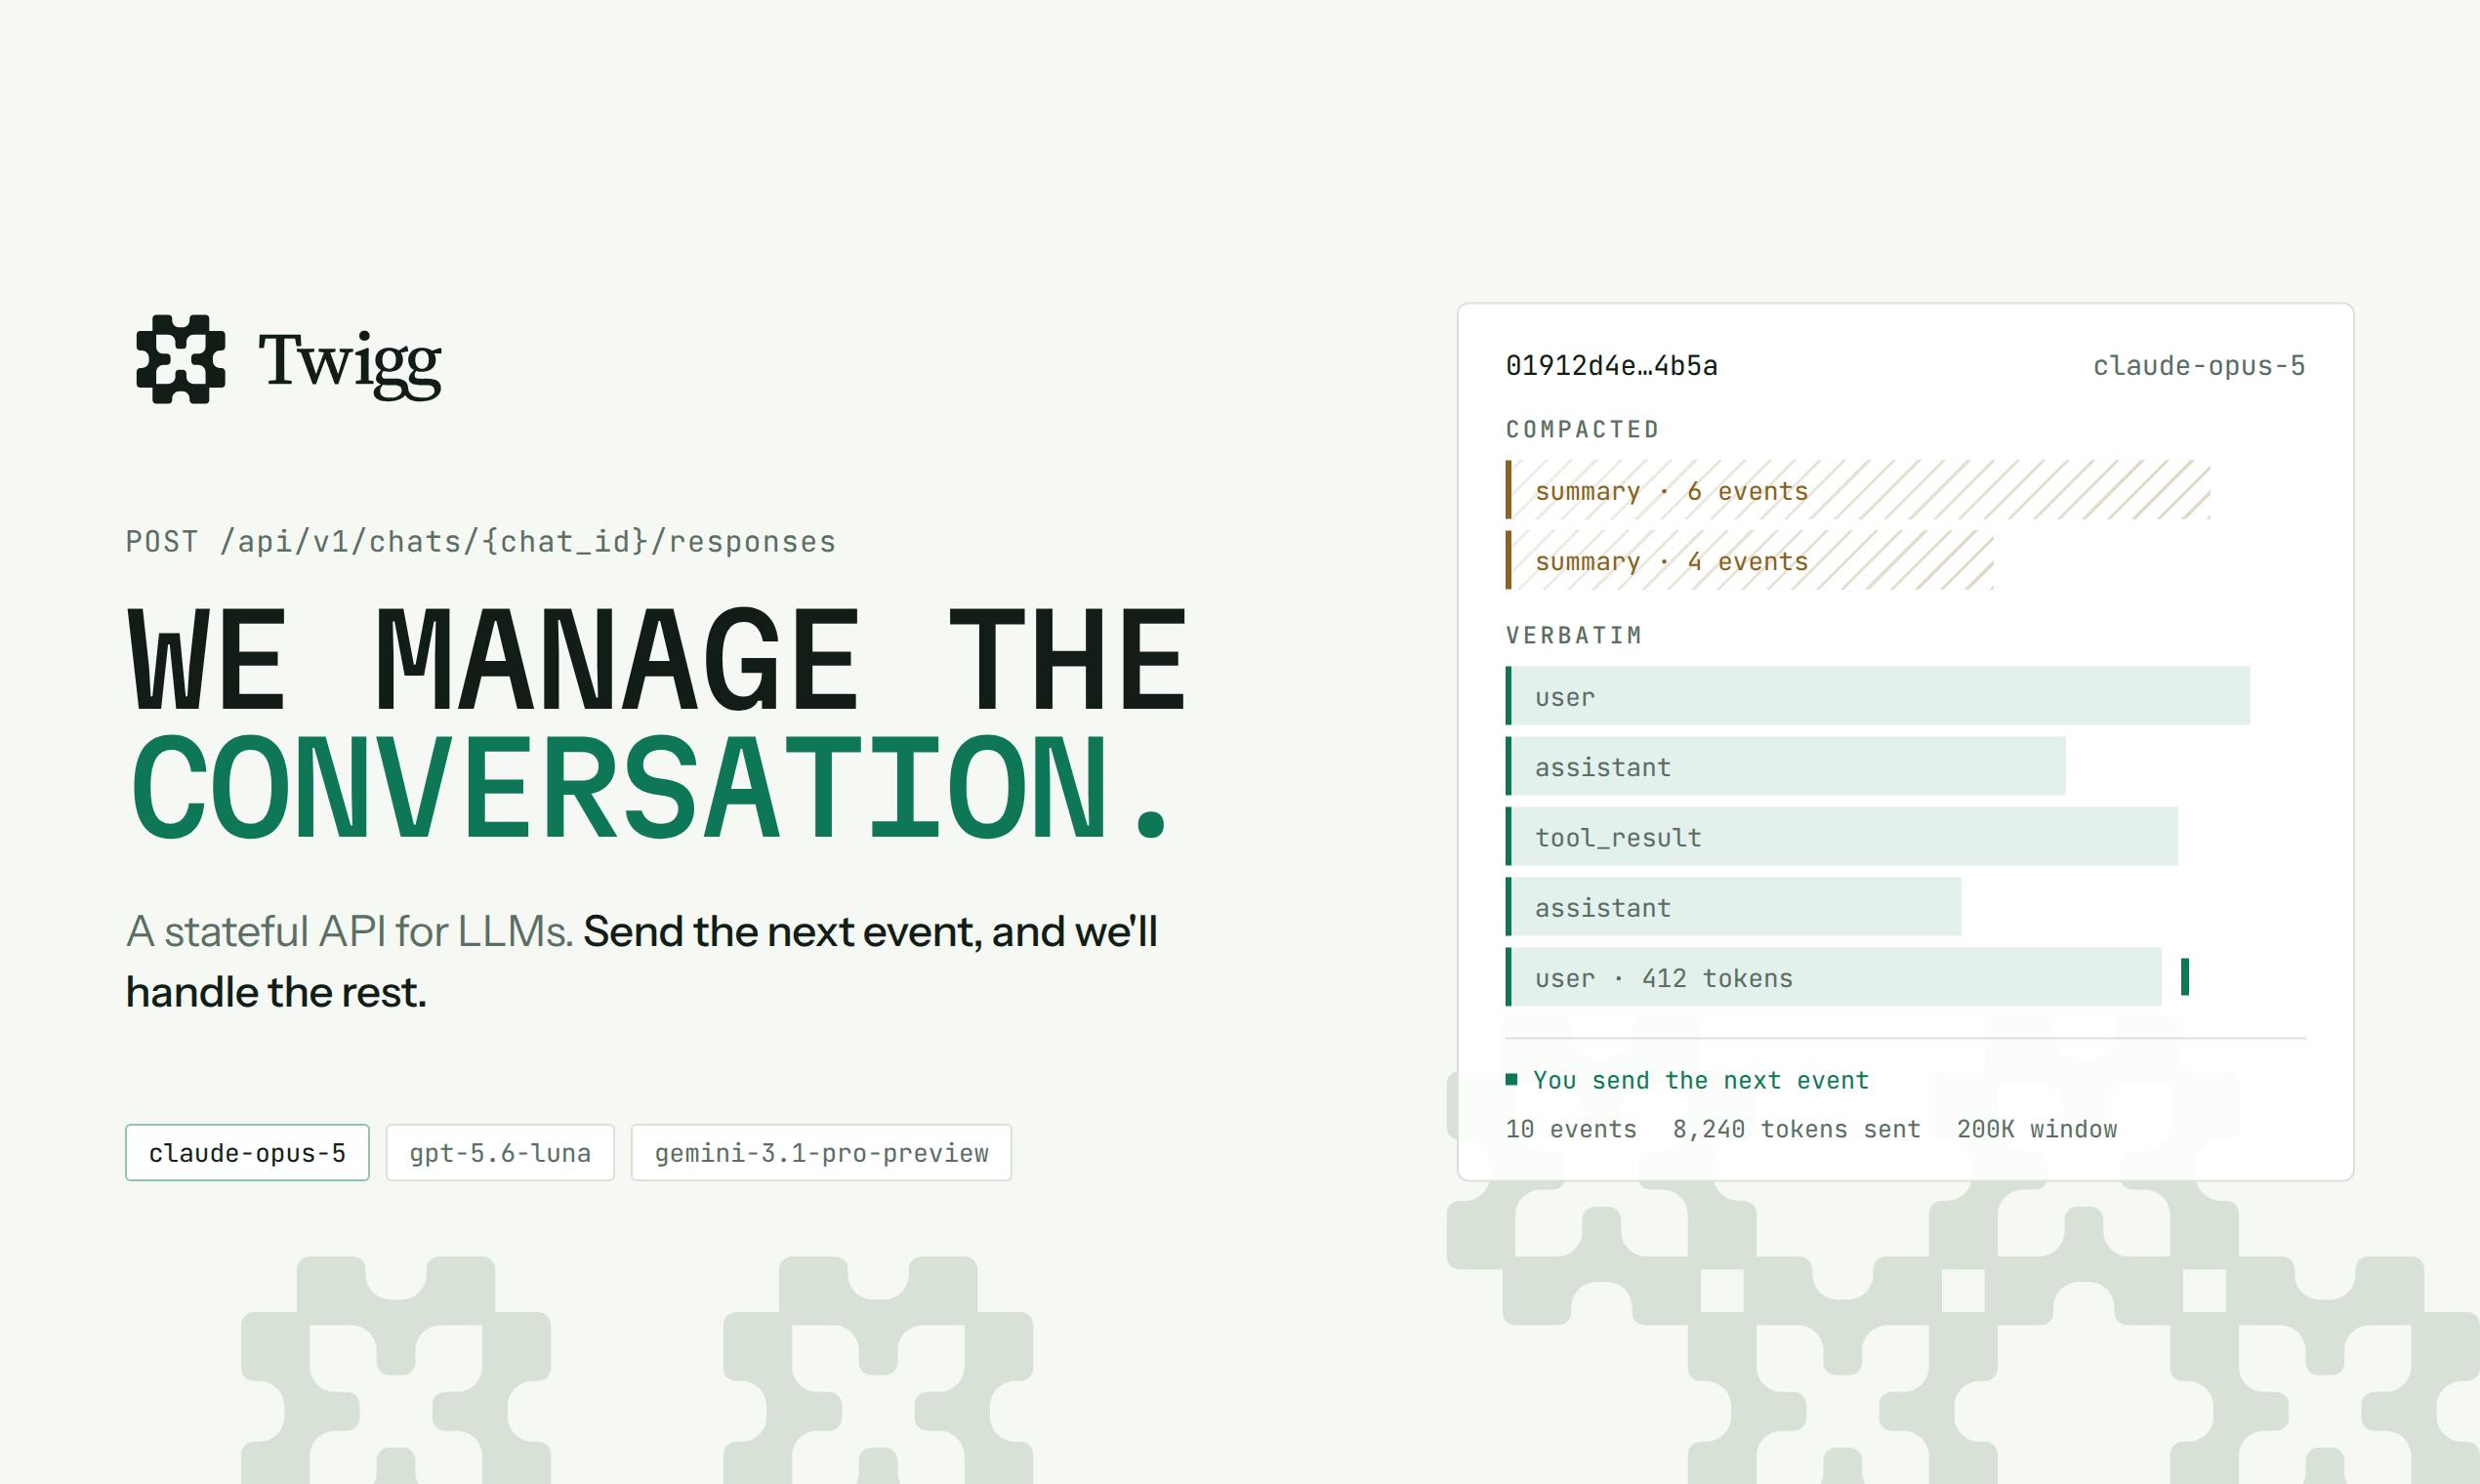
工作原理是这样:你创建一个 chat,拿回一个 ID。之后你只要发送下一个 prompt 或工具结果。你不需要发送,甚至不需要存储上下文,Twigg 会替你管。想换个模型?在下一次请求里改一个字段就行。Twigg 会获取、组装上下文,并把它适配到正确的 schema,然后返回响应。它甚至会自动压缩对话,所以你永远不用操心 chat 变得太长。思路就是把 LLM 应用需要的所有样板逻辑和基础设施,都挪到一个统一的 API 后面。
v0.1.0 今天上线了。它包含按用户组织 chat 的命名空间,一个管理 system prompts、tool schemas 和上下文预算的仪表盘。它还会追踪每次运行的成本和用量,方便你向自己的用户计费。把你的智能体指向 twigg.ai/llms.txt,看完整说明!
我们很想听听你的想法,也想知道有没有人遇到过和我们一样的上下文烦恼。
感谢来看看!