StillTalk StillTalk 把一张生成照片变成能开口说话的角色,由 GPT-6 Astra 驱动、本地浏览器实时渲染,面向想做低成本口播动画的内容创作者,无需注册即可生成多语言语音。 热门评论 PH 用户用来做小角色视频应该挺好玩。好奇到目前为止大家都拿它做什么。PH 用户我觉得当你不想自己出镜录制时,拿它做快速视频会挺有用。想法挺简单,但我喜欢。PH 用户语言支持挺有意思。切换语言时,口型同步还能保持准确吗?PH 用户说实话,让照片说话这个功能还挺酷的。我想知道用不同照片时它看起来有多自然。PH 用户Product Hunt 大家好 👋 我是 Piotr,StillTalk 的创始人。StillTalk 能把一张生成的照片变成一个会说话的角色,而且它不是视频。你的设备在浏览器里实时绘制每一帧。服务器只发送语音和紧凑的动作数据:没有视频流,也没有按分钟计费的云端渲染器。现在就可以试试,无需注册:从五个角色里挑一个,从六种语言里挑一种,玩一段绕口令,或者输入你自己的句子听它念出来。Astra 的故事:GPT-6 Astra 设计并实现了渲染引擎、口型动作、校准和测试。我的工作是设定质量标准,并一直说“还不行”:某个眨眼位置太高,某个嘴型在波兰语里没问题,在法语里却不行。我们在 9 月 12 日星期六发现了这个挑战。当时引擎只能用一个角色。接下来一天里,Astra 又做了四个角色,其中两个几乎不需要我修正,因为之前每一次修复都已经变成了自动化检查。从规模上看:光是 StillTalk 这个 thread 里就用了 18 亿+ token,我们最忙的一天用了 8.17 亿 token。这里面包含复用上下文。它衡量的是工作量,不是账单。老实说也有限制:实时输入用的是免费语音池,有每人限额。如果额度用完了,所有预先准备好的台词仍然能播放。接下来:商用 API、更丰富的角色库,以及一个从你自己的照片创建角色的 beta。这是一次非常高强度冲刺的成果。我对它现在的状态很满意,而且我每天都在继续校准,所以从这里开始只会越来越好。很想听听你们的反馈:哪个角色感觉最活灵活现?在你的语言里,口型同步会在哪里崩掉?我一整天都在这里。PH 用户谢谢昨天所有观看、收听、投票和提问的人。作为一次背后没有受众基础的首次发布,这一天真的很棒,你们提的问题也让我清楚知道大家想从 StillTalk 得到什么。下面是我正在做的:更有生命力。每个角色的 lip-sync 单独调校,说话时面部动作更细微,会转头、往侧面和上方瞥,身体也更生动:手势、挥手、变换姿势。面向构建者开放。一个让你自己设参数的 studio,以及一个 API。更多选择。更多声音、更多语言、更多角色。你自己的角色,用一张照片或一段 prompt 生成。还有一条来自评论:导出成视频。@kyle_bennett6 和 @charlotte_reed1 都觉得 StillTalk 可以用来做短角色片段。它首先仍是实时引擎,但把一次表演保存成视频是很自然的附带功能(发布影片就是这么做的),所以已经列进清单。谢谢你们两位。还没有具体日期。比起快速上线,我更愿意每一步都做好再发布。更大的里程碑会作为新发布回到 Product Hunt。在那之前,demo 继续开放:去 stilltalk.ai 选一个角色,输入你自己的台词;如果想第一时间知道下一步什么时候上线,就留下邮箱。欢迎随时在这里评论、提建议,也可以通过 stilltalk.ai 的联系页面留言。 热门产品Piotr Janik2026-09-18原文 打开互动版
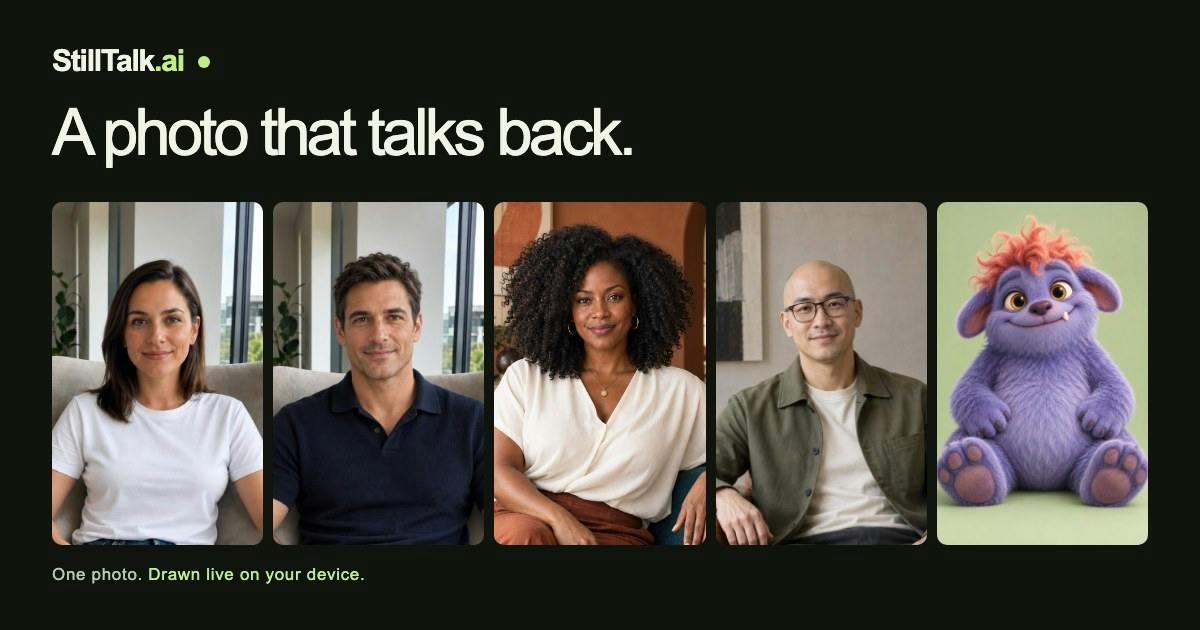
StillTalk 能把一张生成的照片变成一个会说话的角色,而且它不是视频。你的设备在浏览器里实时绘制每一帧。服务器只发送语音和紧凑的动作数据:没有视频流,也没有按分钟计费的云端渲染器。
现在就可以试试,无需注册:从五个角色里挑一个,从六种语言里挑一种,玩一段绕口令,或者输入你自己的句子听它念出来。
Astra 的故事:GPT-6 Astra 设计并实现了渲染引擎、口型动作、校准和测试。我的工作是设定质量标准,并一直说“还不行”:某个眨眼位置太高,某个嘴型在波兰语里没问题,在法语里却不行。我们在 9 月 12 日星期六发现了这个挑战。当时引擎只能用一个角色。接下来一天里,Astra 又做了四个角色,其中两个几乎不需要我修正,因为之前每一次修复都已经变成了自动化检查。
从规模上看:光是 StillTalk 这个 thread 里就用了 18 亿+ token,我们最忙的一天用了 8.17 亿 token。这里面包含复用上下文。它衡量的是工作量,不是账单。
老实说也有限制:实时输入用的是免费语音池,有每人限额。如果额度用完了,所有预先准备好的台词仍然能播放。
接下来:商用 API、更丰富的角色库,以及一个从你自己的照片创建角色的 beta。
这是一次非常高强度冲刺的成果。我对它现在的状态很满意,而且我每天都在继续校准,所以从这里开始只会越来越好。
很想听听你们的反馈:哪个角色感觉最活灵活现?在你的语言里,口型同步会在哪里崩掉?我一整天都在这里。
下面是我正在做的:更有生命力。每个角色的 lip-sync 单独调校,说话时面部动作更细微,会转头、往侧面和上方瞥,身体也更生动:手势、挥手、变换姿势。面向构建者开放。一个让你自己设参数的 studio,以及一个 API。更多选择。更多声音、更多语言、更多角色。你自己的角色,用一张照片或一段 prompt 生成。还有一条来自评论:导出成视频。@kyle_bennett6 和 @charlotte_reed1 都觉得 StillTalk 可以用来做短角色片段。它首先仍是实时引擎,但把一次表演保存成视频是很自然的附带功能(发布影片就是这么做的),所以已经列进清单。谢谢你们两位。
还没有具体日期。比起快速上线,我更愿意每一步都做好再发布。更大的里程碑会作为新发布回到 Product Hunt。
在那之前,demo 继续开放:去 stilltalk.ai 选一个角色,输入你自己的台词;如果想第一时间知道下一步什么时候上线,就留下邮箱。
欢迎随时在这里评论、提建议,也可以通过 stilltalk.ai 的联系页面留言。