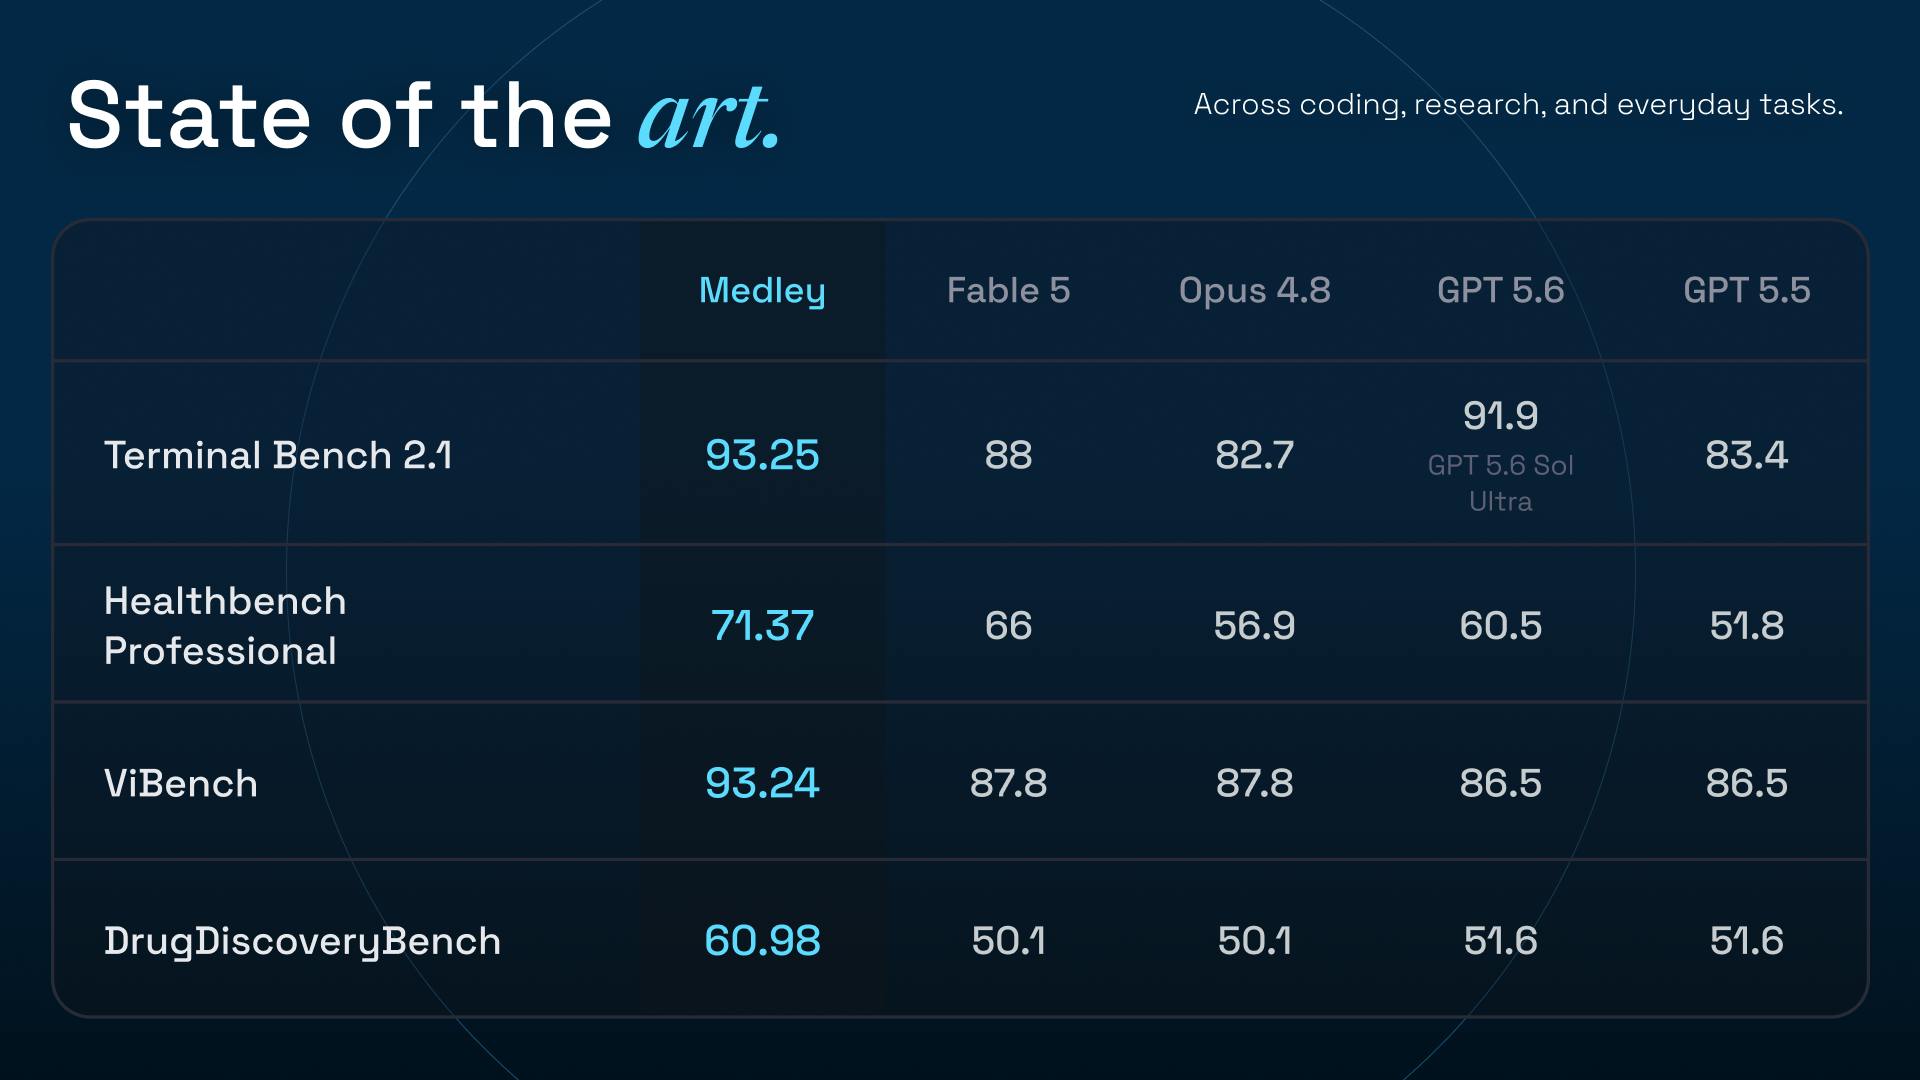
上线前,我们在四个完整的公共基准测试上对同一个架构的"基准专用版"做了压力测试。Medley 在 Terminal-Bench 2.1 上得了 93.25%,HealthBench Professional 上71.37%,ViBench 上93.24%,DrugDiscoveryBench 上60.98%——这是我们在每个基准上找到的最高报告结果。
这覆盖了编程、医疗和药物发现。
没有新的基础模型。这些提升来自于工作如何被分解、路由、跨上下文传递以及审查。
Medley 在 Mac 上免费使用。Mission 从 Claude Code 开始,Medley 可以协调 Claude Code 和 Codex workers。它使用你现有的订阅或 API 访问;配合你自己的 OpenRouter key,你可以通过 Codex 运行 Kimi 和 GLM 等模型。
最酷的时刻之一是,我们意识到只要在同一个 repo 里放一个 skill,Medley 就能开始自我测试和改进。我扔给它整个功能,它就把工作拆解、执行任务、测试实现,然后自己持续推进。大多数时候,只有在真正需要我的输入时它才会回来找我。
我最喜欢的是它非常容易引导。我不需要一直编排所有事情,而是可以只跳进需要我关注的部分,其余的都交给 Medley。这让构建 Medley 更快、更顺,老实说也更有趣。
我们构建 Medley 是因为在 coding agent 上不断撞到同一堵墙:一旦工作跨越多个 session,我们就变成了编排者——拆分任务、在 agent 之间传递上下文、审查输出、决定下一步做什么。
/mission 就承担了这个编排工作。
告诉 Medley 你想要的结果、预算和约束条件。它会规划工作、协调 Claude Code 和 Codex workers、审查结果、然后继续推进。任何需要你判断或审批的事情都会出现在 attention queue 里。
上线前,我们在四个公开基准测试上对 Medley 做了压力测试。它在所有四个基准上都达到了新的最优水平——从编程到医疗和药物发现。
Mission 从 Claude Code 开始。Medley 可以协调 Claude Code 和 Codex workers。配合你自己的 OpenRouter key,Codex workers 也可以运行 Kimi 和 GLM 等模型。
我们很期待看到大家会交给它什么任务。告诉我们你最先尝试了什么、哪里好用、哪里会出问题。
今天我们要发布 /mission,一个免费的 Claude Code 插件,用于处理比单个 agent session 更大的工作。
一旦工作超出了单次 session 的范围,你就得变成那个"缰绳":把任务拆成提示、传递上下文、审查输出、决定下一步做什么。
输入 /mission,告诉 Medley 你想要的结果、预算和约束条件。它会构建一个实时的依赖图,协调 Claude Code 和 Codex workers,审查组装好的结果,并在执行过程中发现更多工作时继续推进。
你可以在浏览器中观察和引导整个 mission。任何需要你判断或审批的事情都会出现在 attention queue 里;其他一切自动推进。
上线前,我们在四个完整的公共基准测试上对同一个架构的"基准专用版"做了压力测试。Medley 在 Terminal-Bench 2.1 上得了 93.25%,HealthBench Professional 上71.37%,ViBench 上93.24%,DrugDiscoveryBench 上60.98%——这是我们在每个基准上找到的最高报告结果。
这覆盖了编程、医疗和药物发现。
没有新的基础模型。这些提升来自于工作如何被分解、路由、跨上下文传递以及审查。
Medley 在 Mac 上免费使用。Mission 从 Claude Code 开始,Medley 可以协调 Claude Code 和 Codex workers。它使用你现有的订阅或 API 访问;配合你自己的 OpenRouter key,你可以通过 Codex 运行 Kimi 和 GLM 等模型。
从 Claude Code 安装:
/plugin marketplace add Spine-AI/medley
/plugin install medley
/reload-plugins
然后运行:
/mission
在你通常需要跨 session 拆分的最大任务上试试。我们很想听听哪里好用、哪里会出问题、你接下来会交给它什么。
作为团队里的增长成员,这已经成了我工作流程中不可或缺的一部分 👏