Llama Windows 面向 Windows 用户的本地 AI 服务器,一键下载模型并通过 OpenAI 兼容 API 供各类应用共享使用。 热门评论 PH 用户大家好!llama.cpp 团队和 @Hugging Face 把 Llama 带到了 Win 11。它常驻系统托盘,会推荐适合你 PC 的模型,并负责替你运行 llama.cpp。按 Alt+Space 就能随时随地与本地模型聊天。其他应用也能用它。把编码智能体、编辑器或脚本指向 localhost:9931/v1,它们就会共用同一个本地兼容 OpenAI 的服务器。模型会留在常用的 Hugging Face 缓存中,所以你不必为每个应用单独下载 20GB。不用终端、不用管理员权限,也不走云端推理。免费且开源!PH 用户共享模型缓存是最让我眼前一亮的部分——让编码智能体、编辑器和脚本指向同一个本地兼容 OpenAI 的服务器,而不是每个应用各自下载 20GB 模型,这是实实在在的体验提升。当两个应用同时请求不同模型时,它怎么处理——是把模型换进换出,还是让两个模型都保持加载?PH 用户很喜欢这一点:一个共享本地服务器意味着每个应用都复用同一份模型缓存,而不是每个应用都自带一份 20GB 下载。PH 用户在 Windows 上本地运行 Llama,让 AI 任务不再依赖云端 API。隐私优先、没有 token 限制,而且能完全掌控自己的模型。非常适合处理敏感数据、或离线跑推理密集型工作流的团队。本地服务器这套方式,比零散分布的客户端 LLM 封装干净多了。 热门产品Morgan Funtowicz2026-10-25原文 打开互动版
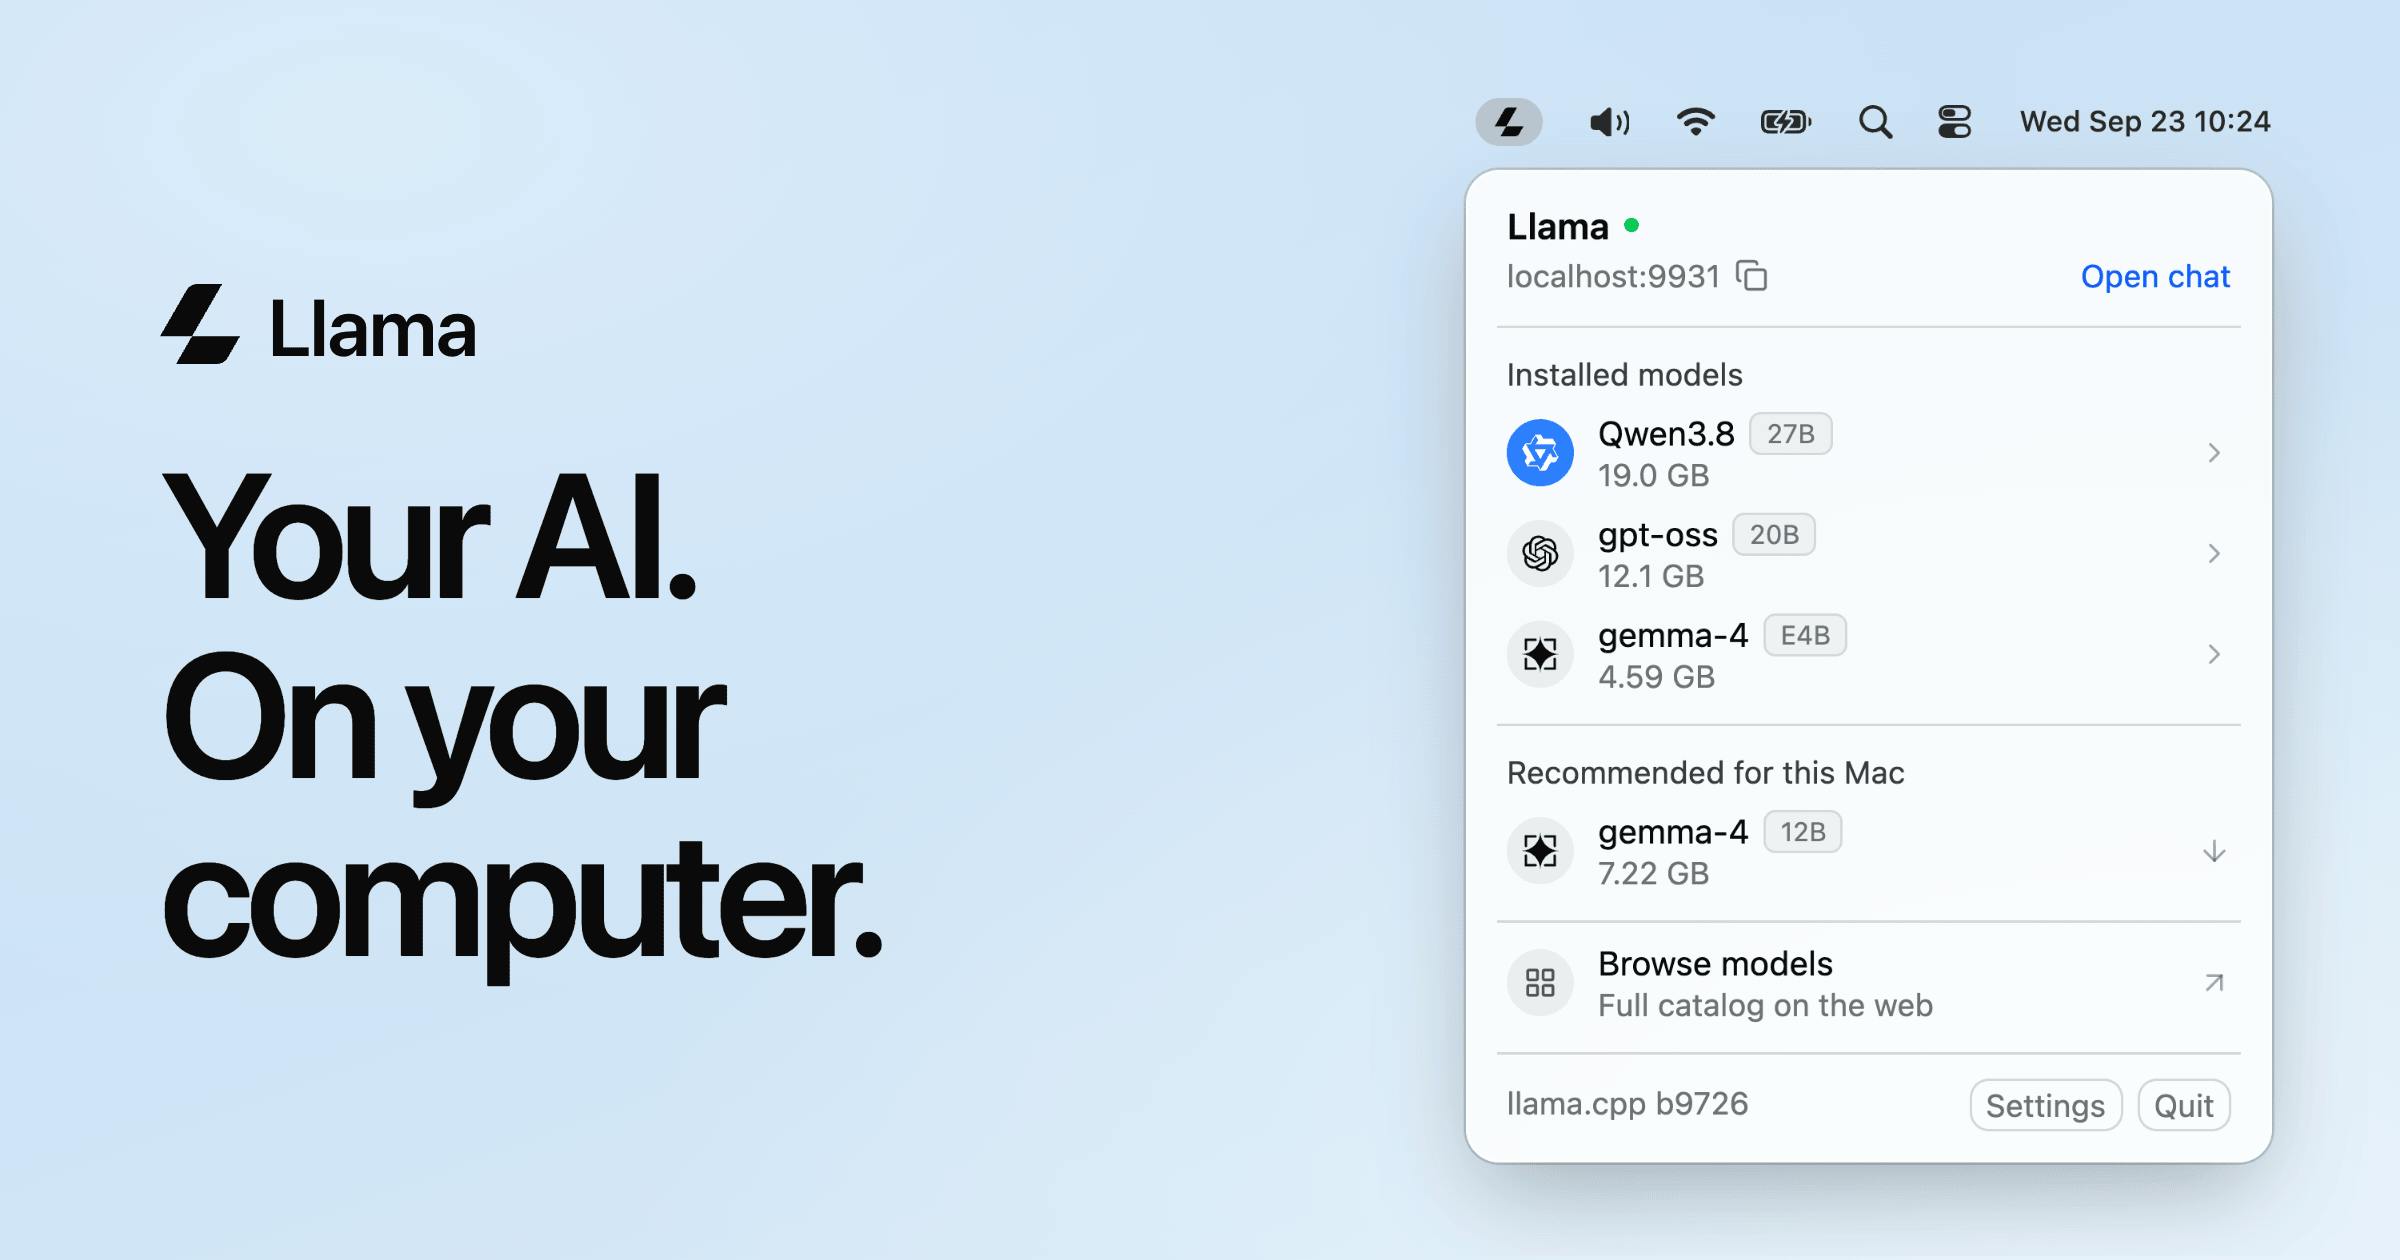
llama.cpp 团队和 @Hugging Face 把 Llama 带到了 Win 11。它常驻系统托盘,会推荐适合你 PC 的模型,并负责替你运行 llama.cpp。
按 Alt+Space 就能随时随地与本地模型聊天。
其他应用也能用它。把编码智能体、编辑器或脚本指向 localhost:9931/v1,它们就会共用同一个本地兼容 OpenAI 的服务器。模型会留在常用的 Hugging Face 缓存中,所以你不必为每个应用单独下载 20GB。
不用终端、不用管理员权限,也不走云端推理。免费且开源!