Cekura Bench Cekura Bench 是语音 AI 基准测试平台,用 82 个真实电话场景评测九款实时语音模型作为电话客服智能体的可靠性、准确率与成本,供语音 AI 开发者选型参考。 热门评论 PH 用户大家好,我是来自 Cekura 的 Sidhant。今天我们发布我们的语音到语音 benchmark。我们在同一个开源的 Pipecat 电话智能体里,以相同的 prompt、工具和电话线路,把 9 个实时语音模型作为完整智能体跑了一遍。每个模型都处理了诊所预约流程和 Medicare 入组流程中的 82 个场景,每个场景跑三次。一通电话只有在智能体得到正确结果、并且每个字段都保存正确时才算通过。结果:最可靠:GPT Realtime 2.1,79.3% 的场景在三次运行中都通过最快:Phonic v1,响应时间中位数 1.60 秒成本最低:GPT Realtime 2.1 Mini,每分钟 $0.020一个 cascade baseline(Flux、GPT-4.1、ElevenLabs Flash)得分 82.9%,高于所有实时模型每通电话都链接到对应的 transcript、工具调用和得分,智能体和测试用例都在 GitHub 上。我们很重视你的反馈,尤其是接下来我们该加入哪些模型。PH 用户很高兴看到这个上线了,超级有用..PH 用户语音领域最全面的 benchmark,而且遥遥领先。👏PH 用户每个 speech-to-speech 模型在 demo 里听起来都很棒,所以我们让它们都打同样的真实电话,进行真实的工具调用,并对实际发生的结果打分。很期待看到新模型发布后排名会怎么变 🚀PH 用户结果真的很有意思 👀 cascade baseline 打败所有实时模型,这绝对出乎我的意料。很期待看到社区的反馈——以及我们接下来该把哪些模型拿来跑这个。PH 用户能实际量化语音 AI 的爆发式增长,真让人兴奋 🚀 热门产品Dharamveer Singh2026-10-08原文 打开互动版
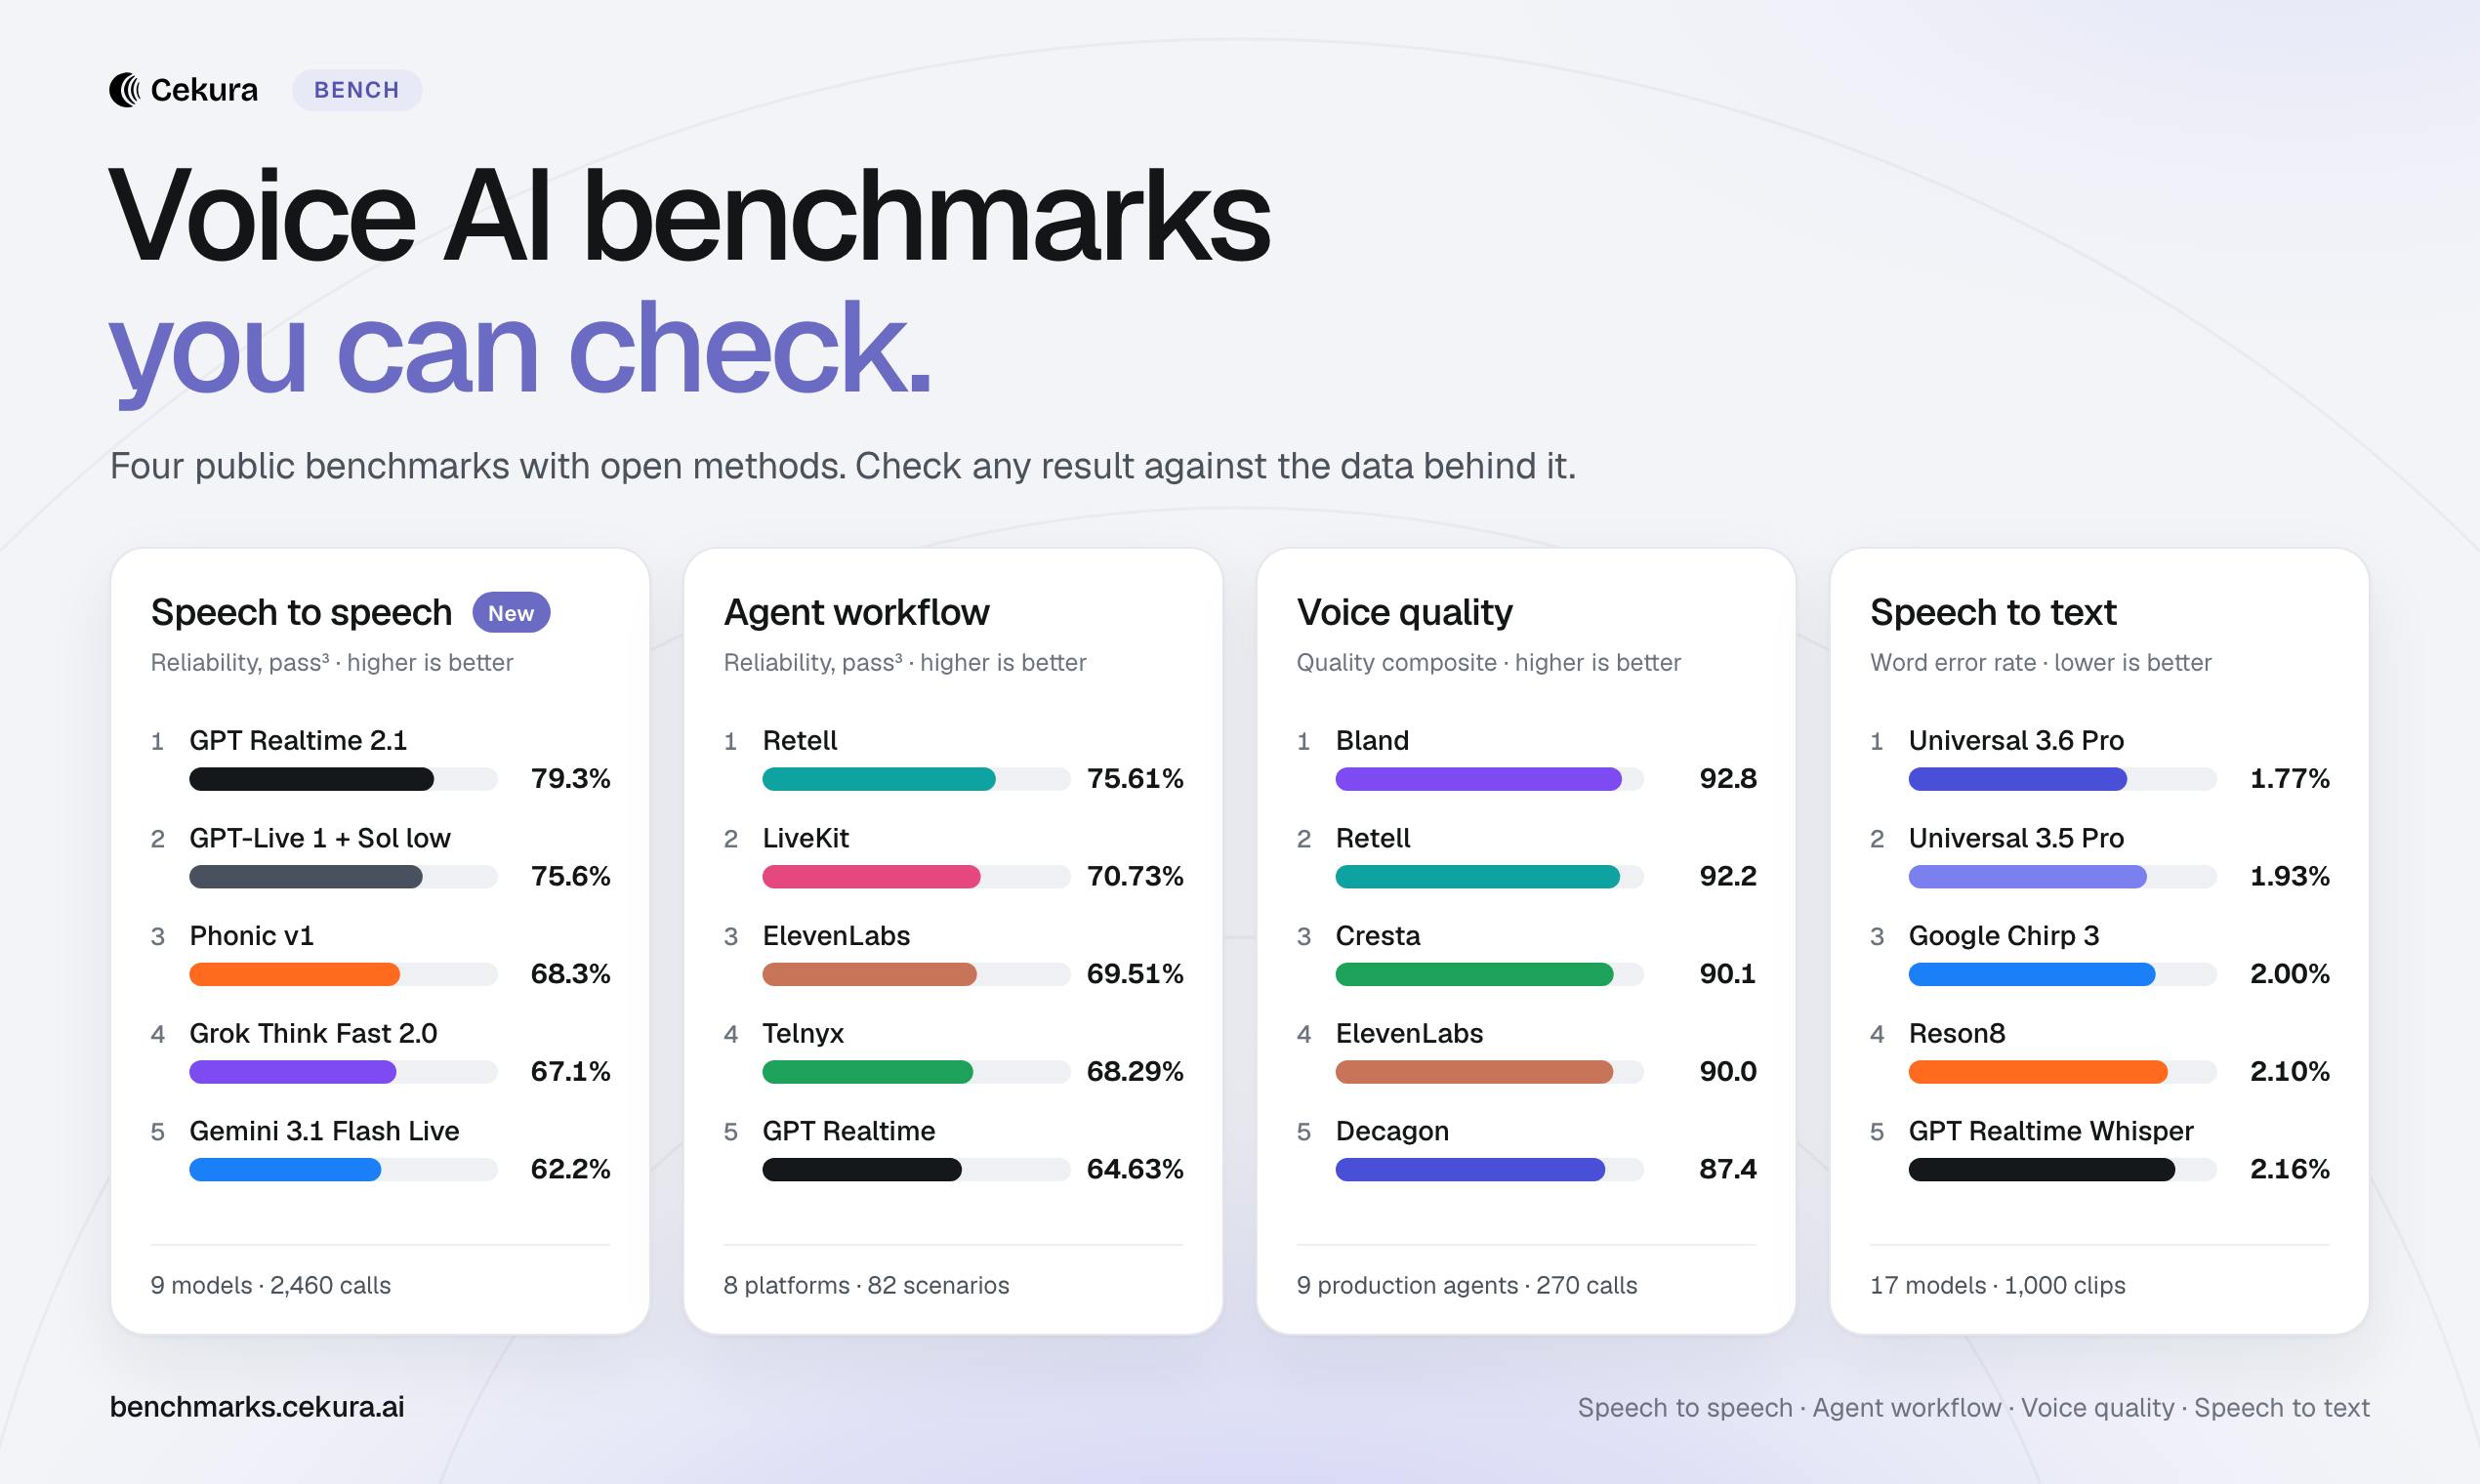
今天我们发布我们的语音到语音 benchmark。我们在同一个开源的 Pipecat 电话智能体里,以相同的 prompt、工具和电话线路,把 9 个实时语音模型作为完整智能体跑了一遍。每个模型都处理了诊所预约流程和 Medicare 入组流程中的 82 个场景,每个场景跑三次。一通电话只有在智能体得到正确结果、并且每个字段都保存正确时才算通过。
结果:
最可靠:GPT Realtime 2.1,79.3% 的场景在三次运行中都通过
最快:Phonic v1,响应时间中位数 1.60 秒
成本最低:GPT Realtime 2.1 Mini,每分钟 $0.020
一个 cascade baseline(Flux、GPT-4.1、ElevenLabs Flash)得分 82.9%,高于所有实时模型
每通电话都链接到对应的 transcript、工具调用和得分,智能体和测试用例都在 GitHub 上。
我们很重视你的反馈,尤其是接下来我们该加入哪些模型。
很期待看到社区的反馈——以及我们接下来该把哪些模型拿来跑这个。