Salt++: 面向少步流式多模态生成的上下文对齐后训练
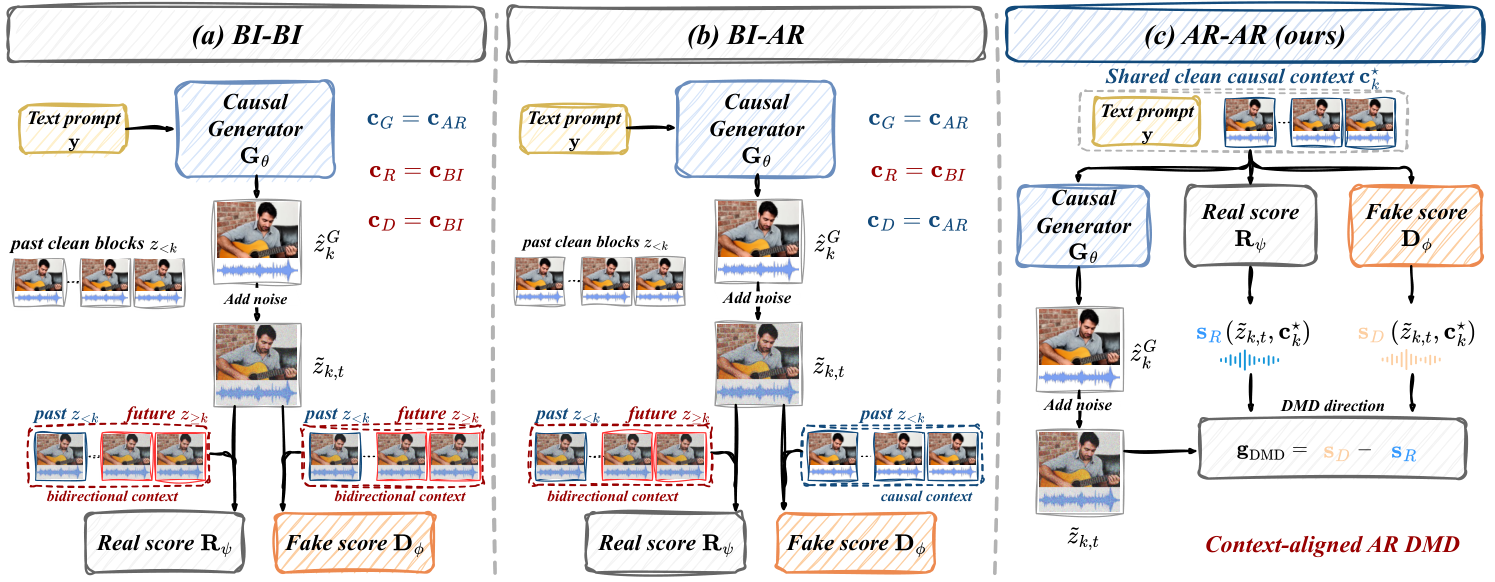
少步流式音视频生成 需同时具备因果建模与步数蒸馏,但标准训练方案面临两个上下文相关的挑战: 1. Teacher forcing 用干净历史配对带噪目标,却只能通过速度预测间接监督预测性上下文表示; 2. 在因果 DMD(分布匹配蒸馏)中直接复用双向 score 模型,会造成生成与评分上下文的不匹配。 我们提出 Salt++,一个两阶段后训练框架:Causal Self-Flow (CSF) 与 context-aligned AR DMD。CSF 利用上下文信息不对称性——固定带噪目标、变化历史,让噪声混合历史的 student 将中间表示对齐到干净历史的 EMA teacher,从而鼓励语义提取并改善跨模态对齐。Context-aligned AR DMD 在生成器采样、fake-score 训练与 real-score 评测间共享因果掩码与前缀,在块条件 KL 目标下匹配生成与参考分布;配合校准的 teacher guidance,它先做干净前缀少步蒸馏,再适应生成历史,无需切换目标或额外 consistency distillation。 在 480p 的相同 4 步因果设定下,Salt++ 在 JavisBench 上较 OmniForcing 将视觉与运动质量分别提升 57% 与 45%。另一 scale-wise 后训练阶段把 Salt++ 扩展到 4 步 1664×960 生成,在七项指标中的六项超过双向 LTX-2。项目主页:https://xingtongge.github.io/Saltpp
论文精读
TL;DR Salt++ 用 Causal Self-Flow 和上下文对齐 AR DMD 解决 few-step 流式音视频生成的上下文不匹配,在 4-step 480p 下视觉/运动质量提升 57%/45%,并支持 1664×960 生成。
问题
问题背景
少步流式音视频生成需要在 因果建模 与 步骤蒸馏 之间取得平衡,是实时多模态生成的核心方向。
现有方法局限
- Teacher forcing 将干净历史与噪声目标配对,但仅通过速度预测间接监督上下文表示,模型没有被显式训练去利用历史中的语义信息,导致跨模态对齐不足。
- 在 DMD 中直接复用双向 score 模型用于因果生成,造成生成上下文与评分上下文不一致:生成器用因果掩码采样,而 fake/real score 用双向上下文评估,分布不匹配。
- 为缓解该不匹配,现有方案常需额外的 一致性蒸馏 或切换训练目标,流程复杂,且难以在少步设置下保持时序一致性与运动质量。
为什么难/重要
流式生成要求逐块输出,因果掩码限制了可利用的未来信息,但少步蒸馏又需要准确的分布匹配信号。上下文错位会直接导致时序抖动、音画不同步、运动退化。业界对实时交互式视频生成、低延迟语音驱动数字人等应用需求强烈,因此该问题具有高工程价值。
行业类比
类似实时语音合成中,需要将自回归 WaveRNN 蒸馏至少数步骤同时保持条件上下文一致,任何上下文错位都会产生可闻伪影。
核心洞察
- Causal Self-Flow 通过变化历史噪声而固定目标噪声,迫使噪声混合历史的学生模型与干净历史教师模型对齐中间表征,将上下文建模从间接监督转化为直接自监督信号。这一角度独特在对比标准 teacher forcing:后者仅通过速度预测损失隐式约束上下文,缺乏对上下文表征本身的显式监督;CSF 则对表征施加匹配损失,直接强化学生从历史中提取语义信息的能力,并提升跨模态对齐,尤其适合流式多模态生成。
- Context-aligned AR DMD 在生成器采样、假评分训练和真评分评估三个环节共享相同的因果掩码与前缀,消除直接复用双向评分模型导致的生成与评分上下文不匹配。其独特性在于:传统因果 DMD 往往需要独立的评分模型适配或一致性蒸馏来处理上下文差异,而本方法通过单一目标(块条件 KL)和共享上下文,让蒸馏从干净前缀无缝过渡到生成历史,无需切换损失或训练阶段,显著简化 few-step 流式生成的后训练流程。
方法
输入与目标
Salt++ 面向 few-step streaming audio–video generation,输入为预训练的音视频生成基础模型,需要同时具备 causal modeling(流式因果建模)与 step distillation(少步采样蒸馏)能力。
关键模块 1: Causal Self-Flow (CSF)
CSF 针对 teacher forcing 中间接监督上下文表征的问题,利用上下文信息不对称性进行自监督对齐。具体做法:
- 保持 noisy target 固定,改变输入历史:学生模型接收 noise-mixed history(混入噪声的历史),教师模型接收 clean history(干净历史),教师为 EMA 版本。
- 学生将中间表征与教师对齐,从而强制模型从带噪声的历史中提取语义信息,提升跨模态对齐质量。
关键模块 2: Context-Aligned AR DMD
标准 Distribution Matching Distillation (DMD) 直接复用双向 score model 会导致 generation context 与 scoring context 不匹配。Salt++ 的 context-aligned autoregressive DMD 通过共享 causal mask 和 prefix 解决该问题:
- generator sampling、fake-score training、real-score evaluation 三个阶段使用同一上下文。
- 采用 block-conditional KL objective 匹配生成分布与参考分布。
- 使用 calibrated teacher guidance,先进行 clean-prefix few-step distillation,再无缝适应 generated histories,无需切换训练目标或额外的一致性蒸馏。
输出与结果
最终得到支持 4-step causal sampling 的流式多模态生成模型。在 480p 下相比 OmniForcing 提升视觉质量 57%、运动质量 45%;通过 scale-wise post-training 扩展到 4-step 1664×960 生成,在七个指标中有六个超过双向 LTX-2。
与同类方法差异
Salt++ 的关键差异在于通过共享上下文 + 单一目标同时完成蒸馏与在线适应,避免依赖独立的 consistency distillation 或强制切换目标。
实验
实验设计
- 在 JavisBench 上以 4-step 因果生成设置,对比基线 OmniForcing,评估视觉与运动质量。
- 通过 scale-wise post-training 扩展至 1664×960 高分辨率,与双向 LTX-2 在 7 个指标上比较。
关键发现
- Salt++ 在相同 4-step causal 设置下,视觉质量提升 57%,运动质量提升 45%(相对 OmniForcing)。
- 高分辨率版本在 7 个报告指标中 6 个优于 双向 LTX-2,展现出单向因果模型的竞争力。
对比解读
- 相比 OmniForcing,Salt++ 的 Causal Self-Flow 和 context-aligned AR DMD 有效解决了上下文不匹配问题,使得生成更干净且时序更稳定。
- 与双向 LTX-2 的对比表明,即使不使用双向注意力,Salt++ 通过上下文对齐的策略也能达到或超越双向模型的性能,这为流式生成提供了更高效的方案。
行业影响
落地场景
Salt++ 面向少步流式音视频生成,适用于需要低延迟、因果推理的实时场景。典型落地包括:
- 电商直播 / 虚拟试穿:实时生成商品演示视频或虚拟主播口播,减少预渲染成本。
- 内容平台短视频工具:基于文本 prompt 快速生成 4 步 480p 视频,支持流式预览,提升创作者效率。
- 交互式教育 / 游戏:动态生成教学演示或游戏过场动画,响应玩家输入。
商业价值
核心价值在降本 与 体验提升。相比传统多步扩散,Salt++ 在 4 步因果设置下将视觉与运动质量较 OmniForcing 提升 57% 和 45%,同时保持流式生成能力,可显著降低 GPU 推理延迟与算力成本;高分辨率 1664×960 输出能力进一步满足商用素材规格。对实时产品而言,更少步数意味着更高并发与更低单位成本,直接改善毛利率。
与现有产品/工作流的接口
Salt++ 作为后训练框架,可直接作用于已有 bidirectional score 模型,将其转换为 causal streaming 模型,无需从头预训练。集成路径分两步:
- 用 Causal Self-Flow 对现有模型做自监督微调,提升上下文表示;
- 用 context-aligned AR DMD 进行少步蒸馏,共享因果掩码与 prefix,避免额外 consistency distillation。
工程上可复用现有推理栈,只需替换权重与采样逻辑,适合快速上线到视频生成 API、云端渲染服务或边缘设备。项目提供 GitHub 与 项目主页 供集成参考。
局限
- Salt++ 作为后训练框架,依赖预训练的音视频生成模型,且 **Causal Self-Flow (CSF)** 需要同时维护一个 clean-history EMA 教师模型进行表示对齐,训练复杂度和显存开销显著增加。**Context-aligned AR DMD** 要求生成与评分阶段共享因果 mask 和 prefix,这可能限制了模型在非因果或更长序列场景的泛化能力。论文未讨论基础模型因果建模能力不足时 Salt++ 的提升幅度,也未给出计算资源消耗,工程落地前需要额外验证。
- 实验仅在 480p 和 1664×960 两个分辨率下进行,基线对比范围较窄,主要与 OmniForcing 和 LTX-2 相比,缺少对其他近期 few-step 或 consistency 蒸馏方法的横向比较。高分辨率扩展需要独立的 scale-wise 后训练阶段,增加了训练流水线的复杂度。论文未报告显存、训练时长等部署相关指标,难以评估实际工程成本。
- 评测集中于视觉质量、运动质量和 DeSync 等指标,未深入分析长序列 streaming 生成中的误差累积、音频-视频同步延迟以及语义保持能力。论文展示的生成样本长度有限,无法验证模型在持续流式输出时的稳定性。此外,CSF 的自监督信号设计可能偏向低噪声水平场景,对高噪声或极端条件下的鲁棒性尚不明确。