气候政策因果评估中识别假设的证据锚定审计
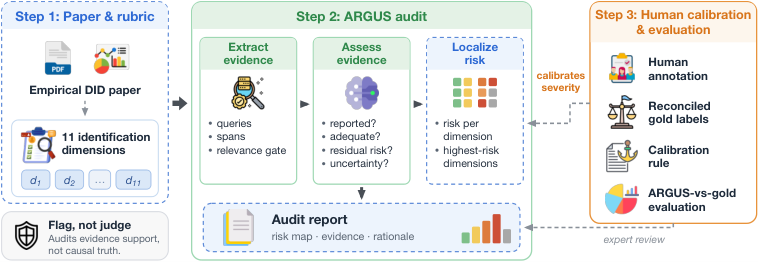
双重差分(DID) 研究被广泛用于评估气候政策,但评估支持其 识别假设 的证据仍具挑战。我们提出 ARGUS,一个结构化的语言模型流水线,依据十一维的 假设–含义–证据 评分标准审计报告中呈现的证据,并在无法检索到相关证据时 弃权。 我们用注入缺陷、经济学论文以及带有一致化标注的小规模试点来评估 ARGUS。在 11 类缺陷基准 上,ARGUS 检出 73% 的人为植入缺陷,而基于关键词的流水线仅为 18%。在 26 篇经济学论文上,ARGUS 因缺乏可检索证据,在约 40% 的论文–维度评估中弃权。 在由两位标注者一致化标签的五篇论文试点中,在它完成的 33 项评估里有 25 项给出的风险等级高于标签。在标签到达之前预先固定的规则可在样本内消除其中大部分差异,但 加权一致性 仍然偏低。 ARGUS 提供 证据关联的风险报告,定位潜在弱点以供专家审查,而不对因果主张作出裁决。代码与数据:https://github.com/yonghongzhang-io/ARGUS
论文精读
TL;DR ARGUS 用结构化 LLM 流程对气候政策 DID 因果评估中的识别假设进行证据锚定审计,按 11 维细则评估并检索不到证据时弃权,将注入缺陷检出率从 18% 提升至 73%。
问题
问题背景
差异中差异(DID)是气候政策因果评估的主流方法,但其核心识别假设(如平行趋势、无溢出效应)通常只在论文中报告有限证据,难以系统核验。
现有方法局限
当前审计主要依赖人工阅读或基于关键词的检测流水线。人工方式不可规模化,且主观性较强;关键词流水线只能捕捉预设术语,无法理解语义或识别commission flaws(作者声称支持某假设,但证据实际指向相反方向)。例如,一篇论文可能声称“处理组与对照组在干预前趋势相似”,但仅凭“trend”一词出现无法判断是否真的提供了统计检验或图表。此外,现有工具缺乏证据缺失时的弃权机制,容易把“未报告”误判为“不支持”或相反。
为什么这个问题难/重要
气候政策影响面广,错误的因果推断可能直接误导法规制定。技术上,审计需要从完整论文文本中检索分散的、表述迥异的证据,并将其映射到多维度的假设–含义–证据框架,这对语言模型的上下文理解、证据引证和校准能力要求很高。同时,评估审计工具本身也困难:真实论文缺少反事实标签,注入缺陷(flaw injection)需要保证不泄露信号。业界对负责任的 AI 评估体系呼声渐高,审计工具若输出高置信错误结论,风险反而更大。
行业类比
类似检索增强生成(RAG)系统中的证据引用与弃答:不仅要有答案,还必须准确定位来源,无法找到相关证据时应明确回答“不知道”,而不是凭空生成判断。
核心洞察
- ARGUS 的核心创新在于证据接地的审计范式:它不直接判定 DID 识别假设是否成立,而是评估论文报告的证据是否支撑其假设,并在证据缺失时明确弃权。这种设计直接针对 LLM 审计中的过度自信问题。对比关键词基线只能检测遗漏性缺陷(omission flaws),ARGUS 通过结构化的假设-含义-证据映射以及检索门控,在 11 个注入缺陷基准上达到 73% 检测率,远超关键词的 18%,表明其能捕捉错误证据(commission flaws)并有效抑制幻觉。
- 将 LLM 角色限定为有限制条件的管道组件,而非端到端裁判,是 ARGUS 的可追溯性保障。它把识别假设分解为 11 个维度,逐维度检索证据并对照标准,证据不足即弃权,产出可定位具体弱点的风险报告。实际论文中约 40% 的评估弃权,说明真实文献证据覆盖不足;这种诚实报告不确定性的机制,与直接让 LLM 给因果结论的方法形成鲜明对比,更适合辅助专家复核而非替代判断。
方法
方法详解
输入:DID 实证论文文本(正文、表格、附录等)与预定义的十一维 Identification rubric(假设–蕴含–证据框架)。
关键模块:
- 证据检索:从论文中定位与各假设维度相关的证据片段;若无法检索到相关证据,则该维度标记为
abstain(弃权),不进行后续评估。 - Bounded LLM pipeline:限制 LLM 的角色,使其仅依据检索到的证据对照 rubric 判断证据充分性或风险等级,不直接裁决因果结论。管道通过预设提示引导模型输出结构化评估,避免自由发挥。
- 缺陷注入评估:使用结构扰动而非简单哨兵词注入 11 类 planted flaws,并扩展为 33 个变体测试灵敏度;同时对照关键词基线和不同 LLM 的跨模型鲁棒性。
输出:每篇论文在每个维度上的风险评估、证据链接与风险定位;证据不足时输出 abstain,不强行给出等级。最终风险报告供专家复核。
跟同类方法的差异点:ARGUS 不同于关键词匹配或让 LLM 直接判断因果有效性,而是将 LLM 约束在结构化证据对照和弃权机制内,减少无证据时的幻觉式评估,增强审计可追溯性。
实验
实验设计
ARGUS 在三个层面评估:11-flaw benchmark 注入已知缺陷测试检测能力,扩展为 33 个缺陷变体 验证鲁棒性;26 篇经济学论文 的真实语料评估检索覆盖与 abstention;5 篇论文 pilot 由两名标注者调和标签,对比 ARGUS 的风险分级。管道以 假设-隐含-证据 的 11 维 rubric 审计,证据不足时 abstain。
关键发现
在 11-flaw 基准上,ARGUS 检出率 73%,远高于关键词管道的 18%。在 26 篇真实论文上,约 40% 的 paper-dimension 评估因可检索证据不足而 abstain,反映真实文献的证据稀疏。在 5 篇 pilot 的 33 个完成评估中,ARGUS 对 25 个 分配了比人工标签更高的风险水平;预先固定的校准规则能移除大部分 in-sample 偏移,但加权一致性仍低。
与基线对比
关键词管道只对遗漏缺陷敏感,对错误陈述缺陷盲视;LLM 管道通过证据链接提升检出,但引入 abstain 机制换取覆盖率与可信度的平衡。ARGUS 不裁决因果主张,而是定位潜在弱点供专家复核,这一设计降低误判风险,但也限制其作为自动审计工具的决策权重。
行业影响
落地场景
ARGUS 可嵌入企业级因果推理审计流程,适用于电商平台促销活动效果归因、内容平台推荐算法 A/B 实验解读、金融风控政策评估、医疗真实世界证据分析等场景。它不替代因果结论,而是审计识别假设的证据充分性,帮助合规与模型风险团队快速定位薄弱环节。
商业价值
- 降本:自动初审分析报告,减少资深数据科学家的人工复核时间;
- 增收/避损:提高实验结论可靠性,避免错误因果推断导致错误产品决策(如误判活动收益);
- 体验/信任:输出证据链风险报告,提升跨团队(数据、风控、法务)协作效率。
与现有产品/工作流的接口
- 将 ARGUS 作为轻量审计微服务,接入实验平台(如 MLflow、W&B)或报告系统,对
DID/ 准实验分析自动生成风险标注与证据摘要。 - 输出结构化 JSON 报告对接 CI/CD 流程,对无法取证的假设维度设置阻断或人工复核。
- 与企业检索库结合,用内部文档与历史实验补充证据,降低 abstain 率;核心审计规则由专家维护,保持可解释与可控。
具体场景:电商平台评估新促销策略对 GMV 的因果效应时,ARGUS 可审计平行趋势假设、时间不变混淆等维度的报告证据,标记缺失项;内容平台评估新推荐策略时,识别安慰剂检验与外部有效性证据缺陷。
局限
- **覆盖率受限于检索证据**:ARGUS 在 26 篇经济学论文上对约 40% 的论文-维度评估因无法检索到相关证据而弃权。这意味着对于很多识别假设维度,系统无法给出任何风险判断,实际审计范围缩小。尤其当原论文报告不完整或使用非结构化证据时,弃权比例可能更高,导致整体审计结果碎片化,难以支撑完整的因果评估可靠性结论。与理想中的全自动审计相比,这要求专家补查大量维度,自动化价值打折扣。
- **与人工金标准的一致性存疑**:在五篇论文的试点标注中,ARGUS 在它完成的 33 项评估中给 25 项打出了高于人工标签的风险水平;虽然预先制定的校准规则能在样本内消除大部分偏差,但加权一致率仍低。说明模型倾向于高估风险,可能产生大量假阳性,增加审稿负担。而且校准规则是在标签到达前固定、但在同一样本上调整,样本外泛化未经验证,可能过拟合特定标注者偏好。
- **基准评估与真实任务的差距**:注入缺陷基准上 ARGUS 检测率 73%,仍漏掉 27% 的植入缺陷;这些缺陷是结构性扰动而非文本哨兵,但注入方式与真实论文中的微妙论证瑕疵仍有差异。此外,实验仅覆盖 DID 识别假设的 11 个维度,未涉及其他因果推断方法(如断点回归、工具变量)或非气候政策领域,跨方法、跨领域的迁移能力未知,可能限制其在更广泛经济学实证研究审计中的适用性。