EvoOntology:面向 Data Agents 的自演化本体层
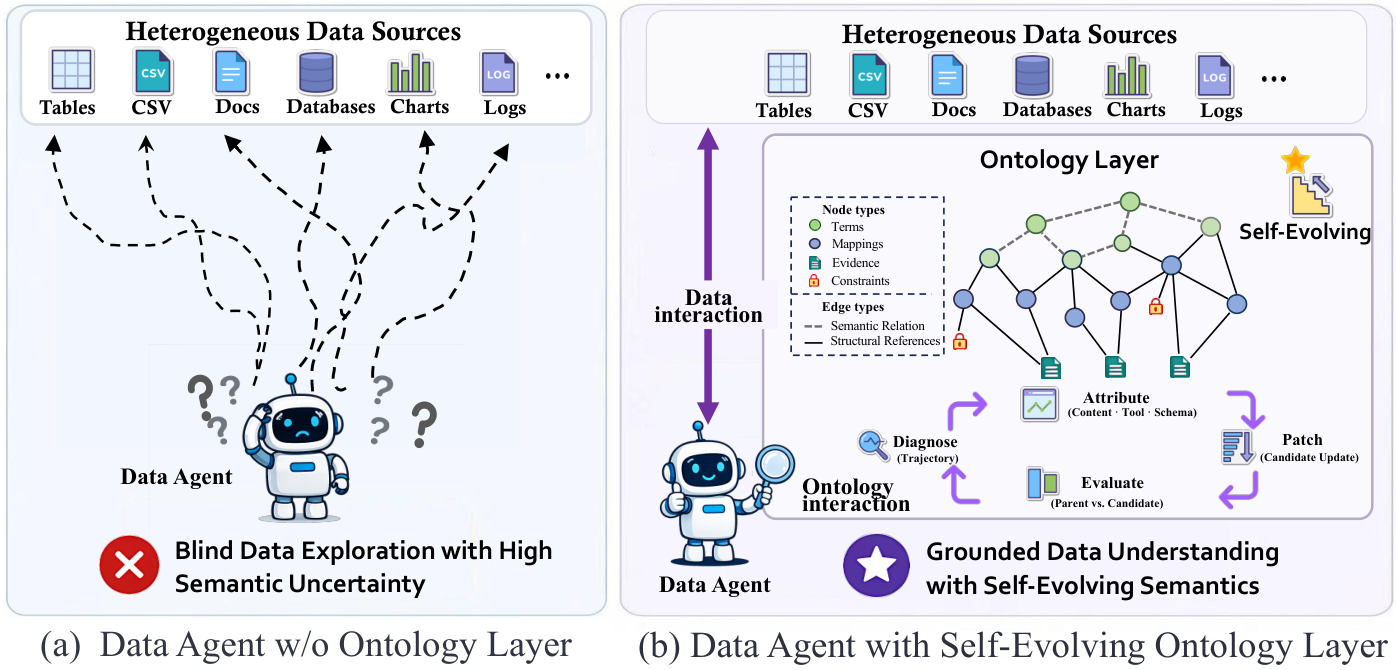
Data agents 的目标是根据自然语言指令,对表格、文件、数据库等异构数据执行任务。然而它们面临着棘手的 agent-data gap:异构数据位于 agent 外部,而 agent 只能通过通用工具访问其中的少量信息(如列名、文件路径)。现有方法要么让 agent 直接探索原始数据源,要么把人工构建的语义层注入 prompt,但两者都难以扩展到大规模异构数据源,也无法适应不同的 agent 行为。 为此,本文提出 EvoOntology,一个面向 data agents 的自演化本体层。它将本体封装为一个 MCP server,由 schema layer、content layer 与 tool layer 三层构成,使 agent 能在运行时主动查询并与本体交互。为支撑这一设计,作者引入了用于自主构建本体的 builder agent,以及一个自演化循环:通过归因引导的类型化编辑持续精修本体,且只有当 backbone-conditional 配对评估通过后,编辑才会被接受。 在三个广泛采用的 data-agent benchmark 与四种 LLM backbone 上的实验表明,EvoOntology 稳定优于强基线以及既有语义层方法,有效弥合了 agent-data gap,使 agent 与异构数据的交互更为高效。代码见 https://github.com/ruc-datalab/EvoOntology。
论文精读
TL;DR 将 **自演化本体层** 封装为 **MCP server**(`schema` / `content` / `tool` 三层),支持 data agent 运行时查询;通过 **归因引导类型化编辑** 与 **骨干条件配对评估** 持续进化,在 3 个基准 4 个 LLM 上超越现有语义层方法。
问题
问题背景
数据代理(data agents)需要基于自然语言指令操作异构数据源(表、文件、数据库等),当前研究集中在提升 LLM 工具调用与跨源推理能力。
现有方法局限
主流方案存在两难:
- 直接探索原始数据源让 agent 通过
list_columns、sample_rows等工具自行理解 schema,但面对大规模异构源时,探索成本随数据规模线性膨胀,且容易受列名歧义(如card可指信用卡或纸牌)误导,引发错误路由。 - 注入人工构建语义层(semantic layer)通过预定义 ontology 或 metric 定义降低歧义,但构建高度依赖专家对数据语义与下游 agent 行为的匹配,难以覆盖频繁变更的数据 schema,且不同 LLM backbone 对同一语义层的利用偏好差异大,静态语义层无法自适应。
为什么这个问题难/重要
核心难点在于 agent–data gap 的动态性与强耦合:
- 数据 schema 与内容随时间演化,人工标注语义层会快速过期;
- agent 的行为模式(查询顺序、工具偏好)受 backbone 影响,语义层需要能够主动响应 agent 的交互轨迹;
- 大规模数据场景下,构建与维护语义层不能以牺牲运行时延迟或引入过度 token 开销为代价。
业界对
Text-to-SQL、Text-to-API及企业级数据目录的智能化需求强烈,该问题直接制约数据代理在生产环境的落地。
行业类比
类似 RAG 系统中知识图谱索引需要根据检索反馈持续更新节点与关系,数据代理也需要一个能随使用反馈自我演化的语义中间层,而非静态 schema 字典。
核心洞察
- 将本体层封装为 **MCP 服务器**(schema / content / tool 三层)实现运行时主动查询,而非静态注入 prompt。这允许数据代理按需获取列名、文件路径等细节,避免了传统语义层在面对大规模异构数据时 prompt 过长、无法扩展的问题,同时让本体可以适配不同代理的调用行为,减少无效工具调用。
- **自进化闭环**采用归因引导的类型化编辑与骨干条件配对评估:通过轨迹归因定位本体中需要修改的节点,应用增删改等类型化操作,再用多个 LLM 骨干做对比评估决定是否接受编辑。这防止本体过拟合单一模型,类似 RLHF 的对比评估思想,但针对结构化本体而非文本输出,使本体跨 4 种 LLM 骨干持续有效。
- **Builder agent 自动构建初始本体**,从原始异构数据证据(如列名、文件内容)生成本体,摆脱手工构造语义层的依赖。相比直接探索原始数据的方法,它提供了结构化、可解释的知识层;相比人工语义层,它能扩展到大规模数据源并支持后续进化。
方法
输入与目标
EvoOntology 处理的核心输入是异构数据源(表、文件、数据库)与自然语言任务。数据存在于 agent 外部,agent 只能通过 generic tools 访问列名、文件路径等原始元数据,形成 agent–data gap。
关键模块
Ontology-as-MCP-Server 架构:将 ontology 封装为 MCP server,内部包含三层:
- schema layer:结构化的 schema 信息。
- content layer:数据内容语义,如取值分布、业务规则。
- tool layer:可被 agent 调用的交互工具,使 agent 在运行时主动查询 ontology,而非一次性注入 prompt。
Builder Agent(证据驱动的初始化):通过 evidence-grounded ontology initialization,builder agent 自主扫描数据源,抽取实体、属性、关系,构建初始 ontology。该过程利用 LLM 对数据样本进行推理,将原始 schema 与内容转化为机器可理解的语义描述。
Self-Evolution Loop(轨迹驱动的演化):在任务执行后,系统记录 agent 的交互轨迹,基于 attribution 定位 ontology 中需要修改的层级(schema/content/tool),生成 typed edits(类型化编辑,如添加属性、修正关系)。每个编辑必须通过 backbone-conditional paired evaluation:即对比同一 backbone 下编辑前后的任务效果,只有提升才被接受,避免无效更新。
输出
输出是一个持续演化的 ontology 层,数据代理可将其作为外部语义服务动态查询,从而在大型异构数据上获得稳定、适应的语义支撑。
与直接探索原始数据或人工注入静态语义层不同,EvoOntology 将 ontology 变成可交互、可自进化的服务,随 agent 行为与数据分布同步调整。
实验
实验设计
- 在三个数据智能体基准(覆盖表格、数据库、文件等异构数据)上评估
- 使用四个 LLM 骨干作为基座,对比 直接探索原始数据 和 手动构建语义层 两类基线
- 评估指标为任务成功率(原文未提供具体数值)
关键发现
- EvoOntology 在所有数据集和所有骨干上均稳定超越强基线,且相比现有语义层方法优势明显
- 自进化循环通过 归因引导的类型化编辑 和 骨干条件配对评估 持续提升本体质量,迭代后性能进一步改善
- 本体作为 MCP server 提供三层结构(schema / content / tool),使 agent 能够运行时主动查询,而非被动接收静态提示
与基线的深度对比
- 直接探索原始数据源的方法在数据规模大时成本高、信息稀疏,容易误导 agent;EvoOntology 通过可查询的本体层压缩数据空间,降低 agent 探索负担
- 手动构建语义层的方法难以适应不同 agent 行为和数据分布变化;EvoOntology 的自进化机制可针对具体骨干与任务动态调整本体,实现 骨干条件 优化,泛化性更强
行业影响
落地场景
EvoOntology 适合任何需要 LLM agent 处理异构数据的企业场景,如企业知识库问答、数据治理与自助分析、多源报表生成。例如电商平台可让运营 agent 跨订单数据库、商品表格和用户评论文件回答“哪些产品最近退货率上升?”,无需手工预定义 schema。内容平台可基于用户行为表、内容元数据和日志文件构建动态语义层,支持个性化推荐分析。
商业价值
主要降本:自动构建本体省去人工维护语义层的大量数据工程工作;自我进化减少模型行为变化带来的失效风险,避免反复重写语义映射。同时提升 agent 准确率,带来体验提升,降低错误决策成本。相比传统 Semantic Layer 产品(如 dbt、Cube),EvoOntology 是 agent-first 且自进化,能随数据变化和 backbone 差异自适应,显著减少运维负担,适合数据源频繁变动或模型迭代较快的团队。
与现有产品/工作流的接口
以 MCP server 形式提供,可直接接入支持 MCP 的 agent 框架(如 Claude、OpenAI、LangChain/CrewAI 等),无需改造数据源。现有数据目录(如 Alation、OpenMetadata)可将其作为智能前端,让 agent 查询本体而非原始 schema。也可作为 RAG 流程中的 metadata store 增强检索。
具体用例:金融投研 agent 集成 EvoOntology 后,跨交易数据库、研报 PDF 和金融指标 Excel 回答问题,本体自动更新公司名称、指标口径变化,减少每次新数据接入时的重新建模。
局限
- **实验覆盖范围有限**。论文仅在三个数据智能体基准上验证,这些基准主要面向表格和关系型数据库任务,对于真实世界中常见的 NoSQL、图数据库、非结构化文档、API 数据源等覆盖不足。此外,实验规模相对较小,缺少对大规模企业级数据湖(数千张表、复杂依赖)的可扩展性分析,因此 EvoOntology 在超大规模异构环境下的性能是否会退化尚不明确。
- **自演化评估存在潜在偏差**。backbone-conditional paired evaluation 使用与生成阶段相同的 LLM 骨干来判定编辑是否接受,这可能导致演化方向偏向该骨干的偏好,削弱跨模型泛化性。论文虽然分析了 divergence across backbones(附录 D),但并未提出消除偏差的机制,也未验证当使用不同 backbone 进行构建和演化时,本体质量是否保持一致。
- **构建与维护成本较高**。EvoOntology 的初始本体构建和每一轮演化都需要大量 LLM 推理调用(包括 builder agent、attribution 分析、paired evaluation),附录 B 虽报告了成本,但在持续运行的生产环境中可能构成显著开销。同时,本体的 MCP server 运行时查询会引入额外延迟,且随着演化轮次增加,本体规模膨胀可能导致查询效率下降,缺少自动裁剪或压缩策略。