ModularRSI: Modular and Generalizable Recursive Harness Self-Improvement
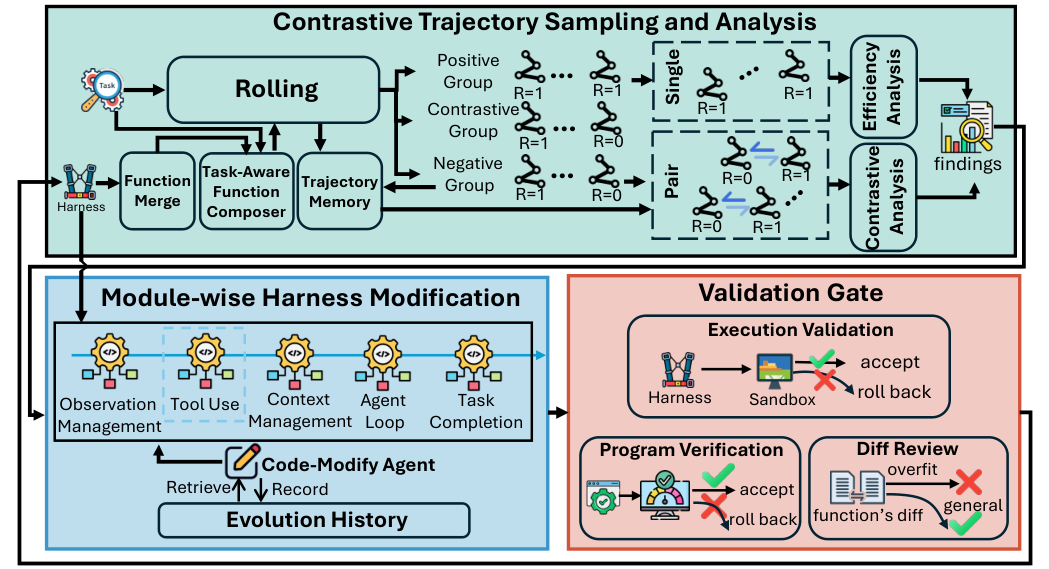
Recent work extends recursive self-improvement (RSI) to agent harnesses for long-horizon coding and terminal tasks, enabling agents to improve execution mechanisms from experience. However, generalizable harness RSI remains challenging. First, evolving harnesses on evaluation benchmarks or their subsets makes it difficult to distinguish reusable improvements from benchmark-specific adaptation. Second, single-trajectory updates can conflate systematic harness deficiencies with instance-specific reasoning and solution details, producing modifications that transfer poorly to unseen tasks. Third, localizing recurring behavioral deficiencies within monolithic harnesses is difficult, while whole-harness optimization can entangle unrelated mechanisms and complicate attribution and validation. We propose ModularRSI, a benchmark-disjoint, contrastive, and modular framework for generalizable harness evolution. ModularRSI contrasts successful and failed trajectories for the same task and aggregates evidence across tasks to identify recurring behavioral deficiencies. It decomposes the evolvable harness into five functional modules: Agent Loop, Tool Use, Observation Management, Context Management, and Task Completion Detection. Each module evolves independently within a restricted modification scope, followed by an integration stage that combines the evolved modules into a unified harness and resolves potential conflicts. To support benchmark-disjoint evolution, we curate 2,000 executable evolution tasks from external sources that are disjoint from downstream evaluation benchmarks. Expe…
论文精读
TL;DR ModularRSI 将 agent harness 拆为五个功能模块,用对比轨迹聚合系统性缺陷并独立演化,避免基准拟合与实例噪声,在外部任务上实现可泛化的递归自改进。
问题
问题背景
近年来,递归自我改进(RSI)被扩展到智能体执行层(agent harness),用于长时程编码和终端任务。harness 是智能体与环境交互的运行时机制,RSI 旨在从历史执行轨迹中自动改进这些机制,提升智能体在未见任务上的稳健性。
现有方法局限
- 直接在评估基准或其子集上做 harness 演化,导致学到基准特定适应,难以区分可复用改进与过拟合;
- 基于单条轨迹的更新会混淆系统性 harness 缺陷与实例特定推理/方案细节,产生无法迁移的修改;
- 单体 harness 难以定位反复出现的行为缺陷,整段优化会纠缠无关模块,归因与验证困难。
为什么这个问题难/重要
harness 是智能体的“执行内核”,其缺陷往往具有跨任务共性,但表现却分散在大量失败轨迹中。需要跨任务对比成功/失败证据来定位系统性问题,同时保持模块边界清晰、修改范围受限。业界对 agent 长期自主运行和自改进有强烈需求,如果 harness 改进不能泛化,RSI 会退化为对训练任务的记忆,失去部署价值。
行业类比
类似于 CI/CD 管道中通过聚合失败日志改进基础设施配置,必须区分环境特定故障与通用管道缺陷,否则修复不可移植。
核心洞察
- 提出 benchmark-disjoint 演化协议,从外部源构建 2000 个可执行任务,与下游评测基准完全不相交。这切断了 harness 改进对特定 benchmark 的过拟合路径,使可重用改进与基准特定适应得以分开评估。对比现有 RSI 直接在目标基准或其子集上演化,ModularRSI 提供了更严格的泛化验证框架,实验表明跨领域任务也获得一致提升。
- 采用对比轨迹采样与跨任务聚合,对同一任务采样成功与失败轨迹,对比差异并聚合多个任务证据,从而识别反复出现的系统性行为缺陷。这克服了单轨迹更新将系统缺陷与实例特定推理细节混淆的问题,使得修改更可能迁移到未见任务。案例研究表明,该方法能定位如“忽视任务要求”“未检查验收条件”等跨任务共性问题。
- 将可演化 harness 分解为五个功能模块(Agent Loop, Tool Use, Observation Management, Context Management, Task Completion Detection),每个模块独立演化且修改范围受限,随后集成并解决冲突。相比整体优化 monolithic harness,模块化使缺陷局部化、修改可归因,避免无关机制纠缠,也便于人工审查和验证。消融实验显示模块化演化优于整体演化。
方法
输入与数据准备
- 演化任务集:2,000 个外部可执行任务,与下游基准 TB2.0 和 SWE-Bench Verified 不相交。
- 在任务上运行 agent 得到成功与失败轨迹对。
关键模块
- Harness 模块化:将整体 harness 分解为 5 个功能模块:
Agent Loop、Tool Use、Observation Management、Context Management、Task Completion Detection。 - 对比轨迹分析:对同一任务的成功/失败轨迹进行对比,聚合跨任务证据,识别重复出现的行为缺陷(如忽略任务要求、错误退出条件等)。
- 模块级修改:每个模块独立在受限范围内演化,针对缺陷生成补丁,避免全局扰动。
- 验证门:修改后通过验证门(在保留任务上评估)确保有效性。
- 跨模块集成:集成演化后的模块,解决冲突,形成统一 harness。
- 函数库管理:维护可复用工具函数,避免重复发明。
输出
改进后的 harness,在未见域内/跨域任务上表现提升,并且可迁移到不同基础模型。
差异点
与现有 RSI 方法相比,ModularRSI 通过基准解耦和模块化对比分析,实现了归因明确、泛化性强的 harness 自改进。
实验
实验设计
论文采用 基准分离 的进化协议:从外部来源收集 2,000 个可执行任务,与下游评估基准 TB2.0 和 SWE-Bench Verified 完全不相交。进化过程对比同一任务的成功与失败轨迹,跨任务聚合证据以识别反复出现的行为缺陷;将 agent harness 分解为五个功能模块(Agent Loop、Tool Use、Observation Management、Context Management、Task Completion Detection),各模块在受限修改范围内独立进化,随后集成并解决冲突。
关键发现
- 在未见过的域内和跨域任务上,进化后的 harness 均取得一致改进,表明改进不是对特定基准的过拟合。
- 进化后的 harness 能够迁移到不同基础模型,说明改进针对执行机制本身,而非特定模型的推理偏差。
- 模块化进化优于整体优化:独立模块修改更容易定位缺陷,集成阶段能有效解决冲突,避免无关机制纠缠。
- 对比分析 能更准确地识别系统性 harness 不足,减少实例特定噪声。
与基线对比解读
现有 RSI 方法常直接在评估基准或其子集上进化,易将基准特化误认为可复用改进;单轨迹更新则混杂实例细节;整体 harness 优化难以归因。ModularRSI 通过基准分离、对比证据聚合与模块化修改同时解决这三个问题,并在跨模型迁移上验证了改进的系统性。与直接优化整个 harness 的基线相比,模块化方法在定位缺陷、控制修改范围、保持模块间独立性方面更具工程可操作性,适合持续演化的 agent 系统。
行业影响
落地场景
ModularRSI 适用于长时程智能体 harness 的自改进,可直接嵌入 AI 编程助手(如自动修复 CI 失败、生成测试)、自动化运维(服务器配置、日志分析)以及 数据管道维护(ETL 异常处理)等产品。
具体 use case:
- 电商平台 的商品信息同步代理,定期爬取供应商数据并更新商品库,ModularRSI 可进化其重试与错误处理逻辑,减少人工干预。
- 金融行业 的自动化报告生成代理,处理复杂终端命令与文件操作,通过自改进提高任务成功率。
商业价值
- 降低维护成本:传统手动优化 agent 执行逻辑需大量工程师时间,ModularRSI 自动从运行轨迹提炼改进,减少人工调试。
- 提升成功率:在 SWE-Bench Verified 等基准上一致提升,生产环境中任务失败率下降,直接减少返工与人工兜底成本。
- 跨模型泛化:进化后的 harness 可迁移到不同基础模型,避免为每个模型单独调优,节省部署成本。
跟现有产品 / 工作流的接口
- 模块化集成:将 harness 分解为
Agent Loop、Tool Use、Observation Management等模块,可嵌入 LangChain、AutoGen 等框架,替换对应组件即可。 - 接口明确:每个模块有独立接口,便于增量更新,不影响整体架构。
- CI/CD 集成:进化阶段作为离线批处理任务,定期用新轨迹更新 harness 配置,再部署到生产环境。
局限
- **评估域覆盖有限**:论文在 **TB2.0** 和 **SWE-Bench Verified** 上验证了泛化性,但这两个基准仍集中在 **coding 和 terminal 任务**。虽然用了 2,000 个外部 evolution tasks 隔离 benchmark,但跨域验证范围较窄,尚未覆盖 **web interaction、multi-modal agent、长对话交互** 等其他 agent 应用。此外,外部任务与下游基准的 domain gap 可能仍不够大,难以完全排除隐性 benchmark-specific adaptation。未来需在更广泛的任务类型和更强 domain shift 下评估。
- **模块化分解的预设结构可能限制适应性**:将 harness 固定分解为五个功能模块(**Agent Loop、Tool Use、Observation Management、Context Management、Task Completion Detection**)虽然便于隔离演化,但并非所有 agent framework 都具备这种边界清晰的组件。对于高度耦合或自定义的 harness 架构,这种分解可能引入额外集成成本,甚至无法直接应用。此外,模块独立演化后的 **integration stage** 依赖 LLM 解决冲突,可能无法保证全局最优,导致模块间语义不一致。
- **演化流程高度依赖 LLM 判断质量**:**contrastive trajectory analysis、harness modification、validation gates** 等关键环节均由 LLM 驱动,其输出质量直接影响 harness 演化效果。如果底层模型推理能力不足,可能产生低质量的修改建议或错误通过验证,从而将噪声引入系统。论文展示了跨模型迁移,但未分析演化过程对模型能力的敏感性,以及在较弱模型或不同模型家族上是否依然稳健。