ShieldVLA:面向 Vision-Language-Action 模型的可行性感知安全对齐
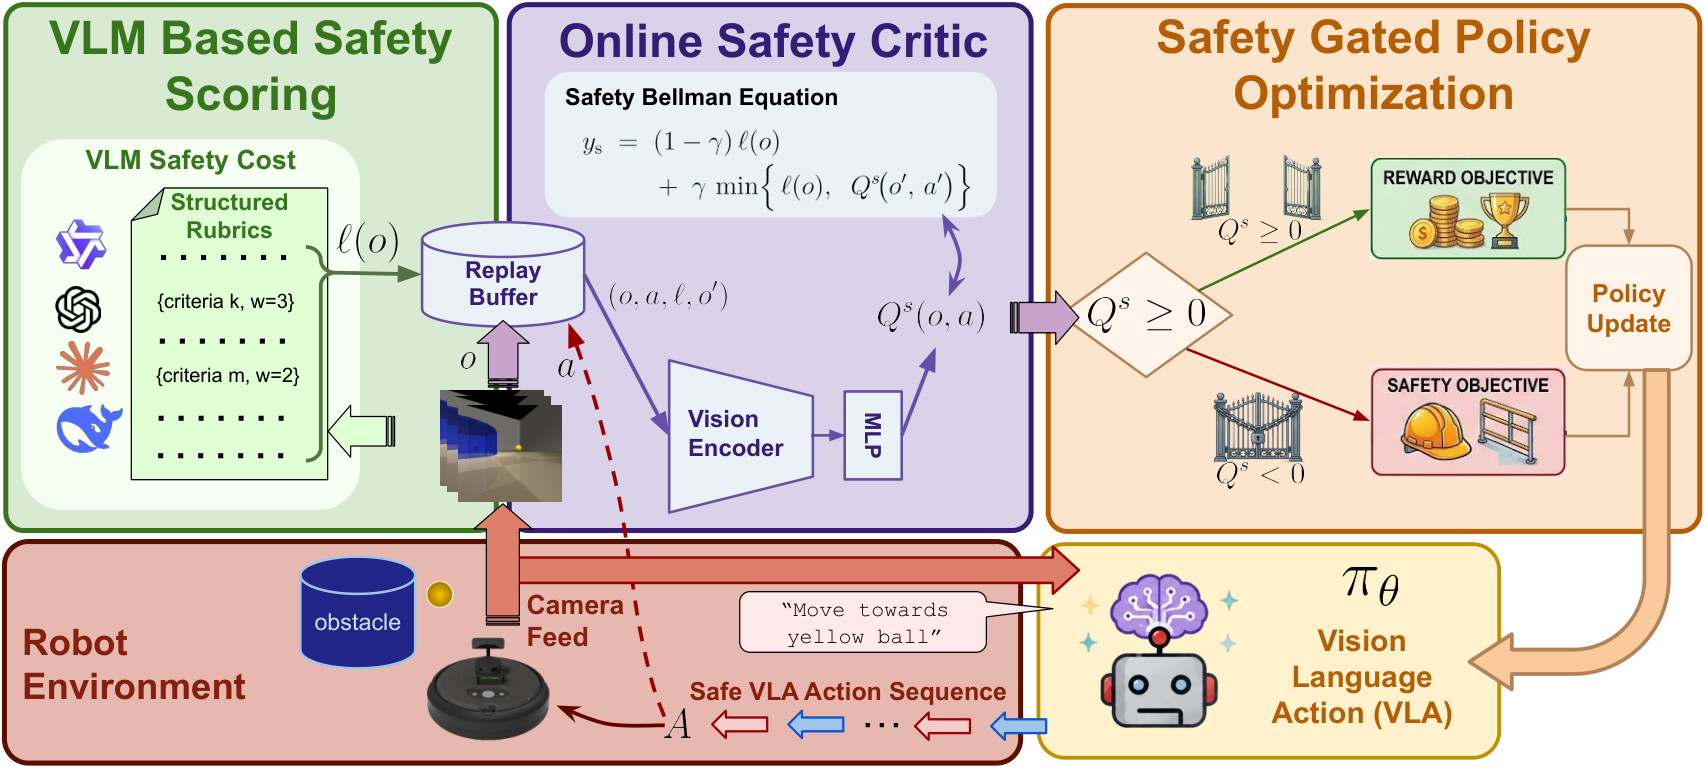
Vision-Language-Action(VLA)模型在机器人操作与导航中展现出强泛化能力,但现有微调方法能提供的安全保障十分有限。当前方法主要依赖 Lagrangian 优化,通过对期望累积代价施加软惩罚来约束安全性,往往导致残余的约束违反或过度保守的行为。此外,由于缺乏稠密的逐步安全标注,视觉领域的安全性学习尤为困难。 我们提出 ShieldVLA,一个基于 Hamilton-Jacobi(HJ) 可达性 的 VLA 模型安全对齐微调框架。ShieldVLA 直接从视觉观测中学习无模型的 HJ 可达性价值函数 近似,用以估计安全运行区域。所学安全 critic 对策略优化进行门控:在可行域内最大化奖励,在接近不安全状态时转向恢复,从而避免持续的奖励—代价权衡。为实现视觉环境中可扩展的监督,我们引入 基于评分量表(rubric)的 VLM 安全分数,将语义安全反馈转化为结构化的 critic 目标,无需人工代价标签。 在覆盖多个 VLA 骨干网络的五个导航与操作基准上,ShieldVLA 将累积安全代价平均降低 57%,任务成功率相比 SafeVLA 提升 +0.13。
论文精读
TL;DR ShieldVLA 用 Hamilton-Jacobi 可达性安全批评家对 VLA 做安全对齐,通过 VLM 自动生成安全监督,在五个基准上将累积安全成本平均降低 57%,任务成功率提升 0.13。
问题
问题背景
VLA 模型在机器人操控与导航任务中展现强泛化能力,但安全微调仍是部署瓶颈。现有安全对齐方法主要依赖 Lagrangian 优化,通过 soft penalty 约束期望累计代价,难以提供硬性安全保证。
现有方法局限
- Lagrangian 惩罚机制 把安全当作
expected cumulative cost的软约束:训练中允许一定代价累积,导致收敛后仍存在 残余约束违反;若提高惩罚系数又容易造成 过度保守,牺牲任务成功率。 - 视觉域中缺少 逐步安全标注,传统基于手工代价函数的方法难以扩展,因为图像观测高维且语义安全边界模糊。
- 软惩罚会形成持续的 奖励-代价权衡,策略无法在可行区域内纯最大化奖励,在危险状态附近又无法可靠恢复。
为什么这个问题难/重要
- 难度:HJ reachability 理论能刻画精确的 safe operating region,但需要从原始视觉输入在线估计可达性价值函数;模型需同时处理动态环境与视觉噪声,且无模型近似要求训练稳定。
- 重要性:VLA 正从演示走向真实机器人部署,安全约束从期望优化升级为逐状态可行性判定,直接影响 sim-to-real 部署可信度;业界对可验证安全的需求与日俱增,减少事故和误入危险区域成为商业化前提。
行业类比
这类问题类似 自动驾驶中从规则约束转向可证明安全的学习型控制:视觉-语言-动作策略需要类似“安全包络”的机制,才能在高维感知下平衡任务完成与硬约束。
核心洞察
- 该工作的核心创新是将 Hamilton-Jacobi reachability 的可行性边界估计引入 VLA 安全微调,通过一个在线学习的安全 critic 显式表示 safe operating region。不同于 Lagrangian 方法把安全作为软惩罚叠加到奖励中,ShieldVLA 让策略在可行区域内不受干扰地最大化任务奖励,仅在接近不安全状态时切换为恢复行为,从而解耦任务性能与安全约束。这种门控优化避免了 reward-cost 持续折衷,解释了其平均成本降低 57%、成功率提升 0.13 的实验结果。
- 视觉领域缺乏稠密逐步安全标注是现有方法的主要瓶颈。ShieldVLA 用 VLM 的 rubric 评分将语义安全判断转换为结构化 critic 目标,并通过 Refinement-through-Differentiation (RTD) 迭代优化评分准则,无需人工成本标签即可获得监督信号。相比手工定义 cost function 或稀疏标注,该流程可扩展,且利用了 VLM 的视觉常识推理,使安全 critic 的训练监督既丰富又稳定。
方法
输入与总体流程
ShieldVLA 接收视觉观察与语言指令,输入到 VLA 策略 生成动作分布。同时,观察也输入到在线安全评论家,用于估计当前状态的安全边际。
关键模块:在线安全评论家
安全评论家采用 模型无关的 HJ 可达性值函数近似,直接由视觉观测学习,不依赖显式动力学模型。它输出一个标量安全裕度,表示从当前状态出发、未来可能的最小安全边际。训练目标基于安全贝尔曼方程,用 TD 类方法从离线数据或在线交互中更新,无需手工成本标签。
关键模块:安全门控优化
策略优化被 解耦 为两个区域:
- 当安全裕度高于阈值时,策略在可行区域内正常最大化任务奖励;
- 当安全裕度较低时,策略切换到恢复模式,优先降低风险,避免继续陷入危险状态。
这种门控消除了 Lagrangian 方法中奖励项与成本惩罚项的持续权衡,不再需要调节惩罚系数。
关键模块:VLM 评分与 RTD
为了给安全评论家提供可扩展监督,ShieldVLA 利用 VLM 按预先设计的评分量表(rubric)对视觉观察进行语义安全打分,生成结构化 critic 目标。进一步通过 Refinement-through-Differentiation (RTD) 对 rubric 进行可微优化,提升评分与真实安全边际的一致性。
输出
最终输出为结合安全评论家的 VLA 策略:在导航或操作任务中,策略根据实时安全裕度选择动作,安全评论家持续更新。
与 SafeVLA 等基于 Lagrangian 软惩罚的方法不同,ShieldVLA 通过 HJ 可达性提供可行性感知的安全门控,从机制上避免残余约束违反与过度保守。
实验
实验设计
ShieldVLA 在五个导航与操作基准上评估:Dubins-VL、TurtleBot-Nav、Safety-CHORES Nav、Safety-CHORES Fetch、Franka-Reach,覆盖多种 VLA 骨干。对比基线包括 SafeVLA 等基于 Lagrangian 优化的方法,主要指标为累积安全成本与任务成功率。
关键发现
- 平均降低累积安全成本 57%(相对 SafeVLA)
- 任务成功率绝对提升 +0.13
- 消融实验与 out-of-distribution 鲁棒性测试验证了安全 critic 与 VLM 评分流水线的有效性
对比解读
现有 Lagrangian 方法通过软惩罚期望累积成本,常导致残余违规或过度保守。ShieldVLA 的 HJ reachability 安全 critic 显式估计可行安全区域,将奖励最大化限制在可行域内,靠近不安全状态时切换为恢复策略,从而避免持续的 reward-cost 权衡。这解释了为何 ShieldVLA 在安全成本大幅下降的同时成功率不降反升,验证了可行性感知安全对齐在 VLA 微调中的优势。
行业影响
落地场景
ShieldVLA 适用于任何基于 视觉-语言-动作模型 的机器人系统,尤其对安全约束要求高的场景:仓储物流机器人、家庭服务机器人、自动驾驶导航、工业机械臂操作。其核心是将安全建模为可行性约束而非软惩罚,避免奖励与成本的持续权衡,因此适合 semi-autonomous 或 fully autonomous 部署。
商业价值
- 降低事故与损坏成本:减少碰撞、越界等安全违规,直接降低维修和停机损失。
- 提升任务成功率:+0.13 成功率意味着更少重试和人工干预,提升吞吐量。
- 加速安全部署:利用 VLM 语义评分 自动生成 critic 监督,无需手动标注逐步安全标签,降低数据标注成本。
对工程启示:可避免 Lagrangian 方法常见的过度保守,在安全边界内最大化任务性能。
与现有工作流接口
ShieldVLA 可作为微调插件叠加在现有 VLA 骨干(如 OpenVLA、SPOC)之上。训练时引入轻量级 safety critic 网络,以视觉观测为输入输出安全余量估计,并用 rubric-based VLM 评分 生成训练目标。推理时 critic 门控策略:安全余量充足时执行任务策略,进入不安全区域时切换为恢复策略。可集成到 ROS 2、Isaac Sim 等机器人软件栈,通过标准模型权重加载和 actor-critic 推理模式运行。
具体落地 use case:
- 电商仓库 AGV/AMR:在密集货架环境中导航,避免碰撞货架或人员,同时保持拣选效率。
- 自动驾驶最后一公里配送:在行人、非机动车混行场景,保证不与障碍物碰撞,同时不牺牲到达率。
局限
- **依赖 VLM 评分器的可靠性与成本**:ShieldVLA 使用 rubric-based VLM 安全分数作为监督信号,但 VLM 本身对视觉场景的语义理解可能存在噪声或系统性偏差,尤其在遮挡、光照变化或罕见物体组合下。论文中虽然通过 RTD 优化 rubric,但未提供 VLM 评分与人工标注在困难场景下的一致性量化。此外,推理时每个训练样本都需要 VLM 前向计算,带来额外的计算开销,可能限制在资源受限的机器人平台上实时微调或在线更新的可行性。与使用手工成本标签的方法相比,ShieldVLA 在监督来源上引入了新的不确定性。
- **HJ 可达性值函数近似的外推能力有限**:学习到的 safety critic 本质上是对 HJ 值函数的模型无关近似,其准确性高度依赖于训练数据的覆盖范围。在训练分布之外的视觉状态(如新布局、动态障碍物速度突变)中,估计的安全边际可能过于乐观或保守,导致恢复策略失效或过度避险。论文在五个基准上展示了分布内性能和一定 OOD 鲁棒性,但未系统测试 critic 在极端环境扰动下的校准误差,也未分析 critic 网络容量对可达性边界拟合的影响,这是从仿真到真实部署的关键风险。
- **与更广泛的安全 RL 基线对比不足**:实验主要与 SafeVLA 对比,虽然 SafeVLA 代表 Lagrangian 类方法,但未纳入其他基于约束策略优化(如 CPO、PPO-Lagrangian 变体)或基于控制屏障函数(CBF)的微调方法。因此无法判断 ShieldVLA 的优势是否局限于特定基线选择。此外,所有评估均在模拟器中完成,缺少真实机器人上的闭环验证,而 VLA 模型在 sim-to-real 迁移中常出现的安全退化问题(如视觉差异、延迟)未被讨论。