Pelican-Sim 1.0:面向具身智能的通用世界模型模拟器
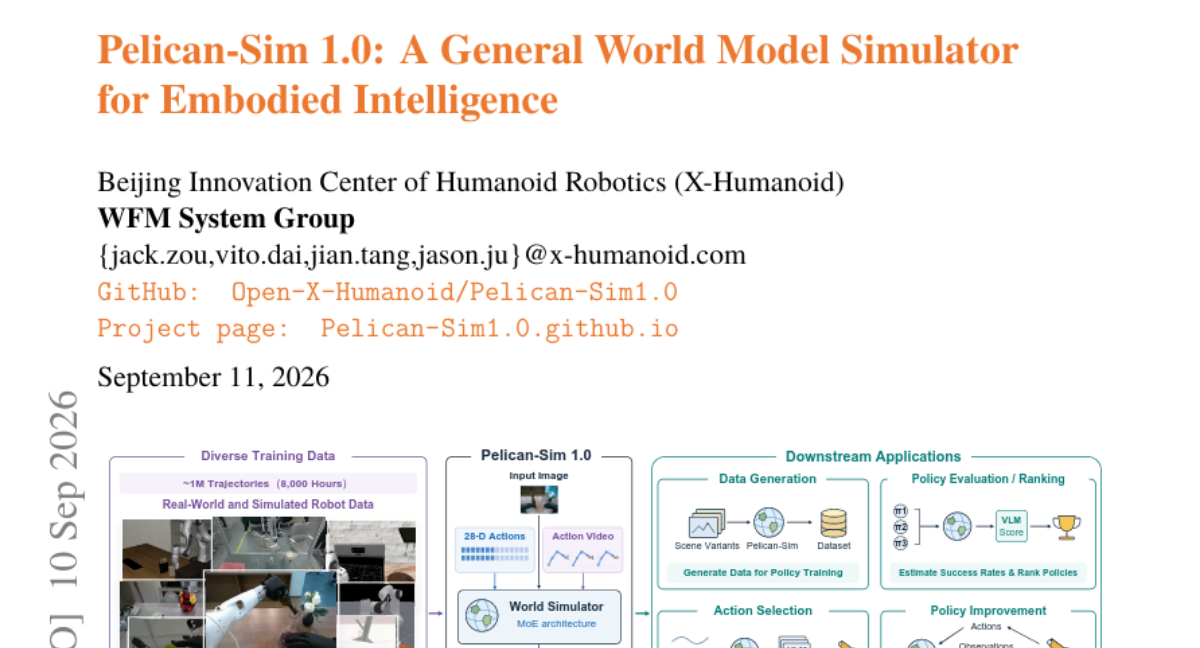
本技术报告提出 Pelican-Sim 1.0,一个面向具身智能的通用世界模型模拟器,可从视觉上下文与机器人动作预测未来观测,支撑下游学习与决策。模型包含四项关键设计: 1. 统一动作表示:28 维动作空间覆盖多数主流本体,使单一模型可跨异构设备使用; 2. 动作-视觉注入:借助 URDF 与相机渲染的动作视频连接动作与像素,在跨本体、场景与任务上显著提升可控性(PSNR 较其他融合基线 +0.904); 3. 稀疏 MoE:稀疏专家混合层为异构动力学扩充容量并吸收动作模态,缓解模态间冲突(FVD 较稠密骨干 -6.530); 4. 高效 rollout 生成:因果适配与少步蒸馏得到四步自回归模拟器,相比 35 步模型实现 5.67 倍加速。 基于上述设计,我们在约一百万条真实与仿真轨迹上训练,在动作可控性与视频质量上取得大幅提升:PSNR 在 AgiBotWorld Beta 上较最强评估基线提升 4.636,在 RoboMIND 上提升 2.080,在 RoboTwin 上提升 10.343;适配后的 EWMBench DYN 分数在 RoboTwin 上提升 0.426。 由此,RoboTwin 上的四项下游应用均获成功:每任务 50 条演示加入 500 条生成轨迹后,策略成功率由 70% 提升至 93%;策略评估在五个 checkpoint 上达到 0.994 的 Pearson 相关系数;动作选择与策略改进的相对成功率增益分别为 47.7% 与 20.3%。在轨迹、场景、物体、本体与视角偏移上的定性泛化,显示其作为通用世界模型模拟器的潜力。
论文精读
TL;DR Pelican-Sim 1.0 是一个通用世界模型模拟器,通过统一动作表示与动作-视觉注入,实现跨异构机器人本体的高可控视频生成,并利用稀疏 MoE 与少步蒸馏提升效率与质量。
问题
具身智能领域,世界模型正成为策略学习、评估与数据增强的核心组件,目标是根据视觉上下文和机器人动作预测未来观测,支撑下游决策。
现有方法的局限
- 动作空间异构:不同机器人的自由度、控制接口差异大,现有模型多为单一 embodiment 定制,跨本体泛化能力弱。
- 动作-视觉融合粗糙:主流方法采用拼接或 FiLM 等简单注入,像素级可操控性不足;本文实验表明替代融合基线 PSNR 低 0.904。
- 模型容量与模态冲突:密集 backbone 难以同时建模多种动力学,动作模态与视觉模态冲突明显,FVD 较稀疏 MoE 差 6.530。
- 推理效率低:自回归步数多(35 步)导致 rollout 速度慢,无法支撑高吞吐策略迭代。
为什么难且重要
- 统一动作表示需覆盖主流 embodiments 的连续/离散控制,设计通用接口难度大。
- 动作到像素的映射涉及运动学、遮挡、视角变化,必须通过 URDF 渲染等结构化先验注入,否则生成视频易失真。
- 世界模型作为基础设施,需在生成质量、控制精度和速度间取得平衡,业界高度关注能降低真实试错成本的通用模拟器。
行业类比
类似自动驾驶中神经仿真器为规划器提供闭环验证,Pelican-Sim 尝试构建机器人操作的通用神经模拟环境。
核心洞察
- 动作视觉注入(Action-visual injection)配合 28 维统一动作空间,将不同 embodiment 的动作渲染为 URDF 视频,与数值动作共同条件化世界模型,显著提升跨 embodiment 和场景的动作可控性。不同于大多数世界模型仅使用低维动作向量或文本条件,该设计把动作映射为与观察同模态的像素级信号,弥合了动作与视觉之间的语义鸿沟,PSNR 相对融合基线提升 0.904,证明视觉动作接口是更通用的跨设备动作表示方案。
- 因果少步蒸馏将 35 步自回归世界模型压缩为 4 步 rollout,获得 5.67 倍推理加速,并支持流式推理用于闭环策略评估与改进。相比常规扩散模型加速方法,因果自适应蒸馏在减少步数的同时保持时序因果一致性,使世界模型模拟器能够以低延迟、高吞吐输出未来帧,满足强化学习策略优化对大量交互轨迹的需求,这是世界模型从离线生成走向实时 sim-to-real 应用的关键工程突破。
方法
输入与总体框架
Pelican-Sim 1.0 以当前视觉观测(多视角相机图像)和机器人动作为输入,输出未来观测帧序列,作为通用世界模型模拟器。模型采用自回归视频生成范式:每次预测接下来若干帧,再滚动预测更远未来。
关键模块与流程
- 统一动作表示:将异构机器人(机械臂、人形等)的动作统一为 28 维动作值空间,使单一模型适配不同 embodiment。
- 动作-视觉注入:在动作向量之外,利用 URDF 模型和相机参数将动作渲染成视频帧,作为额外的视觉条件。两者分别编码后注入 Diffusion Transformer(DiT) backbone,其中渲染视频分支提供像素级动作先验,增强控制性。
- 稀疏混合专家(MoE):在 backbone 的前馈层引入稀疏 MoE,针对不同 embodiment/场景动态路由 token 到部分专家,增加模型容量并缓解动作模态与视觉模态之间的冲突。
- 高效 rollout 生成:先训练稠密 backbone(约 35 步采样),再通过因果蒸馏和少步蒸馏得到 4 步自回归模拟器,推理速度提升 5.67 倍。
训练与输出
训练数据约一百万条真实与仿真轨迹,覆盖多场景多机器人。模型输出高质量未来视频帧,可直接用于数据增广、策略评估、动作选择及策略优化等下游任务。
差异点:与常见仅将动作向量作为条件的世界模型不同,Pelican-Sim 显式引入渲染动作视频作为视觉条件,并结合稀疏 MoE,显著提升跨 embodiment 场景的视频质量与动作可控性。
实验
实验设计
评估覆盖 AgiBotWorld Beta、RoboMIND、RoboTwin 三个数据集,包含真实与模拟轨迹,并引入 VLM 自动评估器。训练数据约一百万条轨迹,兼顾多 embodiment 与任务分布。下游验证包括数据增强、策略评估、动作选择与策略改进四项。
关键发现
在三个数据集上 PSNR 分别比最强基线提升 +4.636、+2.080、+10.343,EWMBench DYN 提升 +0.426。稀疏 MoE 使 FVD 降低 6.530,动作-视觉注入 带来 PSNR +0.904,因果蒸馏 实现 5.67 倍 推理加速。数据增强将策略成功率从 70% 提升至 93%;策略评估 Pearson 相关达 0.994;动作选择与策略改进相对增益分别为 47.7% 与 20.3%。
与基线对比解读
与典型扩散世界模型不同,Pelican-Sim 1.0 通过 28 维统一动作值空间与 URDF 渲染动作视频,解决了跨 embodiment 动作注入的可控性瓶颈;稀疏 MoE 相比 dense backbone 更有效缓解模态冲突,工程上暗示异构轨迹混合训练需更高容量。四步自回归 rollout 大幅降低部署成本,说明因果蒸馏对实时仿真有实用价值;VLM 评估器与策略排序的高度相关也验证了自动评测路线的可行性。
行业影响
落地场景
Pelican-Sim 1.0 作为通用世界模型模拟器,可直接用于机器人产品研发中的数据增广、策略评估与仿真测试。在自动驾驶仿真中,可用其对路况与车辆行为进行高保真预测;在仓储物流机器人领域,通过少量真实轨迹生成大量合成交互序列,加速策略迭代。另一场景是消费级机器人(如家庭服务机器人)的 pre-deployment 验证,快速评估不同动作策略在未见环境中的表现。
商业价值
主要降本线:减少真机数据采集与人工标注成本。从报告看,500 条生成轨迹叠加 50 条演示即可将策略成功率从 70% 提升至 93%,意味着数据成本可大幅下降。同时 5.67 倍推理加速使实时仿真与在线策略评估成为可能,支撑更快的产品迭代周期。对提供机器人开发平台的厂商,集成该模型可增强其仿真工具链的竞争力,形成差异化。
与现有工作流接口
模型输出与策略训练框架(如 RLlib、stable-baselines3)兼容,可将生成轨迹直接导入 replay buffer。与 Isaac Sim、MuJoCo 等仿真器相比,Pelican-Sim 不需要显式物理建模,可通过动作视频注入控制,适合作为数据驱动仿真层。建议集成路径:在现有 MLOps 管道中加入 world model rollout 节点,用于数据扩增与策略离线评估;对需要实时推理的场景,利用其 4 步自回归蒸馏版本部署在边缘设备。
局限
- 统一动作表示的覆盖范围有限:28 维动作向量虽覆盖了主流机器人形态,但对灵巧手、触觉反馈、非刚体末端执行器等高自由度或非传统动作空间仍不充分;低维连续值可能丢失关节级精度与动作约束,导致对复杂精细操作的预测能力下降,模型在这些场景下的可控性需要进一步验证。
- 数据规模与多样性局限:训练仅使用约一百万条轨迹,相比互联网规模视频数据体量较小,且混合真实与仿真数据可能引入 domain gap,影响在全新场景或未见物体上的泛化性能。论文展示的 OOD 泛化主要基于 RoboTwin 模拟环境,真实世界复杂动态、光照变化及传感器噪声下的鲁棒性尚待大规模实测。
- 模型复杂性与部署成本:稀疏 MoE 层增加了参数量和路由计算,虽然通过因果蒸馏将生成步数从 35 步压缩到 4 步显著提升推理速度,但整体模型规模仍可能限制在资源受限的边缘设备或实时闭环控制场景中部署;蒸馏过程本身也需要额外训练成本,且蒸馏后模型在长时程 rollouts 中的稳定性需要专门评估。