超越 Solver 判决:面向自动形式化的生成式奖励模型
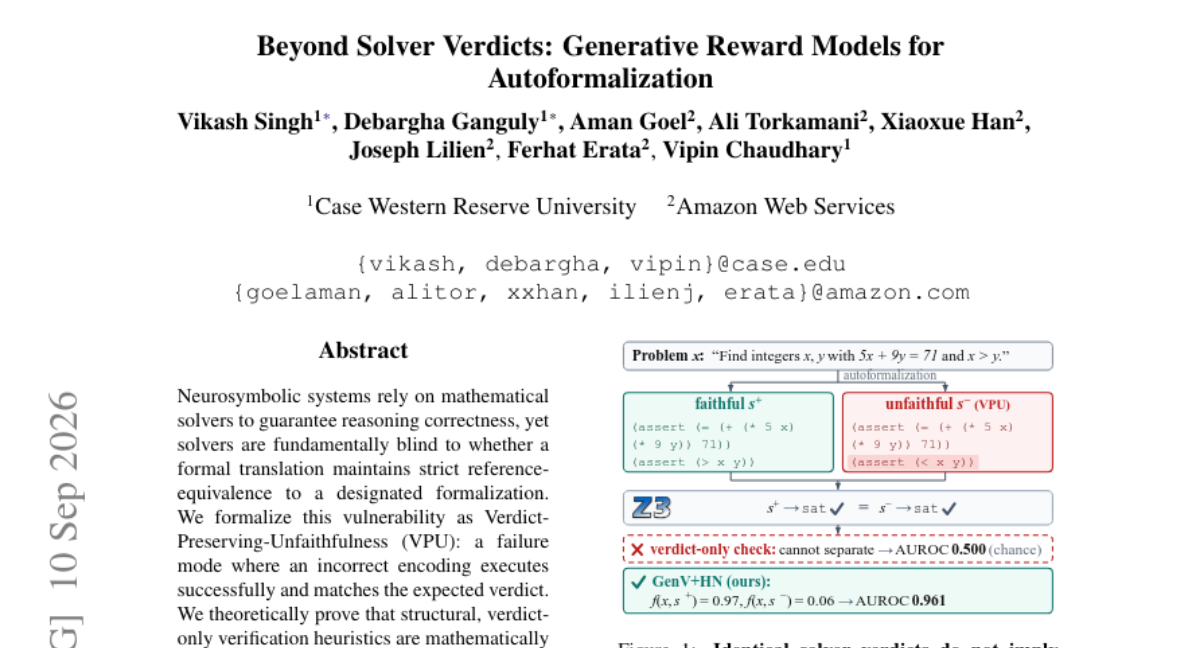
神经符号系统依赖数学求解器来保证推理正确性,但求解器本质上无法判断形式化翻译是否与指定的形式化保持严格的 reference-equivalence。我们将这一脆弱性形式化为 Verdict-Preserving-Unfaithfulness (VPU):一种错误编码却能成功执行、并匹配预期判决的失效模式。我们进一步从理论上证明,仅依据判决的结构化验证启发式方法,在这类具有欺骗性的有效轨迹上,其检测能力在数学上被限制在随机水平。 为解决该问题,我们提出 Generative Verification (GenV),通过复用语言模型的原生词表空间,将离线 Z3-equivalence oracle 蒸馏为一个无参考的连续 reference-equivalence 分数。借助 decision-projected logit lenses 与 sparse autoencoders 进行的机制分析表明,这种生成式读出无需显式定位训练,即可原生地提取精确的空间错误坐标。 实验上,我们的 oracle-mined verifier(GenV+HN)在 reference-equivalence 验证中取得 0.961 AUROC,可零样本泛化到未见过的翻译器与差异较大的形式化风格,并在 agentic test-time compute allocation 中带来 11.3 点 的下游准确率提升。
论文精读
TL;DR 针对神经符号系统中“裁决保留不忠实”漏洞,提出生成式验证 GenV,将 Z3 等价 oracle 蒸馏为连续参考等价分数,检测错误编码,AUROC 达 0.961,且零样本泛化。
问题
问题背景
当前神经符号推理(neurosymbolic reasoning)依赖数学求解器(如 Z3)保证推理正确性,但求解器只检查形式化编码能否执行并返回预期裁决(verdict),无法判断该编码是否与原始问题严格参考等价(reference-equivalence)。
现有方法的局限
现有验证多采用结构启发式或仅看 verdict 的方式,存在根本性缺陷:
- 错误编码可能恰好通过求解器并给出正确裁决,即 Verdict-Preserving-Unfaithfulness (VPU)。
- 论文理论证明:结构性、仅裁决的验证启发式对这类“欺骗性有效轨迹”的检测能力在数学上被限制在随机水平。
- 由于缺乏在线参考等价 oracle,验证器难以在没有人工标准答案的情况下区分表面正确与语义等价。
为什么难且重要
形式化翻译的语义保真度难以自动评估:自然语言到形式语言的鸿沟导致同一问题可被编码为不等价但同裁决的多个公式。VPU 会静默破坏神经符号系统的可信度,尤其影响 agentic test-time compute allocation 等下游任务——若验证器误信错误翻译,会浪费计算资源并输出错误推理。业界对可扩展、无参考的验证器有强烈需求,GenV 通过蒸馏离线 Z3 等价 oracle 为连续分数,提供了一条工程可行路径。
行业类比
类似代码生成中单元测试全绿但实现与需求语义不符,传统 CI 只验证行为不验证意图;需要类似变异测试或契约测试的机制来补充语义等价检查。
核心洞察
- 该工作首次将自动形式化中“仅核对 solver verdict 是否匹配”的验证盲区形式化为 Verdict-Preserving-Unfaithfulness (VPU),并证明基于结构特征或 verdict-only 的启发式方法在欺骗性有效轨迹上的检测能力被数学上限制在随机水平。这从根本上区别于以往只关注最终答案正确性或 solver 执行成功与否的方法,揭示了即使编码在 solver 上运行成功且输出符合预期,也可能与原始问题语义产生严重偏离,从而迫使社区重新审视神经符号系统的验证边界。
- Generative Verification (GenV) 将 reference-equivalence 验证从判别式分类器或结构比对重构为生成式打分:通过把离线 Z3-equivalence oracle 蒸馏到冻结语言模型的词汇空间,输出连续 equivalence 分数,无需在线调用 oracle 或提供参考形式化。这一设计避免了传统方法对 ground-truth formalization 的依赖,使验证器能够 zero-shot 泛化到未见过的 translator 和 formal style,并在 agentic test-time compute allocation 中带来 11.3 点的下游准确率提升,为实际部署提供了更灵活、低成本的验证方案。
- 机理分析表明,生成式读头通过 decision-projected logit lenses 和 sparse autoencoders 原生提取了参考等价性的空间误差坐标,证明该类信号已编码在模型内部表示中,无需额外 localization 训练。该发现不同于需要显式设计可解释性探针或训练辅助网络的同类工作,提示符号验证目标可以内化为语言模型的固有能力,为后续构建更透明、可信任的神经符号验证器提供了新的理论依据和工程路径。
方法
输入与目标
GenV 接收自然语言问题、其目标形式化 reference 以及一个待验证的形式化翻译 candidate,任务是为 candidate 是否与 reference 保持严格参考等价(reference-equivalence)给出连续分数。这一分数不依赖求解器判决,而是直接度量语义忠实度,以捕获 Verdict-Preserving-Unfaithfulness (VPU) 这类欺骗性正确但语义偏差的编码。
关键模块:蒸馏 Z3 等价 Oracle
训练数据来自离线 Z3-equivalence oracle:对大量配对的形式化编码,Z3 通过逻辑等价性检查生成硬标签(等价 / 不等价)。GenV 将这些标签蒸馏到预训练语言模型中,但并非采用分类头,而是重新利用模型原生词汇空间——在输出层将等价性分数映射为特定 token 的 logits 差异,从而获得连续的 reference-equivalence score。这一设计避免了额外任务头带来的分布偏移,并使分数可直接用于排序或阈值判定。
机械可解释性验证
作者通过 decision-projected logit lenses 和 sparse autoencoders 分析冻结的 GenV,发现其生成式读出能自然地提取空间误差坐标,无需显式定位训练。这表明分数并非黑盒拟合,而是编码了可定位的语义不一致信号。
输出与部署
GenV 输出一个标量分数,支持两种用法:一是作为一次性重排序器(one-shot reranking)筛选候选翻译;二是作为 agentic test-time compute 分配中的奖励信号。实验显示其以 0.961 AUROC 验证参考等价性,跨未见翻译器与形式风格零样本泛化。
与同类方法的差异
传统验证依赖结构化启发式或求解器判决,只能在“判决一致”层面区分,理论上对 VPU 的检测上限仅为随机水平。GenV 首次将参考等价性蒸馏为语言模型原生的连续得分,直接从语义层面识别欺骗性正确编码,摆脱了对求解器判决的依赖。
实验
实验设计:论文围绕神经符号推理中 Verdict-Preserving-Unfaithfulness (VPU) 脆弱性构建评估。首先用离线 Z3-equivalence oracle 生成等价性标签,蒸馏到生成式验证器 GenV+HN,输出连续参考等价性分数。评估覆盖 reference-equivalence 验证 AUROC、跨未见翻译器与不同形式风格的零样本泛化,以及在 agentic test-time compute allocation 中的下游准确率。
关键发现:GenV+HN 在 reference-equivalence 验证上达到 0.961 AUROC,说明其能有效识别语义偏离但裁决一致的欺骗性形式化翻译。零样本迁移到新翻译器和形式风格时性能稳健,无需重新训练。下游测试时计算分配带来 +11.3 点准确率提升。机制分析(decision-projected logit lenses 与 sparse autoencoders)显示生成式读出能自发提取精确空间误差坐标,无需显式定位训练。
与基线对比的深度解读:传统结构/裁决启发式被理论证明在 VPU 上只能达到 chance-level,因为它们只检查表面语法或 solver verdict,无法捕捉参考语义等价性。GenV 的关键差异在于将 oracle 知识蒸馏进语言模型自身词表空间,输出连续分数而非二元判定,这为检测微妙的不忠实翻译提供了细粒度信号。对实际工程的启示:神经符号流水线中,仅依赖 solver 结果存在系统性盲区,应引入参考等价性评分作为质量门控;该评分可由离线 oracle 蒸馏获得,且具备跨翻译器泛化能力,显著降低部署成本。
行业影响
落地场景
GenV 瞄准神经符号系统的可信验证环节,适用于任何依赖形式化求解器保证正确性的场景:
- 数学推理与代码生成:对 LLM 生成的 Lean/Isabelle 形式化证明或程序规格进行等价性校验,避免“错误但可执行”的编码通过验证。
- AI Agent 决策验证:在测试时计算分配中,用参考等价分对候选推理链排序,减少算力浪费在看似合理但语义偏离的路径上。
- 高安全领域:自动驾驶安全规约、金融风控规则、医疗协议的形式化建模中,自动发现 VPU 故障模式。
商业价值
核心降本增效路径:
- 降低人工复审成本:替代或辅助专家逐条检查形式化翻译,AUROC 0.961 的自动验证器可直接过滤大部分错误候选。
- 提升模型可信度与合规性:在审计要求严格的场景(如金融、医疗)提供连续等价分作为决策依据,减少事故风险。
- 优化推理算力分配:下游准确率提升 11.3 点意味着相同算力下可完成更多有效推理,直接转化为 API 服务毛利。
与现有产品/工作流的接口
- 作为 Reward Model 挂载:将 GenV 作为轻量级评分器接入 RLHF 或 RLAIF 流程,对形式化翻译数据自动标注等价性,替代昂贵的 oracle 调用。
- 集成到 LLM 推理栈:在采样后、提交求解器前插入 GenV 过滤层,或用于 beam search 中的 reranking。
- 与现有 solver 协同:保留 Z3 等求解器作为最终裁决,GenV 仅用于预筛和软奖励,不改变现有验证架构。
具体 use case:
- 电商平台促销规则验证:将自然语言促销条件翻译为 SMT 公式时,GenV 可自动检测“满减叠加逻辑”形式化错误,防止资损。
- 企业级代码助手:在生成 Dafny/Why3 注释时,用 GenV 判断规格与实现是否语义对齐,减少后端证明失败的迭代次数。
局限
- **依赖 Z3 等价 oracle 的质量**:GenV 的核心训练信号来自离线 Z3-equivalence oracle,但该 oracle 本身对不可判定片段、超时或资源限制只能返回 unknown,从而在蒸馏过程中引入噪声。论文虽提到对 unsatisfiable encodings 做了范围限定(附录 C.1),但未充分讨论 oracle 错误对模型校准的影响,尤其在复杂公式或高阶逻辑中可能产生系统性偏差。
- **零样本泛化边界不明确**:虽然实验展示了跨 unseen translators 和 divergent formal styles 的迁移能力,但形式化风格空间巨大,不同领域(如程序验证、数学定理、硬件设计)的形式语言差异可能使连续等价性分数失效。当前评估仍限于论文所用基准,缺乏对更广泛形式系统(如 Coq、Isabelle)和更长证明链的验证。
- **可解释性结论的因果性不足**:决策投影 logit lens 和稀疏自编码器揭示了与等价性相关的空间方向,但未通过干预实验证明这些方向足以修复错误翻译,或存在反事实因果。当前分析仅停留在相关性层面,且定位的误差坐标与下游修正操作之间的映射关系仍需进一步论证。