IdeaAMBIG: 对研究设想规范中影响实现的关键缺口进行基准测试
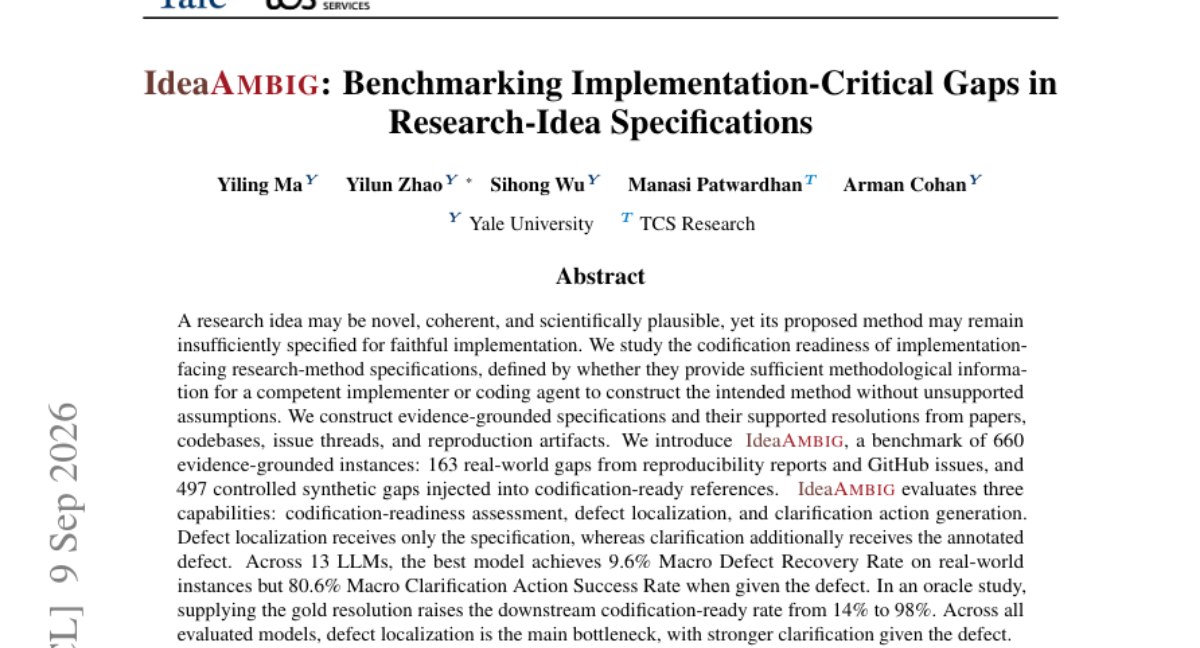
一个研究设想可能新颖、连贯且科学上合理,但其提出的方法可能描述不足,难以被忠实实现。我们研究面向实现的方法规范的 可编码就绪度(codification readiness),即其是否提供了足够的方法学信息,使有能力的实现者或编码智能体无需无依据的假设即可构建出预期方法。 我们从论文、代码库、issue 讨论串与复现工件中构建 有证据支撑的规范 及其受支持解答,并提出 IdeaAMBIG: 一个含 660 个证据落地实例的基准——163 个来自可复现性报告与 GitHub issues 的真实缺口,497 个为注入到可编码就绪参考中的受控合成缺口。 IdeaAMBIG 评估三项能力: 1. 可编码就绪度评估; 2. 缺陷定位(defect localization); 3. 澄清动作生成。 缺陷定位仅接收规范,澄清任务则额外接收标注的缺陷。在 13 个 LLM 上,最佳模型在真实实例上仅取得 9.6% 的 Macro Defect Recovery Rate,但在给定缺陷时取得 80.6% 的 Macro Clarification Action Success Rate。在 oracle 研究中,提供 gold resolution 可将下游可编码就绪率从 14% 提升至 98%。 在所有受评模型中,缺陷定位 是主要瓶颈,而给定缺陷后的澄清表现更强。
论文精读
TL;DR 构建 IdeaAMBIG 基准,用 660 个证据实例评估 LLM 对方法规格实现缺陷的定位与澄清能力,发现定位是主要瓶颈,给定缺陷后澄清成功率可达 80%。
问题
问题背景
AI 辅助科学研究正从生成新颖想法走向端到端自动化,但一个常被忽视的前置条件是:研究想法的规格说明是否足够明确,能让实现者或编码智能体无歧义地落地。
现有方法局限
已有评估基准多聚焦想法的新颖性、逻辑连贯性、科学合理性,却几乎不考察实现关键维度——方法描述是否完整、无歧义、无冲突。这导致两个断层:
- 自动生成的研究想法可能在评审层面通过,却在实现阶段因缺少关键细节而不可复现;
- 代码代理执行研究计划时,常因规格模糊而擅自假设,产生错误实现。 传统的缺失检测依赖人工复现报告或事后 issue 追踪,缺乏系统性、可控的基准来衡量 LLM 在该环节的能力。
为什么这个问题难/重要
实现关键缺口往往隐藏在看似完整的方法描述中,需要模型同时具备领域语义理解和实现链路推理:一处缺失的模型结构、配置协议或数据规范,都可能阻断整个复现流程。IdeaAMBIG 的实证结果显示,即便给定位缺陷,最佳模型的 Macro Clarification Action Success Rate 可达 80.6%,但在真实世界实例上的 Macro Defect Recovery Rate 仅 9.6%——缺陷定位是核心瓶颈。这类问题直接关系到自动化科研流水线的可靠性,也是 AI 编码代理落地研究场景的关键障碍。
行业类比
类似软件工程中从需求文档自动生成代码前,必须先检测规格说明的不可实现缺口,否则再强的代码生成模型也会产出看似合理却无法运行的系统。
核心洞察
- 研究想法规范存在实现就绪度缺口,需要从科学合理性中独立评估。IdeaAMBIG 通过证据支撑的真实与合成缺陷,量化了规范在实现层面的不确定性。与以往侧重科学创意新颖性评估的研究不同,该基准显式定义 codification readiness 并分解为评估、定位、生成三项任务,揭示了从想法到代码的中间层缺失。
- 缺陷定位能力是 LLM 实现自动代码生成的主要瓶颈:即使给出缺陷后模型能提出有效澄清(80.6% 成功率),但在无缺陷标注时定位准确率仅 9.6%。模型难以从冗长规范中识别实现关键阻塞点。提供黄金解决方案可将下游就绪率从 14% 提升至 98%,凸显定位能力对端到端自动化研究流水线的重要性。
方法
输入与数据构造
IdeaAMBIG 接受研究想法的方法规格文本(通常来自论文摘要、方法章节或 ideation 输出),以及可选的真实代码库 / 问题线索作为证据。基准包含 660 个实例:其中 163 个真实缺陷来自 reproducibility reports 与 GitHub issues;497 个受控合成缺陷通过向 codification-ready 参考中注入已知 gap 生成,所有实例均经过人工验证。输入中不提供实现细节,模型仅基于规格文本判断。
三项评估任务
- Codification-Readiness Assessment:二元分类,判断规格是否包含足够信息让胜任实现者无需额外假设即可复现方法。输出
ready或not-ready。 - Defect Localization:在判定为
not-ready的实例上,要求模型定位具体 implementation-critical 缺陷,例如缺失的模型结构、冲突的目标定义、未指定的数据配置。指标为 Macro Defect Recovery Rate,反映精确定位能力。 - Clarification Action Generation:在给出已标注缺陷位置的条件下,模型生成一个澄清动作(例如向作者提问“该损失函数中的温度参数如何调度?”)。指标为 Macro Clarification Action Success Rate,评估动作能否解决该缺陷。
输出上,后两个任务生成自然语言解释或动作建议;oracle 研究显示,若提供 gold resolution,下游 codification-ready 率从 14% 升至 98%,证明规格修正是关键路径。
差异点:IdeaAMBIG 不同于一般科学创意基准,它不评估想法新颖性或研究方案整体合理性,而是聚焦实现关键缺口,并将缺陷定位与澄清生成解耦,以证据支撑的方式暴露 LLM 在规格理解上的瓶颈。
实验
实验设计
IdeaAMBIG 基准包含 660 个证据接地实例,其中 163 个真实 gap 来自复现报告与 GitHub issues,497 个合成 gap 注入到原本可编码的参考方法中。评估三个能力:codification-readiness 评估、缺陷定位、澄清动作生成;测试 13 个 LLM。缺陷定位仅提供方法规范,澄清动作生成额外提供标注缺陷。
关键发现
最佳模型在真实实例上 Macro Defect Recovery Rate 仅为 9.6%,而给定缺陷后 Macro Clarification Action Success Rate 达 80.6%。Oracle 研究显示,提供 gold resolution 可将下游 codification-ready 率从 14% 提升至 98%。这表明缺陷定位是主要瓶颈:模型难以准确指出实现关键缺口所在,但一旦知道缺口,其提出的澄清问题大多有效。
与基线对比解读
与侧重 idea 新颖性或一致性的基准不同,IdeaAMBIG 强调方法规范的可实现性,更贴近工程落地。13 个 LLM 在定位真实 gap 时表现普遍低下(最高仅 9.6%),说明当前模型在精细方法理解上仍有明显短板。对比合成与真实数据,模型在真实数据上性能更弱,凸显分布偏移。对 AI 研究自动化而言,需优先增强缺陷定位能力或引入人工协作,因澄清动作生成已具较高可用性。
行业影响
落地场景
IdeaAMBIG 可直接嵌入 AI 公司的 论文到代码 工作流,例如电商平台的推荐算法团队复现最新排序模型时,先用该基准评估研究想法的 codification readiness(可编码就绪度),标记缺失的训练超参、数据划分或损失函数细节,再交给编码 agent 实现。另一个场景是 自动化研究助手:面向内容平台的 A/B 测试实验设计,自动扫描实验方案中的实现关键缺口,减少人工澄清往返。
商业价值
主要价值在 降本:当前最佳模型在真实 gap 上 Macro Defect Recovery Rate 仅 9.6%,但给定缺陷后 Clarification Action Success Rate 达 80.6%,说明瓶颈在定位而非提问。企业可将缺陷定位与澄清解耦,先用规则或轻量模型预筛关键缺陷,再让 LLM 生成澄清问题,大幅降低复现失败率和返工成本。Oracle 研究显示,提供 gold resolution 可将 codification-ready rate 从 14% 提升到 98%,证明澄清质量对下游代码生成成功率有决定性影响。
与现有产品/工作流接口
- 研究管理平台:作为 CI 检查步骤,在 PR 中自动运行 readiness 评估,类似 lint 工具。
- IDE 插件:结合 GitHub Copilot 或代码 agent,在生成代码前提示缺失的方法细节。
- 数据标注管道:复用其 evidence-grounded 标注协议,构建内部知识库,训练领域专用定位模型。
该基准与现有 SWE-bench 等代码修复基准的区别在于聚焦研究规范文本而非代码仓库,适合研究团队在立项和设计评审阶段前置拦截实现风险。
局限
- - 真实世界实例规模有限且存在选择偏差:**IdeaAMBIG** 仅包含 163 个来自可复现性报告与 GitHub issues 的真实缺口,远少于合成实例数量,且这些来源往往只记录已公开暴露的问题,难以覆盖论文中静默存在但未被报告的实现模糊。合成注入方式虽然提供了可控对照,但其“在原本无歧义的参考中插入单一缺陷”的设计可能简化了现实中多缺陷交织、上下文依赖的复杂模糊性,削弱了模型评估的生态效度。
- - 定位评估指标过于严格,可能低估模型实际能力:**Macro Defect Recovery Rate** 要求模型精确定位到标注的缺陷位置,但对“定位到相关模块但未精确到具体句子或参数”等近似正确情况没有给予部分得分。从结果看,最佳模型仅 9.6% 的恢复率,除了反映模型缺陷定位能力确实薄弱外,也可能受到标注粒度与严格匹配策略的影响。这限制了该基准对模型渐进改进的区分度,尤其是当模型已经能够缩小范围但仍无法精确命中时。
- - 基准与下游执行脱节,且模型覆盖有限:IdeaAMBIG 评估的是研究想法文本层面的实现规格,但未检验澄清动作对后续代码生成或复现实验的实际改善效果,除了 oracle study 的模拟外,缺少端到端验证。同时,实验仅采用 13 个通用 LLM,未纳入专门面向代码的模型或多步骤 agent 框架,而这些系统在实际科研自动化场景中可能表现不同。与 SWE-bench 等直接评估代码修复的工作相比,IdeaAMBIG 停留在规格缺陷层面,其指标对真实开发效率的预测力仍需进一步验证。