StochBench: 面向 Lean 中随机过程的领域专用基准
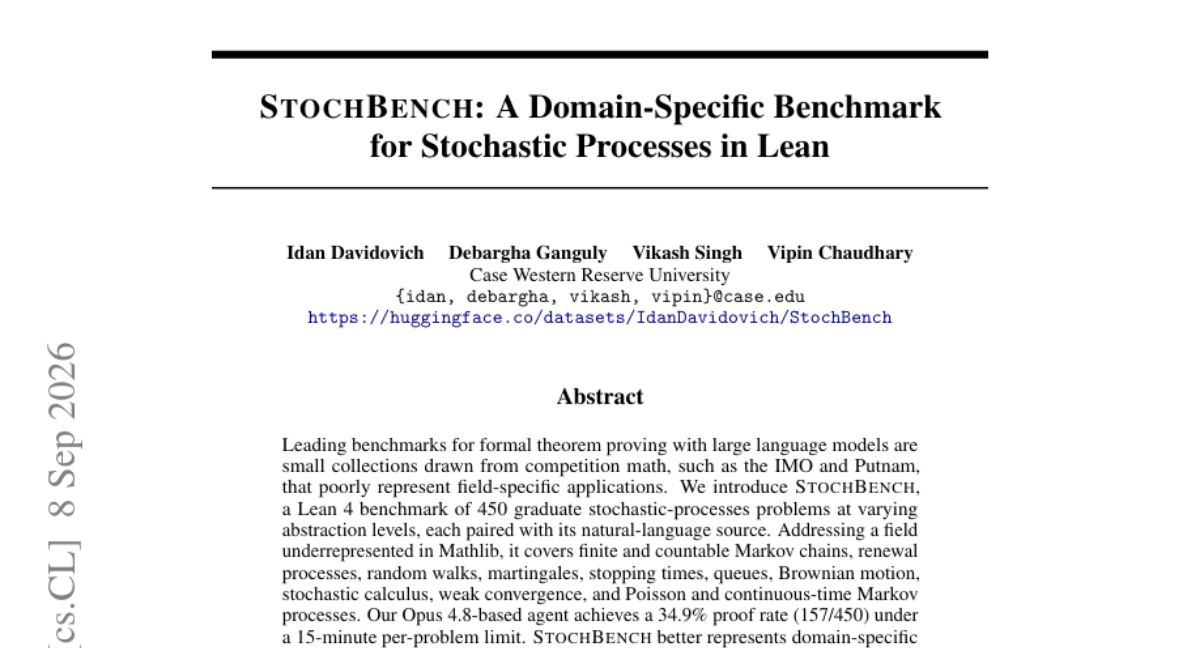
现有 面向 large language models 的形式化定理证明基准规模偏小,多取自 IMO、Putnam 等竞赛数学,难以代表特定领域的实际应用。 我们提出 StochBench,一个包含 450 道研究生水平随机过程问题的 Lean 4 基准,题目覆盖不同抽象层次,且每题都配有对应的自然语言题面。 该基准面向 Mathlib 中覆盖不足的领域,内容包括: - 有限与可数 Markov chains,以及 renewal processes、random walks、martingales 与 stopping times - queues、Brownian motion 与 stochastic calculus - weak convergence,以及 Poisson processes 与连续时间 Markov 过程 实验中,基于 Opus 4.8 的 agent 在每题 15 分钟的限制下取得 34.9% 的证明率(157/450)。StochBench 更好地代表了领域专用的应用数学,同时对先进证明器仍具挑战性。
论文精读
TL;DR StochBench 是一个 Lean 4 基准,包含 450 道研究生级随机过程问题,覆盖马尔可夫链、鞅、布朗运动等,填补了形式化定理证明在领域特定应用数学上的空白;当前最强智能体仅证出 34.9%,挑战性十足。
问题
问题背景
形式化定理证明与 LLM 结合是当前自动推理研究热点,已能处理竞赛级数学题(IMO / Putnam),并尝试向实际数学应用延伸。但针对特定应用领域(如随机过程)的基准仍稀缺。
现有方法局限
现有主流基准(如 MiniF2F、ProofNet)多取材于竞赛数学 或本科教材,题目数量少且分布分散,难以衡量模型在领域特定论证模式 上的稳定性。具体到随机过程:
- Mathlib 中随机过程所需的形式化基础设施(如条件期望、σ-代数、停时等)长期不足,许多标准定理缺失或表达不便;
- 竞赛题极少涉及连续时间过程、弱收敛、鞅论 等研究生级对象,导致模型无法在这些方向得到有效评估;
- 聚合分数掩盖了跨领域的能力差异,模型可能在代数题上得分高,却在概率论题上表现差,却无法定位。
为什么难 / 重要
随机过程的形式化难度显著高于离散数学:需要同时处理测度论、可测适应性、几乎必然收敛 等复杂结构与证明义务。构建基准时,需要为每个问题设计合适的抽象层次——直接使用 Mathlib 定义可能因基础设施缺失而失败,过度抽象又可能偏离原数学含义。StochBench 通过提供 450 个分层问题(直接目标 / 抽象目标),并保留自然语言源,为评估模型在领域内逐步构建形式化证明 的能力提供了更细粒度的信号。该领域在统计、机器学习、排队论等有广泛工程应用,推动自动证明能力向这类应用数学靠拢具有实际价值。
行业类比
这类似于通用代码生成基准 与特定框架(如 PyTorch 或 Spark)基准 的差异:通用分数高不代表能熟练处理领域 API 和惯用模式,需要专门评测集暴露盲区。
核心洞察
- 领域深度优先的评测设计:StochBench 聚焦随机过程,覆盖 Markov 链、鞅、Brownian 运动等核心对象,而既有基准(IMO、Putnam)与宽泛教材集合追求跨领域覆盖,难以反映应用数学中反复出现的证明模式。该基准以领域内深度替代广度,能揭示自动化证明器在特定数学分支上的能力短板,而非被聚合分数掩盖。
- 抽象化命题应对理论基础设施缺失:部分随机过程理论在 Mathlib 中尚未形式化,StochBench 将此类问题转化为“以所需性质为假设,证明结论”的抽象目标。这既保持了 Lean 校验下的逻辑严谨性,又绕开缺失的定义与定理,使原本因基础设施不足而无法评测的领域问题得以纳入基准。
- 高级证明器在应用数学上仍有显著差距:基于 Opus 4.8 的 agent 在 15 分钟限时下仅证明 34.9% 题目,说明当前 SOTA LLM 对研究生级随机过程证明的能力有限。这提示形式化证明评测需要更多面向实际应用领域的难题,以推动从竞赛数学向领域化数学推理的迁移。
方法
数据构建流程
- 输入:收集研究生随机过程教材、讲义与论文中的自然语言问题,覆盖有限/可数马尔可夫链、更新过程、随机游走、鞅、停止时间、排队、布朗运动、随机微积分、弱收敛、泊松过程与连续时间马尔可夫过程。
- 形式化与抽象:人工将问题形式化为 Lean 4 定理。对于 Mathlib 已有基础设施的部分,采用直接目标,直接引用库定义;对于缺失的定义(如特定随机过程模型),构造抽象目标,将所需性质作为显式假设引入,使结论在假设下成立。所有定义与假设由人类撰写,确保形式化无误。
- 配对环境:每个形式化问题与其原始自然语言源配对,便于语义一致性与可追溯性检查。
评估与证明代理
- 使用基于 Opus 4.8 的自动化证明代理,在每个问题 15 分钟时限内尝试构造 Lean 证明。
- 输出为证明成功率:157/450 = 34.9%,显示基准对先进证明器仍具较大挑战。
与同类方法如 MiniF2F、ProofNet 聚焦竞赛数学或通用教材习题不同,StochBench 通过领域聚焦和抽象化策略,填补了形式化定理证明基准在应用数学领域的空白。
实验
实验设计
- StochBench 包含 450 道研究生级随机过程题目,覆盖马尔可夫链、鞅、布朗运动、随机微积分等,每道题配对自然语言源,分为直接目标和抽象目标。
- 使用 Opus 4.8-based agent 在 Lean 4 中自动证明,单题限时 15 分钟。
- 评测环境基于 Mathlib,抽象目标将缺失基础设施作为假设引入。
关键发现
- 总体证明率 34.9% (157/450),说明 StochBench 对高级证明器仍具挑战性。
- 领域内深度问题(如马尔可夫链、鞅)与跨领域数学竞赛基准不同,更能暴露领域特定证明能力差距。
- 直接目标和抽象目标分离,允许在 Mathlib 基础设施不完善时仍验证推理能力。
与基线对比
- 没有提供直接基线数字,但通过对比指出传统竞赛数学基准(IMO、Putnam)规模小、领域代表性差。
- StochBench 通过集中领域问题提升信号密度,34.9% 的证明率表明现有自动证明器在应用数学上仍有较大提升空间。
行业影响
落地场景
StochBench 聚焦随机过程的形式化定理证明,覆盖马尔可夫链、鞅、布朗运动、随机微积分等核心主题。这些理论广泛支撑以下工业场景:
- 金融工程:衍生品定价、风险模型(如 VaR 尾部估计)的正确性验证;高频交易策略中随机过程的收敛性与稳定性证明。
- 云服务与排队系统:分布式系统负载均衡、消息队列延迟保证的形式化分析,确保 SLA 可达性。
- 强化学习与自动驾驶:MDP / POMDP 策略收敛性、安全约束的概率保证,减少仿真与现实差距。
- 供应链与库存管理:随机需求下的最优策略证明,避免启发式方法的不可靠性。
当前 34.9% 的证明率表明自动化程度有限,但已能为专家提供辅助,将人工验证从周级压缩至小时级。
商业价值
- 降本:将形式化验证从纯人工(高门槛、高工时)转变为半自动化流程。金融、安全关键系统中一次错误可能造成数百万美元损失,提前机器验证可显著降低审计与合规成本。
- 增收:提供基于 Lean 4 的定制化验证服务或工具链,向需要高可靠性数学保障的行业(如量化基金、云厂商)输出能力,形成差异化产品。
- 体验提升:在医疗统计、工业控制等场景,经过形式化验证的模型可提升用户信任度,缩短监管审批周期。
与现有产品/工作流的接口
StochBench 以 Lean 4 为宿主语言,输出形式化证明脚本,可集成至以下现有 stack:
- 证明助手环境:作为评测基准嵌入 CI/CD 流水线,持续评估内部 LLM 证明代理的能力演进,指导模型微调与提示词优化。
- IDE 插件:与 VS Code 的 Lean 扩展结合,提供“自然语言问题 → 形式化陈述 → 自动证明尝试”的交互式辅助,降低工程师形式化门槛。
- 企业知识库:对内部随机过程相关算法(如推荐系统 bandit 模型、物流调度)进行形式化规约,利用 StochBench 训练的模型自动生成验证脚本,纳入代码评审流程。
具体用例:某电商平台使用多臂老虎机算法进行实时推荐,可利用 StochBench 风格的证明任务验证其 regret 上界,保证长期收益稳定性;某云服务商对消息队列的 tail latency 进行概率保证,通过形式化证明泊松到达与指数服务的稳态分布,替换传统的蒙特卡洛模拟,节省计算资源并提升可信度。
局限
- 论文承认部分问题需要对 Mathlib 中缺失的随机过程基础设施进行抽象化处理,即将所需性质作为假设而非直接使用现有定义。这虽然降低了形式化门槛,但使证明目标更接近条件推理而非完整领域知识构建,可能高估模型在真实 Mathlib 环境下的能力。此外,抽象化程度未量化,导致不同问题之间的难度失准。
- 评估仅基于 Opus 4.8 单一模型,缺少与主流自动定理证明器(如 GPT-4、DeepSeek-Prover、LeanDojo 等)的横向对比,无法判断基准对不同系统优劣的区分度。同时,15 分钟单题限制较长,可能掩盖搜索策略在时间敏感场景下的效率差异,使结果偏向于“暴力搜索可解”的问题。
- 数据来源为人工选择的 450 道研究生习题,覆盖面有限,且未报告自然语言题目到 Lean 形式化的双人校验或自动化一致性检查,可能存在形式化偏差。与 MiniF2F、ProofNet 等既有基准相比,StochBench 的规模较小,且未提供训练集/测试集划分的标准协议,影响复现和后续迭代。