PlannerForge: 面向自动驾驶运动规划器场景化测试的 LLM Agent
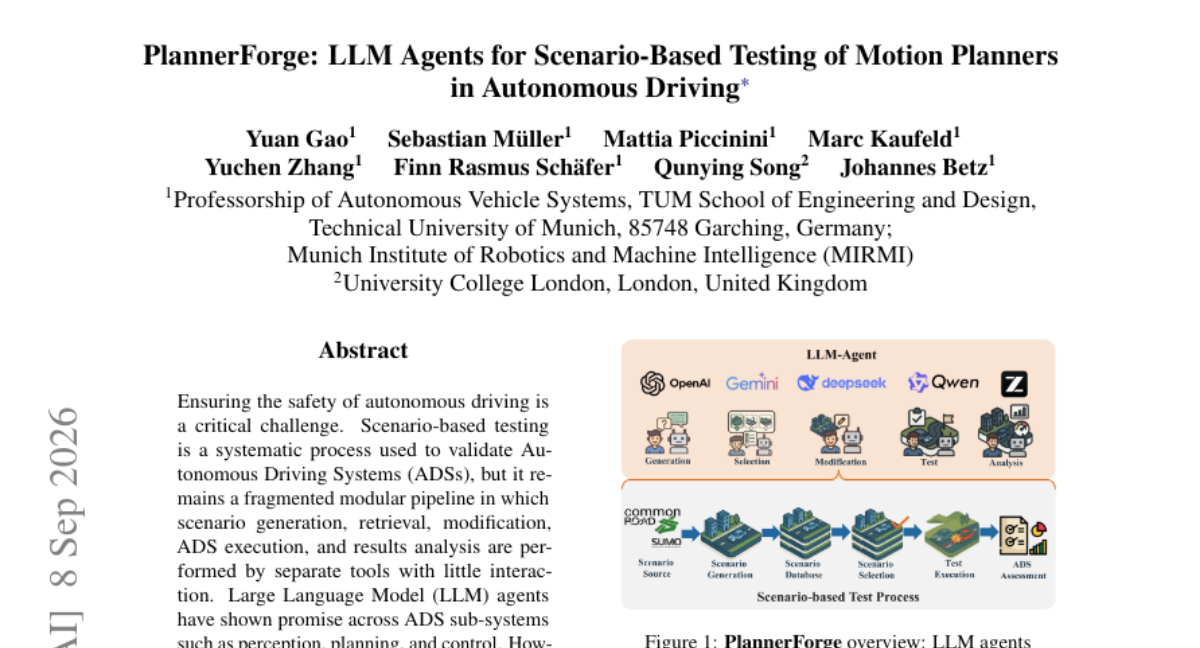
自动驾驶系统(ADS) 的安全验证至关重要。场景化测试 是验证 ADS 的系统性流程,但当前仍是碎片化的模块流水线:场景生成、检索、修改、ADS 执行与结果分析由各自独立的工具完成,彼此几乎不交互。尽管 LLM Agent 已在感知、规划、控制等 ADS 子系统中展现出潜力,但尚无工作以统一的 LLM-agent 框架覆盖 ADS 场景化测试的完整流水线。 我们提出 PlannerForge,一个 LLM-agent 框架,扩展了场景化测试的全部阶段(从场景生成到 ADS 评估),并新增两个由 LLM 增强的阶段:ADS 增强 与 ADS 基准测试。 我们在 5 种 prompt 条件下,用 10 个现成 LLM 在全部任务(生成、选择、修改、模块路由、规划器测试、增强)上评估 PlannerForge: - 单任务最佳得分在 0.88–1.00 之间,开源 20–35B 后端在多数任务上可与商业 API 持平;Qwen3.6:35B 等开源模型在五项任务中的三项上追平商业 API。 - 端到端串联模块可保留 83%(商业)/ 78%(开源)的种子查询。 - 自然语言生成上以 193/200 条可执行场景优于 Scenario Factory 2.0(144/200),并实现 92–96% 的指定城市、道路与车辆属性。 - 在选择任务 rank 1 上以 92.0% 优于 BM25(67.5%);在物理有效编辑上以 ≥94% 大幅超过 From-Words-to-Collisions(31%)。 在 N=400 时,成本调优将规划器成功率从 50.4% 提升至 70.2%,并把碰撞从 19.0% 降至 8.4%,且无需任何领域特定微调。
论文精读
TL;DR PlannerForge 将自动驾驶场景测试全链条(生成、选择、修改、测试、增强)统一为单一 LLM-agent 框架;开源 20-35B 模型在多数任务媲美商业 API,成本调优后碰撞率减半、规划成功率提升近 20%。
问题
问题背景
自动驾驶系统(ADS)的安全验证高度依赖基于场景的测试。该流程覆盖场景生成、检索、修改、ADS 执行与结果分析,是评估运动规划器鲁棒性的核心手段。
现有方法局限
- 当前场景测试管线模块化但碎片化:场景生成、检索、修改、执行与结果分析由独立工具完成,工具间交互有限,难以全局优化。
- 虽然 LLM 智能体已在感知、规划、控制等子模块中单独应用,但尚无统一 LLM 智能体框架覆盖从场景生成到 ADS 评估的完整闭环,各阶段缺乏共享语义上下文,导致误差跨模块累积、效率受限。
- 已有工具如 Scenario Factory 2.0 与 From-Words-to-Collisions 在自然语言生成或物理有效性上各有短板,且不支持端到端自适应增强。
为什么这个问题难、为什么重要
- 场景空间组合爆炸,安全关键场景占比极低,需要智能生成、检索与修改;LLM 在物理约束下保持场景有效性是核心挑战。
- 业界对可扩展、低成本的安全验证管线需求强烈,但不同 LLM 后端在各任务上的能力差异显著,需要系统化评估与调度。
- 统一框架能实现测试—反馈—增强的闭环,直接提升规划器成功率并降低碰撞率,无需领域微调即可获得显著收益。
行业类比
类似从分散的单元测试工具演进到智能体驱动的持续集成测试平台,通过统一语义接口连接测试生成、执行与修复,实现闭环迭代。
核心洞察
- 统一 LLM-agent 框架将场景测试从碎片化工具链重构为端到端协同闭环,并引入测试后的增强与基准阶段。与传统流水线相比,PlannerForge 在自然语言生成可执行场景上达到 193/200,而 Scenario Factory 2.0 仅 144/200;物理有效编辑比例从 31% 提升至 ≥94%。这证明 LLM 的语义解析与推理能力能直接替代手工规则和启发式,大幅减少中间表示损失,无需领域特定微调即可支撑复杂自动驾驶测试场景的生成与修改。
- 开源 20-35B 模型已具备匹敌商业 API 的测试代理能力,为低成本部署提供了实证依据。PlannerForge 在 10 个 LLM、5 种提示条件下评估,发现 Qwen3.6:35B 在五个任务中的三个匹配商业 API,端到端查询保留率 78% 对比商业 83%。这表明通过精细提示工程和模块路由设计,中小规模开源模型能补偿参数差距,工程团队可优先选择本地部署的开源后端,避免封闭 API 依赖与数据外流风险。
- 成本调优(cost-tuning)利用测试闭环反馈动态调整场景生成,形成超越静态场景库的 ADS 增强机制。在 N=400 实验中,规划器成功率从 50.4% 提升至 70.2%,碰撞率从 19.0% 降至 8.4%,全程无领域特定微调。这种机制让 LLM 代理根据规划器表现迭代优化场景分布,使测试资源集中在高价值安全关键场景,相比传统基于检索或预先定义的场景集,更接近自动驾驶系统的在线安全验证需求。
方法
输入与整体流程
PlannerForge 接收自然语言场景查询(如 “城市交叉口行人横穿”)和目标运动规划器配置。Module Router 首先对查询进行语义分类,将任务分派至五个核心模块:Scenario Generation、Scenario Selection、Scenario Modification、Planner Testing、Planner Enhancement。路由采用 LLM 语义理解,辅以确定性规则兜底,避免对边缘查询误分派。
关键模块
- Scenario Generation:LLM 将查询转化为可执行场景描述,同时调用确定性工具校验物理约束(道路几何、车辆动力学等),通过 hallucination isolation 将 LLM 生成内容限制在语义层,工具负责数值与逻辑校验,保证场景可直接被仿真器加载。
- Scenario Selection:从现有场景库中检索与查询最相关的场景,先由 BM25 初筛,再由 LLM 重排序并抽取关键槽位;排名第一选择准确率达 92.0%(对比 BM25 的 67.5%)。
- Scenario Modification:根据用户指定的城市、道路类型、车辆行为等属性修改场景参数,LLM 生成编辑指令,经物理有效性检查后返回修改场景,物理有效编辑率 ≥ 94%。
- Planner Testing:将生成、选择或修改后的场景输入运动规划器执行,记录规划轨迹、成功率与碰撞率等指标。
- Planner Enhancement:基于测试结果,LLM 分析失败案例并给出成本函数调优建议(cost-tuning),迭代提升规划器在困难场景下的表现(N=400 时成功率 50.4%→70.2%,碰撞率 19.0%→8.4%);同时支持 ADS Benchmarking,对不同规划器进行基准测试。
输出与差异点
端到端链路保留 83%(商业 LLM)/ 78%(开源 LLM)的种子查询可执行性,输出包括场景集、规划器性能报告和增强后的规划器配置。
与同类方法的差异:PlannerForge 是首个覆盖场景生成、选择、修改、测试、增强与基准全流程的 LLM-agent 框架,通过模块路由与幻觉隔离实现工具链可靠衔接,而非单一阶段替代或分离工具集成。
实验
实验设计
框架在 10 个现成 LLM 上覆盖 Generation、Selection、Modification、Module Routing、Planner Testing、Enhancement 六类任务,配合 5 种 prompt 条件;端到端串联使用 200 个种子查询评估生成执行,并以 BM25、From-Words-to-Collisions 和 Scenario Factory 2.0 作为选择、修改与生成基线;在 N=400 场景上评估 cost-tuning 对规划成功率和碰撞率的影响。
关键发现
最佳单任务得分 0.88–1.00;开源 20-35B 模型在多数任务追平商业 API(Qwen3.6:35B 在五分之三任务达到商业水平);端到端保留 83%/78% 种子查询。生成可执行场景 193/200(对比 144/200),Rank-1 选择准确率 92.0%(对比 67.5%),物理有效修改 ≥94%(对比 31%)。cost-tuning 将成功率从 50.4% 提升至 70.2%,碰撞率从 19.0% 降至 8.4%,全程无需领域微调。
与基线对比解读
相比 Scenario Factory 2.0,PlannerForge 多生成 49 个可执行场景;相比 BM25,选择准确率提升 24.5 个百分点;相比 From-Words-to-Collisions,物理有效性从 31% 跃升至 94% 以上,体现 LLM 对物理约束的语义理解。cost-tuning 结果证明,仅通过迭代调整代价函数就能显著提升运动规划器安全,对快速原型验证具有工程价值。
行业影响
落地场景
PlannerForge 可直接嵌入自动驾驶公司或 Tier 1 供应商的 场景库工程建设 与 规划器回归测试 流程。典型使用场景包括:
- 从自然语言需求批量生成 OpenSCENARIO 兼容场景,覆盖城市 / 道路 / 车辆属性组合
- 自动路由到最合适的生成 / 修改模块,持续扩充高价值 corner case 库
- 对运动规划器进行每日构建级回归,输出成功率 / 碰撞率 / 安全距离等指标
也可扩展至 具身智能机器人导航测试:将路面语义替换为室内布局,复用同一套 LLM 驱动的测试编排逻辑。
商业价值
主要切入 降本 与 安全增益 而非直接增收:
- 传统场景构建依赖工程师手工制作,单场景成本高且覆盖率有限;PlannerForge 报告开源自模型在多个任务上达到 0.88-1.00 分数,并实现 92-96% 属性符合率,可将场景库扩充成本降低一个数量级
- 端到端链式执行保留 83% / 78% 种子查询,减少人工介入
- 成本调优将规划成功率从 50.4% 提升至 70.2%,碰撞率从 19.0% 降至 8.4%,直接降低真实路测中的安全风险与召回成本
与现有产品 / 工作流的接口
集成路径清晰,因为它解决的是 测试编排层 而非替换仿真器:
- 输入侧:通过 REST API 或 CLI 接收自然语言 / JSON 场景需求
- 中间层:调用 LLM 后端(支持 OpenAI / vLLM / Ollama 等),通过 Module Router 分派到 Generation / Selection / Modification 等模块
- 输出侧:产出标准 OpenSCENARIO / JSON 场景文件,可直接导入 CARLA / esmini / Scenario Runner 执行
- 数据回流:将仿真结果写回结果分析模块,自动触发下一轮场景增强,形成闭环
实际工程中可将其作为 CI 流水线中的一个 scenario-testing agent,替换目前由脚本拼接的脆弱流程,同时保留与现有场景数据库(如 ASAM OpenSCENARIO 格式)的兼容性。
局限
- **评估环境与场景覆盖有限**:论文主要在模拟或合成场景中验证 PlannerForge,未在真实车辆或高保真仿真闭环中测试。场景生成与修改的评估指标偏重可执行性与属性匹配,但对**对抗性场景**、**极端天气/光照**等 OOD 条件的覆盖不足。此外,选择与修改任务基于特定查询语料,泛化到开放域请求可能性能下降。
- **端到端错误传播与损耗**:链式调用各 LLM 模块时,端到端保留率约为 83%(商业)与 78%(开源),意味着约五分之一查询在流水线中丢失或产生无效结果。尽管模块级精度很高,但**多阶段累积误差**可能遗漏关键测试用例,影响 ADS 安全验证的完整性。作者未深入分析哪些模块是错误主要来源,也未提出错误恢复机制。
- **计算成本与部署门槛**:框架依赖大语言模型执行所有阶段,包括生成、选择、修改与增强,推理延迟与 token 成本可能限制大规模场景库构建。论文未报告单次测试的平均 GPU 时间或 API 成本,也未与基于规则或轻量模型的混合方案对比成本效益。对于资源受限的测试环境,全 LLM-agent 方案可能不经济。