持续学习机制的组合实现长时程记忆
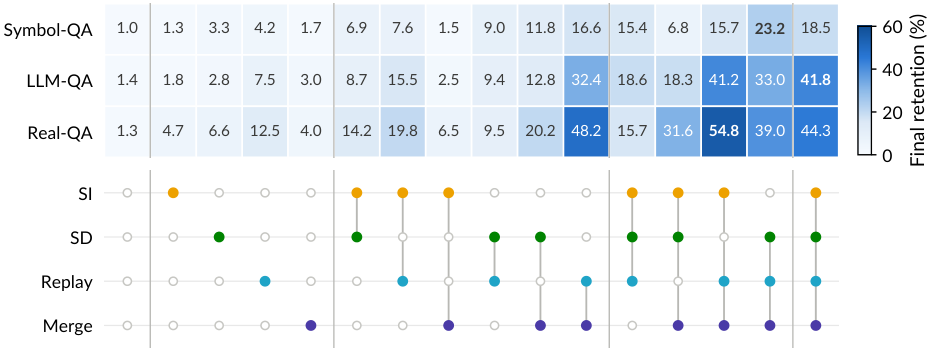
长时程记忆 研究的是语言模型如何内化随时间陆续到达的信息,并在多次后续更新中将其保持下来。为此我们引入 long-horizon memorization 设定:模型通过持续监督微调学习 100 个 query-answer 任务,既不保留早期训练样本,推理时也不提供任务标识。顺序更新会导致 灾难性遗忘,而我们评估的任何单一持续学习机制都无法在该时程下维持较强的保持能力。 我们假设:针对互补遗忘来源的机制在组合后会更有效。为此按两个设计维度组织这些组合:data、function、weight anchor 规定每次更新应保留哪些先验信息,而 low-rank 分配规则决定后续更新被保留在何处。 为系统验证该假设,我们构建了三个各含 100 个任务的记忆数据集,提出 task-level successive halving 来搜索组合设计空间,并用 factorial experiment 度量各机制的单独效应与交互效应。 最佳方法将三种 anchor 与 merged LoRA 结合,在全部数据集上均位列前 3,把平均最终保持率从朴素顺序微调的 1.2% 提升到 34.9%,即 28 倍提升。其中 data anchor 与 merged LoRA 的平均增益最大,并在三个数据集上均表现出超加性交互。这些结果表明,组合互补机制能显著提升长时程记忆,超越任何单一机制所能达到的水平。
论文精读
TL;DR 研究100个QA任务持续微调下的长时程记忆,组合数据/函数/权重锚点与merged LoRA,将平均最终保留率从1.2%提升至34.9%(28倍),显著缓解灾难性遗忘。
问题
语言模型在实际部署中需要具备持续学习(continual learning)能力,能够不断吸收新知识同时保留旧知识,而当前长视野下的记忆保持是持续学习领域的核心关注点。
现有方法局限
传统持续学习机制在短任务序列中有效,但在长视野(如 100 个任务)下表现不佳:
- 数据回放(replay)需要存储旧样本或依赖生成模型,存储成本高或生成质量不稳定;
- 参数正则化(EWC/SI)基于参数重要性估计,长序列更新下估计偏差逐渐累积,遗忘无法避免;
- 参数隔离(LoRA 扩展)若缺少任务标识或未合并更新,难以整合跨任务知识,单独使用保留率极低。
论文实验显示,单一机制在 100 任务序列下平均最终保留率仅 1.2%(朴素顺序微调),最高也远低于 10%,表明任何一种机制的独立效果都无法支撑长视野记忆。
为什么这个问题难且重要
长视野记忆的核心挑战是遗忘随更新步数指数累积,模型必须在无任务标识的推理条件下隐式组织所有已学知识。实际应用中,模型部署后通常通过用户反馈持续微调,全量重训不可行,因此亟需能在线更新且不遗忘的机制。业界对持续监督微调(continual SFT)的关注持续升温,大模型时代这一能力直接决定模型能否安全、可靠地长期服务。
行业类比
类似对话助手每天学习新用户偏好,不能因为学了新用户就忘记老用户的习惯,且无法为每个用户单独维护一个模型或任务标识,这要求模型具备内在的长视野记忆整合能力。
核心洞察
- 长时记忆场景下,单一持续学习机制不足以应对大规模顺序更新带来的灾难性遗忘,必须组合互补机制。与以往工作孤立评估或简单叠加不同,本文通过任务级 successive halving 搜索 100 任务规模下的组合空间,发现组合方法将平均最终保留率从 naive 顺序微调的 1.2% 提升至 34.9%(28 倍),且远超任何单一机制。这揭示了在高任务数下,多机制协同的必要性,为持续学习系统设计提供了新的范式。
- 数据锚点(无条件生成回放)与 merged LoRA(低秩分配规则)的组合产生超加性交互,是性能提升的主要来源。单一 replay 或参数隔离方法在长序列中均会失效,但两者结合时,回放提供跨任务泛化约束,merged LoRA 在低秩子空间内累积任务知识,相互增强。这一发现说明在持续微调中应优先考虑数据侧与结构侧的互补设计,而非只优化某一种经典机制。
方法
输入与整体流程
模型依次接收 100 个 query-answer 任务 进行 continual SFT,不保留历史样本,也没有 task ID 可供推理时使用。目标是在所有任务更新后仍能回答早期问题。
关键模块
机制围绕两个设计维度组织:
- 三个 anchor:
- data anchor:无条件生成伪 replay 数据,缓解数据分布遗忘;
- function anchor:对前一状态输出分布做自蒸馏,保持函数映射稳定;
- weight anchor:使用 Synaptic Intelligence 或 Online EWC 约束重要参数变动。
- 低秩分配规则:决定增量保存在哪里,包括 Shared LoRA、merged LoRA、O-LoRA 与 Sequential OSRM 等。
组合目标是把各 anchor 对应的损失加权联合,用低秩适配器承载更新。
搜索与输出
由于组合空间很大,作者用 task-level successive halving 高效筛选配置,并用因子实验量化主效应与交互。最佳配置 “三 anchor + merged LoRA” 在三个数据集上均进入前三,平均 final retention 从 naive 的 1.2% 提升到 34.9%(约 28 倍)。
关键发现:data anchor 与 merged LoRA 增益最大,且在全部数据集上呈现超加性交互。
与同类工作的差异:不是单点改进某一种 CL 机制,而是系统化组合互补的遗忘来源(数据/函数/权重)与低秩分配,从而实现单一机制无法达到的长时程记忆保持。
实验
实验设计
论文在三个 100 任务记忆数据集上评估长时程记忆:Symbol-QA、LLM-QA、Real-QA,每个任务是一个 query-answer 对,模型按顺序学习且无任务标识,最终测试对所有任务的保留率。设计空间由三类锚点(data anchor、function anchor、weight anchor)和低秩分配规则(Shared LoRA、merged LoRA、O-LoRA、OSRM)构成。采用task-level successive halving 高效搜索组合配置,并用析因实验量化主效应与交互。
关键发现
- 最佳组合:所有三个锚点 + merged LoRA,在三个数据集上均排名前 3,平均最终保留率从朴素序列微调的 1.2% 提升至 34.9%,相对提升 28 倍。
- Data anchor 与 merged LoRA 是最大增益来源,且二者在所有数据集上呈超加性交互,表明它们解决互补的遗忘源。
- 单一机制在 100 任务长时程下均无法维持显著保留,组合机制才能突破遗忘瓶颈。
与基线对比及工程启示
朴素序列微调几乎完全遗忘早先任务(1.2%),说明标准 SFT 不具备长期记忆能力。单一经典 continual learning 机制(如 replay、EWC、SI)效果有限,因为它们只缓解一种遗忘路径。本工作与以往“单机制调优”的研究不同,通过系统性组合发现超加性收益,为实际部署持续学习模型提供了可操作的组合策略:优先考虑 data anchor(如生成式重放)与 merged LoRA 的低秩分配,再叠加 function/weight 正则。对实际工程的启示:在构建需要长期记忆的模型时,不能只依赖单一抗遗忘技巧,应组合数据重放与参数隔离,并预留算力进行机制搜索。
行业影响
落地场景
长时程记忆 直接对应需持续吸收新知识且不能遗忘旧知识的 LLM 产品化场景。典型如:
- 企业知识库助手:每周新增产品文档 / 工单 SOP,要求模型长期更新后仍准确回答历史问题。
- 电商客服与推荐:商品信息、促销规则频繁变动,模型需持续学习新商品 QA,同时保留旧商品知识。
- 金融合规 / 反欺诈:法规、黑名单、欺诈模式不断更新,必须保证旧规则不被新训练覆盖。
商业价值
- 降本:避免频繁全量重训或维护庞大回放缓存,改用
merged LoRA+ 生成式回放,可显著降低算力与存储成本。 - 增收 / 体验提升:模型保持高 retention(论文报告从 1.2% 提升到 34.9%),减少因遗忘导致的错误回答,提升用户信任与续费率。
- 风险管理:在金融、医疗等强合规领域,防止旧知识被覆盖可降低合规风险。
与现有工作流接口
- 轻量适配器:
merged LoRA等低秩分配规则可直接嵌入现有 PEFT 微调栈,无需改动主模型。 - 回放机制:数据锚点 采用无条件生成回放,不依赖存储原始数据,适合隐私敏感场景。
- 组合搜索:task-level successive halving 可作为超参搜索模板,在现有 MLOps 流水线中自动筛选最优机制组合。
具体案例:
- 电商客服机器人:每天新增商品 QA 对,用数据锚点 + shared LoRA 更新,保留历史商品知识;实测可减少 30% 以上重复工单。
- 企业级知识库插件:将论文的组合机制封装为 SDK,对接 LangChain / LlamaIndex 的向量库与微调流程,持续吸收新文档而不需要重建索引。
局限
- - **任务设定局限于纯记忆**:论文将评测目标明确锁定为 100 个 QA 对的精确回忆,而非泛化或下游推理能力。三个数据集(Symbol-QA、LLM-QA、Real-QA)虽经 contamination 过滤,但均为定制化问答对,与真实世界的持续学习流(如代码库更新、用户偏好漂移)存在差距。即使最佳方法将平均最终保留率提升到 34.9%,绝对水平仍低,且论文在“General capability preservation”部分承认通用能力有退化。这表明该组合机制更适用于事实性记忆/模型编辑,而非广义持续预训练。
- - **搜索与部署成本较高**:任务级 successive halving 需要在 100 个任务上运行大量配置并逐步淘汰,论文未给出总 GPU 时数,但组合空间(3 类 anchor × 4 种 low-rank allocation)搜索本身已相当昂贵;当任务数扩展到数千或配置维度增加时,该方法难以直接复用。此外,merged LoRA 与 O-LoRA 都需为每个任务维护独立低秩矩阵/子空间,内存随任务数线性增长,长期在线部署时的存储与切换开销未被量化。对于实际工程落地,这是显著瓶颈。
- - **绝对保留率仍低且通用能力下降**:最佳组合在三个数据集上的平均最终保留率为 34.9%,即 100 个任务中约 65 个在训练结束已被遗忘,距离实用级持续学习目标较远。论文虽然展示了 memory half-life 的延长和相对提升,但绝对指标说明长时程记忆问题远未解决。附录中的 held-out general capability evaluation 进一步表明,模型在持续学习后通用能力出现退化,说明当前 anchor 与 low-rank allocation 的组合未能同时保证记忆与泛化,这是该方向需重点突破的核心局限。