训练得更聪明,而非更费力:主动学习中的切换信号引导训练
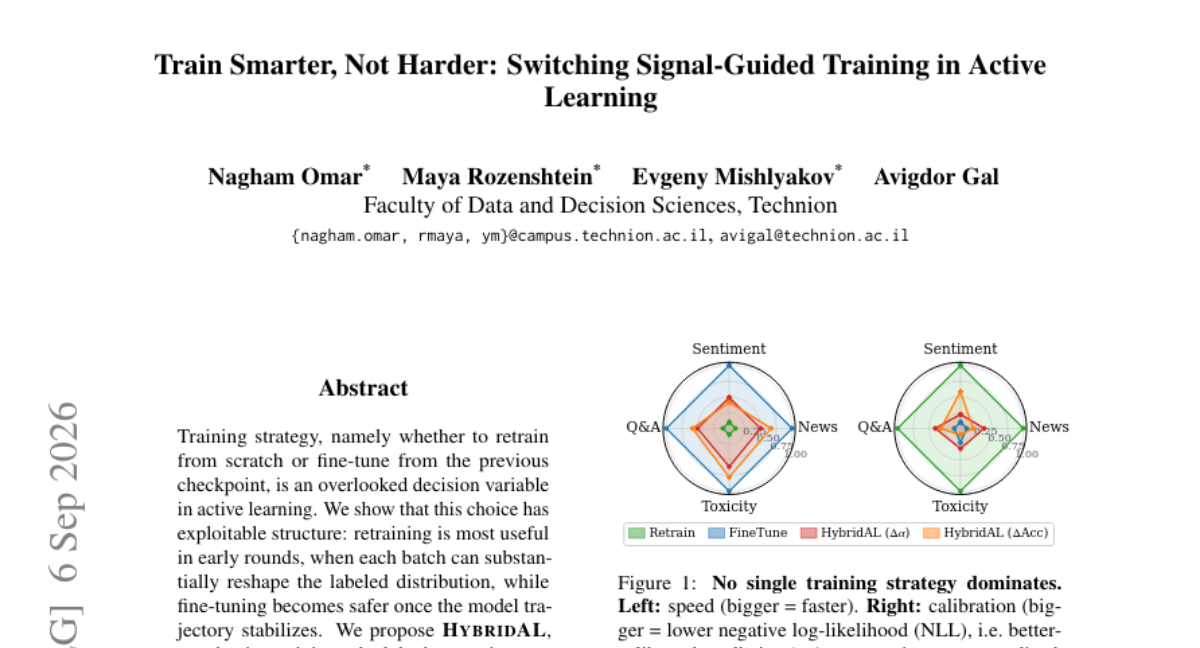
训练策略 选择——是从头重训还是从上一 checkpoint 微调——在 active learning 中一直是被忽视的决策变量。本文表明这一选择具有可利用的结构:重训 在早期轮次最有用,此时每个 batch 都能显著重塑标注分布;而当模型轨迹趋于稳定后,微调 变得更安全。 为此,我们提出 HybridAL,一种自适应训练调度方法:它监控在线稳定信号,在持续稳定后从重训切换为微调。两类互补信号——基于权重的谱指数变化 Δα 与基于验证的准确率变化 ΔAcc——分别落在时间—校准权衡曲线的不同位置。 在三个 encoder backbone 与六个文本分类任务(各五个随机种子)上,HybridAL: - 在 0.010 的 margin 下,终点 macro-F1 不劣于纯重训与纯微调; - 最多节省 49% 的重训时间; - 以 negative log-likelihood(NLL)衡量,恢复了重训校准优势中的相当一部分。 与在预设固定轮次切换的调度相比,HybridAL 以适度的额外开销获得更低的 NLL,说明依赖轨迹的切换能提供比固定早切更强的时间—校准权衡。
论文精读
TL;DR 主动学习中,HybridAL 依据在线稳定信号自适应从 retraining 切换到 fine-tuning,节省最多 49% 训练时间,同时保持 macro-F1 并改善校准(NLL)。
问题
问题背景
主动学习(Active Learning)的核心挑战是以最小标注预算达到目标性能,现有研究多聚焦于采集函数(acquisition function)设计,而训练策略(每轮获取新样本后从零重训 retrain 还是基于上一轮模型微调 fine-tune)常被当作固定超参或默认选项,缺乏系统分析。
现有方法局限
- 全程
retrain:每轮从零初始化模型,计算成本随轮次线性增长,但在标注分布剧烈变化时能避免旧知识干扰; - 全程
fine-tune:训练快,但早期轮次标注池小且分布偏移大,微调易陷入旧检查点局部最优,累积偏差; - 固定轮次切换:如预设在第 k 轮从
retrain切换到fine-tune,无法适应不同任务/数据集的轨迹变化,导致要么过早切换损失精度,要么过晚切换浪费算力。
现有工作缺乏在线监控信号来决定切换时机,也没有量化不同训练策略对端点 F1 和校准(如 NLL)的差异。
为什么这个问题难/重要
难点在于:主动学习每轮新增标注会改变训练分布,模型参数轨迹的“稳定点”不可预知,且不同骨干网络(如 BERT/RoBERTa/DeBERTa)的收敛行为不同。切换过早可能牺牲最终 F1,切换过晚则训练时间收益有限。业界对大模型主动学习场景(医疗文本、法律文书标注)同时关注标注成本和训练算力成本,校准质量(NLL)也影响后续决策置信度,因此自适应训练调度具有实际价值。
行业类比
类似在线推荐系统中处理新交互数据:当数据分布发生显著漂移时,重新训练全量模型比增量更新更可靠;而当用户行为趋于平稳,高频增量更新即可维持效果,需动态权衡更新成本与模型时效性。
核心洞察
- 训练策略在主动学习中存在可利用的动态结构:早期重训、后期微调更优,且切换时机可由模型自身稳定信号在线决定。与以往工作默认单一策略(全重训或全微调)或仅按预设轮次切换不同,本文用**谱指数变化 Δα** 和**验证准确率变化 ΔAcc** 捕捉模型轨迹的稳定性,证明该信号能区分重训收益衰减的临界点,从而在不牺牲 F1 的前提下节省最多 49% 训练时间。
- HybridAL 在时间-校准权衡上显著优于固定时刻切换的 schedule:通过轨迹依赖的自适应切换,在保持宏 F1 非劣(0.010 边际)的同时,获得更低的负对数似然(NLL),恢复重训的校准优势。这一结果说明,稳定信号不仅指示何时可以安全切换到微调,还在校准维度上提供了比固定早期切换更强的上限,为需要良好概率输出的主动学习应用(如不确定性采样、风险敏感决策)提供了实际指导。
方法
HybridAL 方法详解
输入:主动学习中每轮新增的标注批次、当前模型 checkpoint、验证集(仅在使用 ΔAcc 信号时需要),以及上一轮训练后的权重矩阵。
关键模块:
早期重训阶段:算法默认从零开始重训(retrain)。此时标注分布变化大,重训能更彻底地重塑模型表示,避免旧参数对新增标注的偏置。
在线稳定性检测:每轮训练结束后,计算两个可选的稳定性信号:
Δα(谱指数变化):从模型关键层权重矩阵的奇异值谱拟合幂律指数α,比较相邻轮次的α变化。该信号仅依赖模型权重,无需额外验证数据。ΔAcc(验证集准确率变化):在固定验证集上评估模型输出,比较相邻轮次的准确率差。该信号更直接反映泛化稳定性,但需要保留验证集。
切换逻辑:引入耐心窗口(patience),持续监测信号。若信号在连续多个轮次内绝对值低于预设阈值,判定模型训练轨迹已稳定,触发从重训到微调的切换。切换为不可逆,之后所有轮次均使用上一轮 checkpoint 进行微调(fine-tune)。
输出:自适应训练计划,每轮决定执行重训或微调。最终模型在宏 F1 上非劣于纯重训和纯微调,同时节省最多 49% 的重训时间,并通过保留重训的校准优势降低负对数似然(NLL)。
与同类方法的差异:不同于按固定轮次提前切换的策略,HybridAL 利用轨迹相关信号动态定位切换点,从而在时间与校准之间取得更优的折中。
实验
实验设计
评估基于 六个文本分类任务(IMDb、Jigsaw、SST-2、TweetEval、AG News、Yahoo Answers,此处列前五个),覆盖 三个 encoder 骨干,每个配置 5 个随机种子。主动学习循环中,比较 HybridAL 与全程 Retraining、全程 Fine-tuning 以及固定轮次切换基线。切换信号为 权重谱指数变化 Δα 与 验证集准确率变化 ΔAcc。评测指标包括 宏 F1、负对数似然(NLL) 和训练时间。
关键发现
HybridAL 在端点宏 F1 上保持与 Retraining 和 Fine-tuning 非劣(差距 ≤0.010),同时节省最高 49% 的 Retraining 时间。在 NLL 校准 上,HybridAL 恢复了 Retraining 的大部分优势,优于预定义切换轮次的方法;自适应切换在适度额外成本下获得了更低的 NLL。
基线对比解读
全程 Retraining 成本高但校准最佳,全程 Fine-tuning 速度最快但校准可能不足。HybridAL 通过监测 稳定化信号 动态决定切换点,避免了固定提前切换的次优性,在时间与校准之间取得更优 Pareto 前沿;F1 的无损验证了训练策略选择可利用的结构。
行业影响
落地场景
主动学习在标注成本高、数据分布动态变化的业务中应用广泛。HybridAL 提出的自适应训练切换策略,可直接用于以下场景:
- 电商评论情感分类:平台需持续更新模型以适应新商品、新表达。利用主动学习挑选高价值样本标注,训练策略从早期重训切换到微调,节省算力且维持 F1。
- 医疗文本分诊/罕见病识别:标注需要专家参与,成本极高。HybridAL 减少重复训练开销,同时改善 NLL 校准,使预测概率更可靠,适合辅助诊断中的风险控制。
- 内容平台安全审核:新违规模式不断出现,需频繁更新分类器。自适应切换可降低 GPU 占用,加快迭代周期。
商业价值
核心价值在降本与体验提升双线:
- 降本:实验显示节省最高 49% 的重训时间。对于大模型或频繁更新场景,可直接减少云 GPU 费用,或在同等预算下支持更多轮标注迭代。
- 体验提升:校准改善(NLL 下降)意味着模型输出的置信度更可信,有助于下游决策阈值设定,减少误判带来的用户投诉或风险。
- 非劣效保障:在 0.010 边际内保持 macro-F1,打消了工程团队对切换策略可能损害精度的顾虑。
与现有产品/工作流的接口
HybridAL 可作为训练调度器集成进现有 MLOps 流水线:
- 信号采集:在每轮主动学习后,计算
Δα(权重谱指数变化)或ΔAcc(验证集准确率变化)。两者可平衡时间开销与校准需求。 - 切换逻辑:设置耐心窗口,连续若干轮稳定后从 retraining 切换为 fine-tuning。代码已开源(GitHub),可直接嵌入 PyTorch/Hugging Face 训练循环。
- 监控集成:可将稳定信号接入实验跟踪工具(如 Weights & Biases),自动触发切换,无需人工干预。
真实用例:电商平台对商品评论进行细粒度情感分类,初始标注 500 条,每轮主动学习选取 100 条。使用 HybridAL 后,前 3 轮重训,第 4 轮起微调,节省约 40% 训练时间,同时保持 F1 不降,NLL 提升,使下游推荐系统更信任评论情感分数。
局限
- - **不可逆切换与缺乏理论保证**:论文明确承认,从重训练切换到微调后不可逆,若后续主动学习轮次中数据分布发生显著变化(例如采集到高信息量但分布偏移的批次),微调可能无法充分适应,导致性能退化。同时,切换信号基于经验阈值和耐心参数,没有形式化的稳定性收敛证明,只能依赖启发式调参。
- - **验证集依赖与任务覆盖不足**:切换信号之一 ΔAcc 依赖验证集计算准确率变化,但主动学习场景通常标签稀缺,实际中可能难以获得足够大的高质量验证集,若验证集过小则信号噪声增大。实验仅覆盖六个文本分类数据集和三个编码器,任务类型单一,未涉及序列标注、生成或计算机视觉等其他领域,泛化性存疑。
- - **与同类持续学习策略对比缺失**:方法仅在从头重训练和微调两个极端策略之间切换,未与主动学习中已有的增量学习、重放或正则化等持续学习方法直接比较。此外,节省的训练时间上限为 49%,但需额外计算谱指数等信号监控开销,实际净收益可能低于报告值,尤其在小模型或短训练场景下。