Kirin: 从野外视频生成动物运动
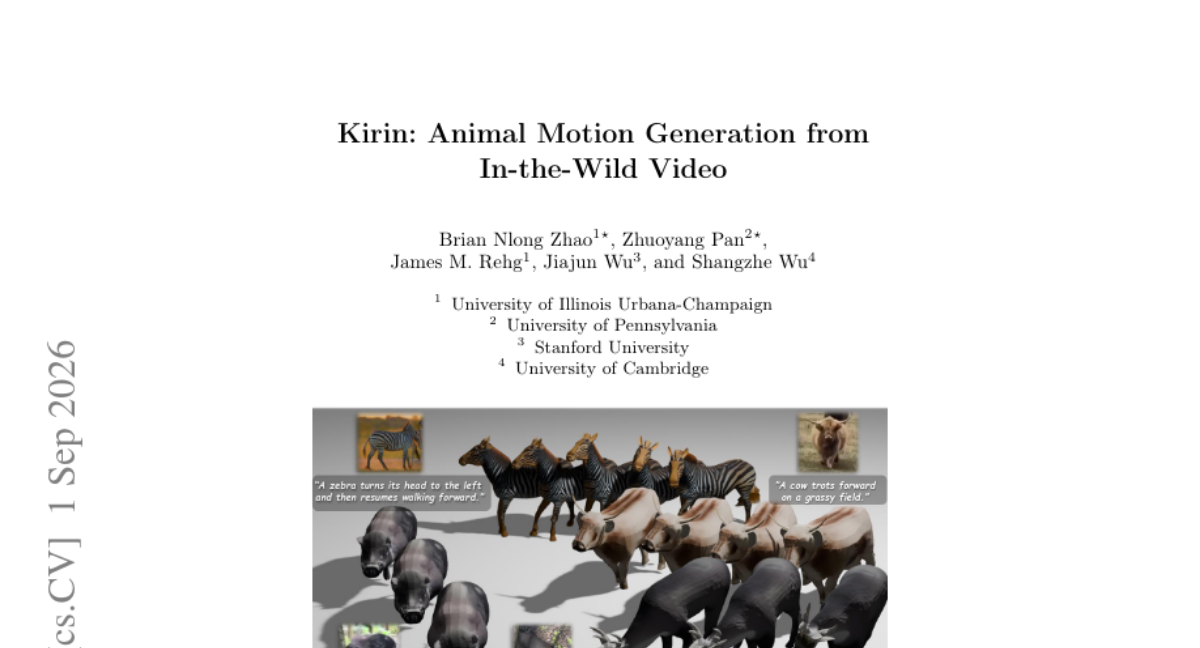
理解动物运动是模拟动物行为和生物力学的基础,然而由于高质量运动数据的稀缺,该领域的研究远落后于人类运动研究。人类运动可以在受控环境中捕捉,但对大多数动物物种来说并不现实,导致数据集规模小且领域受限,限制了动画等下游应用。为应对这一挑战,我们提出 Kirin,一个从视频中重建运动、大规模学习运动先验并生成可直接应用于动画资产的逼真运动的框架。基于大规模野外动物视频集合,我们重建 3D 运动序列并为它们配以文本描述,构建 AiM3D,这是首个为四足动物提供对齐的视频-文本-运动元组的大规模数据集。在此数据集基础上,我们开发了一个视觉引导的运动生成模型,该模型以文本和图像为条件,引导不同动物物种的逼真运动生成。最后,利用现成的图像到 3D 模型,我们使用生成的运动自动绑定并动画化 3D 网格,产出可渲染的动画动物。综合而言,我们的数据集和框架为大规模、文本和图像条件下的动物运动生成与动画奠定了新基础。项目主页:https://kirin-ani.github.io/。
论文精读
TL;DR Kirin 从野生视频重建 3D 动物运动,构建首个视频-文本-运动对齐数据集 AiM3D,并实现文本与图像双条件生成可直接驱动网格动画的运动,解决动物运动数据稀缺问题。
问题
问题背景
动物运动理解是建模动物行为与生物力学的核心基础,但相比人类运动研究,该领域长期受限于高质量运动数据稀缺,进展明显滞后。
现有方法局限
人类运动可通过多视角动捕系统在受控环境采集,但动物难以配合,传统动捕方案几乎不可行。现有动物运动数据集规模小、物种覆盖面窄、标注粗糙,难以支撑大规模生成模型训练。
- 数据层面:缺少视频、文本、3D 运动三元组对齐的大规模数据集,现有数据多为单一模态或小样本量。
- 方法层面:已有动物运动生成方法依赖模板网格或人工先验,对野外视频中的视角变化、遮挡、非刚性变形鲁棒性差。
- 应用层面:生成的运动难以直接绑定到 3D 资产并驱动动画,需要大量手工绑定与重定向工作。
为什么这个问题难/重要
动物运动生成面临双重挑战:重建本身因为野外视频的复杂背景、动态遮挡、多物种形态差异极大而难以准确估计;生成则需要同时建模文本语义与图像外观条件,保持运动物理合理性与物种特异性。
业界关注度持续上升:动画制作、游戏角色、虚拟影视、生物行为模拟等领域都需要低成本、可扩展的动物运动生成管线。人类运动生成(如 MDM、T2M-GPT)的成功证明了规模化数据+扩散模型路线的有效性,但动物领域尚未出现同等量级的数据基础。
行业类比
类似文本到人类动作生成在游戏 NPC 动画、虚拟人驱动中的落地路径,动物运动生成一旦解决数据与绑定自动化,将直接推动生物仿真、AR/VR 内容生产等场景的效率提升。
核心洞察
- 以 in-the-wild 视频为运动数据源绕开动捕瓶颈:Kirin 通过从海量自然视频中重建 3D 动物运动,构建了首个四足动物视频-文本-运动对齐数据集 AiM3D。这一思路避免了传统动捕对动物不可行、室内受控采集造成领域偏差的问题,让运动先验学习可以扩展到多样物种与真实行为,为后续生成模型提供规模化、生态有效的数据基础。
- 视觉引导的生成范式突破纯文本限制:模型同时以文本与图像为条件生成运动,图像模态携带体型、纹理、物种等无法用语言穷尽的约束,使生成的运动与给定外观资产天然对齐。相比仅文本条件的扩散模型,这一设计显著提升了跨物种泛化能力,并通过离线 image-to-3D 模型实现自动绑定与动画,形成从描述到可渲染资产的完整链路。
方法
输入 → 关键模块 → 输出
Kirin 的输入为大规模 in-the-wild 动物视频及对应文本描述。流程分为三个阶段:
运动重建:从野生视频中提取 3D 动物运动序列。作者没有完全公开技术细节,但结合摘要可推断其采用基于优化或回归的 3D 姿态估计,将 2D 关键点提升到 3D 关节角度/骨骼参数,并利用时序平滑约束。重建结果与视频文本 captions 对齐,构建 AiM3D 数据集(首个四足动物 video-text-motion 三元组)。
视觉引导运动生成:核心是一个条件 diffusion model。生成时同时接受文本 prompt 和图像 prompt,图像提供目标外观/物种/姿态参考,文本提供动作语义。模型在 AiM3D 上训练,学习动物运动先验。条件注入方式可能与现有文本-运动扩散模型类似,但加入了图像编码器(如 CLIP)将视觉特征融合到去噪过程。
资产动画应用:用现成的 image-to-3D 模型 生成带骨骼的 3D mesh,然后将生成的运动序列重定向到该 mesh 上,自动完成 rigging 和动画,输出渲染就绪的动画动物。
与同类方法差异
相比仅文本驱动或仅基于小规模 mocap 数据的动物运动生成方法,Kirin 首次利用大规模野生视频重建数据训练,并引入文本+图像双条件,使生成结果既能保持物种形态一致性,又能对齐语言描述,且可直接驱动任意 3D 资产。
实验
实验设计
- 数据集: 构建 AiM3D, 从 in-the-wild 视频重建 quadruped 3D motion, 并配 caption, 形成 video-text-motion 对齐数据。
- 评估任务: 包含 motion generation 定量评估、reconstruction 定量评估、qualitative results 与 ablation studies。
- 基线对比: 与现有 animal motion generation 方法比较(具体 baseline 见论文 Section 4)。指标覆盖 generation quality 与 reconstruction error(如 FID、MPJPE 等,论文正文报告具体数值)。
关键发现
- AiM3D 是首个大规模 quadruped video-text-motion 对齐数据集,缓解高质量动物运动数据稀缺的问题。
- 视觉引导的 motion diffusion 同时利用 text 与 image 条件,可生成跨物种 realistic motion。
- 借助 off-the-shelf image-to-3D 模型,自动 rig 并动画化 3D mesh,形成 ready-to-render 的动物资产。
与基线对比
- 相比仅依赖文本的生成方法,引入图像条件可提供更具体的形态与运动线索,有助于跨物种泛化。
- 从 in-the-wild 视频学习 motion priors,相比受控环境采集的数据集,规模更大且域覆盖更广。
- 但论文未在此摘录给出关键 metric 数值;具体定量结果需查阅正文 Table。
行业影响
落地场景
Kirin 可直接嵌入 3D 资产生产管线,服务游戏、影视、VR/AR 内容团队。典型场景:角色美术师提供静态四足动物模型或文字描述,系统生成行走、奔跑、攻击等多态动画;内容平台批量生成动物虚拟形象短片;电商场景中为宠物配饰生成动态展示素材;教育科普中快速生成动物行为演示。
商业价值
核心降本:传统动物动画依赖动画师逐帧调参或动捕(对多数动物不可行),Kirin 从野生视频重建后生成,成本可降低一个数量级。增收:帮助中小团队扩展动物角色库,缩短制作周期,提升内容上架速度。体验提升:文本 + 图像双条件生成让非动画专业的产品 / 运营人员也能产出可渲染动画资产,降低创作门槛。相比人类动作生成已有成熟工具,动物动作数据长期稀缺,Kirin 填补了 text/image conditioned quadruped motion 的缺口。
与现有工作流集成
可作为动画数据生成插件接入 Blender、Unity、Unreal 或云端 3D asset pipeline。具体步骤:输入 mesh + prompt → 调用 Kirin motion diffusion → 输出骨骼动画或 retarget 到目标 rig → 用 off-the-shelf image-to-3D 模型自动 rig → 导出 FBX/glTF。可与现有 AI 3D 工具(如 Meshy、Tripo)组合,替代手工绑定与 keyframe 环节,适合加入现有生成式 3D 内容管线。
局限
- - **Kirin** 的单目重建环节依赖现成姿态估计模型,在野外视频中常见的遮挡、快速运动、低分辨率、复杂背景等条件下,3D 关节位置容易出现误差。这些误差会进入 **AiM3D** 数据集,并作为生成模型的训练监督,可能传播并放大为不合理运动模式。论文未给出面向极端场景的鲁棒性定量分析,与受控动捕数据在精度和物理合理性上仍存在差距,下游动画可能需额外手工修正。
- - **AiM3D** 仅覆盖四足动物(quadruped animals),未包含鸟类、灵长类、爬行类等运动模式差异显著的类群,生成模型无法通过零样本方式泛化到非四足结构。同时图像条件依赖输入的视觉外观,在参考图与文本描述冲突时,模型可能优先拟合姿态而牺牲多样性;文本条件粒度有限,难以精确控制步态频率、速度、情绪等细粒度属性,限制了行为学研究和动画创作的应用深度。
- - 自动绑定与动画环节利用 off-the-shelf image-to-3D 模型,对非标准网格可能出现蒙皮权重错误、关节错位或骨骼层级不匹配。生成的运动序列缺少碰撞检测、地面接触约束等物理合理性验证,容易产生滑步、脚部穿透等常见动画伪影。论文展示的定性结果可能偏向理想案例,未系统评估不同动物形态、不同网格质量下的鲁棒性,距离生产级 3D 资产自动动画仍有工程差距。