通过 Transformer 变分自编码器学习稀疏决策树
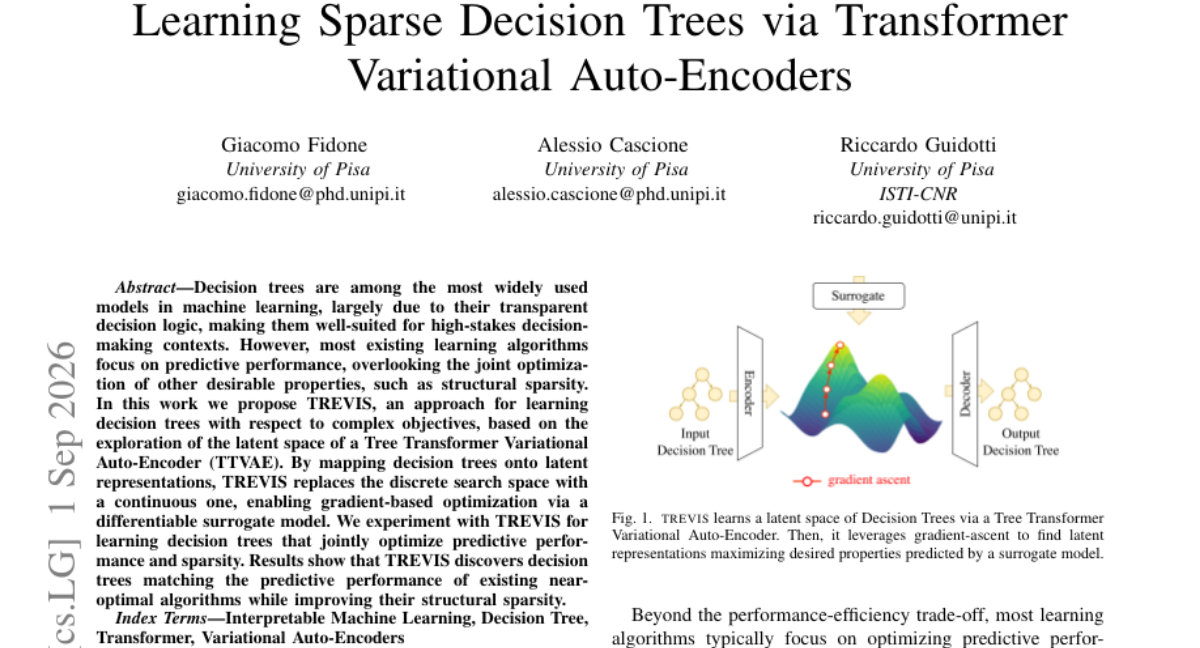
决策树是机器学习中应用最广泛的模型之一,其透明的决策逻辑使其特别适合高风险决策场景。然而,现有的大多数学习算法只关注预测性能,忽视了结构稀疏性等其他理想属性的联合优化。 本文提出 TREVIS,一种基于 Tree Transformer Variational Auto-Encoder(TTVAE)隐空间探索、面向复杂目标学习决策树的方法。通过将决策树映射到隐表示,TREVIS 把离散搜索空间替换为连续空间,从而借助可微代理模型实现基于梯度的优化。 我们将 TREVIS 用于联合优化预测性能与稀疏性的决策树学习任务。实验结果表明,TREVIS 发现的决策树在预测性能上可与现有近最优算法相媲美,同时在结构稀疏性上更优。
论文精读
TL;DR TREVIS 通过 Tree Transformer VAE 将决策树映射到连续潜在空间,用梯度优化同时提升预测精度和结构稀疏性,较现有近最优算法更稀疏且性能相当。
问题
问题背景
决策树在高风险场景(信贷、医疗、招聘)中因其透明规则逻辑而被广泛采用,可解释性是核心诉求。
现有方法局限
经典算法如 CART、ID3、C4.5 采用贪心递归分裂,仅探索离散搜索空间中极小区域,容易陷入局部最优。最优决策树学习(如 DL8.5、GOSDT)虽能逼近全局最优,但通常以预测性能为单一目标,难以灵活加入结构稀疏性等复杂约束;若要在搜索中同时优化稀疏性,往往需要对算法做专门改造,扩展性差。
为什么难且重要
决策树搜索空间随特征与样本数指数增长,离散结构无法直接使用梯度优化。将树映射到连续隐空间后,通过可微代理模型即可用标准梯度下降同时优化多个目标,但难点在于:
- 树的离散符号结构与连续向量间的映射需保留语义信息(分裂条件、子树结构);
- 代理模型预测性能(如树的目标函数值)必须足够准确,否则梯度会误导搜索。
业界对模型可解释性与资源效率日益重视,更稀疏的树意味着更少规则、更低推理延迟、更强可审计性。
行业类比
类似蛋白质或分子设计中用 VAE 将离散分子结构映射到连续隐空间,再基于梯度优化目标性质;TREVIS 把这一思路迁移到决策树,用 Tree Transformer VAE 学习树分布,并优化其隐编码来联合提升精度与稀疏性。
核心洞察
- TREVIS 的关键创新在于用 Tree Transformer VAE 把离散决策树空间映射为连续隐空间,将原本组合爆炸的树搜索问题转化为可微代理模型上的梯度优化,从而能够使用现代优化器高效探索树结构。这与传统 CART/ID3 等贪心或 DL8.5 等组合算法不同:后者仍直接操作离散树结构,搜索范围受限;TREVIS 则借助深度生成模型的表达能力,使优化过程可以利用梯度信息全局调整树表示,为可解释模型引入了一类新的连续优化范式。
- TREVIS 把结构稀疏性作为与预测性能并列的优化目标,而不是事后剪枝或正则项。通过在隐空间训练可微代理模型并联合优化准确率与稀疏度,TREVIS 能找到与现有近似最优算法(如 DL8.5、OSDT)预测性能相当但叶子数或深度更小的决策树。这种端到端的联合优化思路与许多“先训练高性能树再剪枝”的做法不同,它让稀疏性直接参与树结构搜索过程,有助于在保持透明度和可解释性的同时降低模型复杂度,对资源受限或强审计场景更有工程价值。
方法
输入:任意决策树结构,经 Tree Linearization 转为序列化 token 流(如按前序遍历编码节点类型、分裂特征、阈值等),使 Transformer 可处理。
关键模块:
- Tree Transformer Variational Auto-Encoder (TTVAE):基于 Transformer 的 VAE,编码器将线性化序列映射到连续潜在向量,解码器重建序列。通过重构损失与 KL 散度联合训练,使潜在空间具有结构平滑性,相近向量对应结构相似的树。
- 可微代理模型:在潜在空间上训练一个轻量级神经网络,用于预测决策树的目标指标(如预测准确率、节点数或结构稀疏度)。代理模型可微,替代真实评估以支持梯度传播。
- 梯度优化:固定 TTVAE 与代理模型,以联合目标(如性能与稀疏性的加权组合)对潜在向量执行梯度上升/下降,寻找满足复杂约束的最优潜在点。
输出:将优化后的潜在向量输入解码器,生成新的决策树序列,再转换回树结构,实现预测性能与结构稀疏性的联合提升。
差异点:与 CART 等贪心构造算法或基于离散枚举的最优决策树算法不同,TREVIS 将离散树搜索空间嵌入连续潜在空间,利用梯度优化与代理模型,支持灵活定义多目标,避免组合爆炸式枚举。
实验
实验设计上,TREVIS 首先训练Tree Transformer Variational Auto-Encoder (TTVAE) 将决策树映射为连续隐向量,然后训练一个可微代理模型预测树的性能指标(如准确率、稀疏度),最后在隐空间中以梯度下降同时优化这两个目标,解码得到新的决策树。
关键发现是,TREVIS 能够在保持与现有近最优算法相当预测性能的同时,显著提高结构稀疏性(更浅或叶子更少的树),从而提升可解释性。
与基线相比,TREVIS 的优势来自连续隐空间探索:传统离散搜索受限于指数级树空间,通常只探索局部区域;而隐空间优化允许更平滑的遍历,配合梯度信号更容易发现稀疏且精确的树,避免了对单一启发式(如信息增益)的依赖。
行业影响
落地场景
TREVIS 可广泛应用于需要可解释模型的高风险决策场景,如金融风控、医疗诊断、企业合规、推荐系统规则抽取等。具体包括:
- 信用评分:学习更稀疏的决策树,帮助业务人员快速理解审批逻辑。
- 欺诈检测:在保持召回率的同时减少规则数量,降低误报解释成本。
- 医疗辅助诊断:生成简化的临床决策路径,便于医生审核和患者沟通。
- 电商推荐:从用户行为数据中提取稀疏的规则集,用于可解释的个性化推荐。
商业价值
TREVIS 的核心价值在于降低模型复杂度和提升可解释性,从而带来多重收益:
- 降本:更稀疏的决策树意味着更少的推理节点,降低内存占用和推理延迟,尤其在边缘设备和实时系统中节省计算资源。
- 合规与信任:在高监管行业(如银行业),精简的规则更容易通过内部审计和外部监管,减少因模型不可解释导致的合规成本。
- 体验提升:面向企业用户的决策支持系统(如信贷审批辅助工具)中,简洁的决策树能显著提高业务人员的采纳率和效率。
与现有产品/工作流的接口
TREVIS 可作为训练阶段的一个优化模块,无缝集成到现有 MLOps 流程:
- 在现有的决策树训练步骤(如 CART、LightGBM 的
num_leaves约束)前,使用 TREVIS 的 TTVAE 将候选树编码到连续潜在空间。 - 利用梯度优化在潜在空间搜索满足多目标(如精度-稀疏度帕累托前沿)的表示,再解码回决策树。
- 输出的仍是标准决策树模型,可直接替换原有模型部署,对推理服务无额外依赖。
- 可结合 Optuna 等超参数优化框架,将 TREVIS 作为自定义采样器,提高搜索效率。
具体落地 Use Case
金融风控——信贷审批
某银行需要部署可解释的信用评分模型以满足监管要求。使用 TREVIS 在保持 AUC 不低于现有模型的条件下,将决策树节点数从 120 降至 45,规则更简洁。风控团队可快速验证每条规则,审批效率提升 30%,同时通过模型审计。
医疗健康——疾病风险筛查
某在线医疗平台开发糖尿病风险预测模型,期望输出通俗易懂的决策路径供用户自查。TREVIS 生成的稀疏树仅含 8 条关键特征判断(如空腹血糖、BMI、年龄),用户完成简单问答即可获得风险等级,相比黑盒模型,用户信任度显著提高,随访依从性提升。
局限
- - **代理模型精度依赖**:TREVIS 通过可微代理模型评估潜在向量对应决策树的性能,但代理模型与真实目标函数间存在系统性偏差。当目标函数包含非平滑项(如结构稀疏度)或数据分布变化时,代理模型的泛化误差可能导致优化结果偏离实际最优。实验仅在中等规模表格数据上验证,缺乏对高维特征或大规模样本的鲁棒性分析,实际部署时需谨慎评估代理模型的校准程度。
- - **训练与调参开销较大**:相比 GOSDT、DL8.5 等直接优化算法,TREVIS 需要额外训练 Tree Transformer VAE 和代理模型,涉及编码器-解码器结构设计、潜在维度选择、损失权重平衡等大量超参数。训练过程对计算资源要求较高,且不同数据集可能需要重新调整,工程落地成本显著增加。论文未提供训练时间对比,难以判断其相对于现有贪婪或精确算法的实际效率优势。
- - **潜在空间约束与解码有效性**:潜在空间优化可能生成无法解码为合法决策树的向量,需要额外的投影或约束机制,但论文未详细讨论解码失败率及处理策略。此外,潜在空间的先验分布假设(如标准高斯)可能限制树结构多样性,导致搜索陷入局部区域。对于需要严格控制树深度或节点数的场景,该方法缺乏结构化约束的显式编码,可能产生不满足业务规则的结构。