A Glance Is All You Need: Single-Pass Fine-Grained Image Captioning with SimLoss
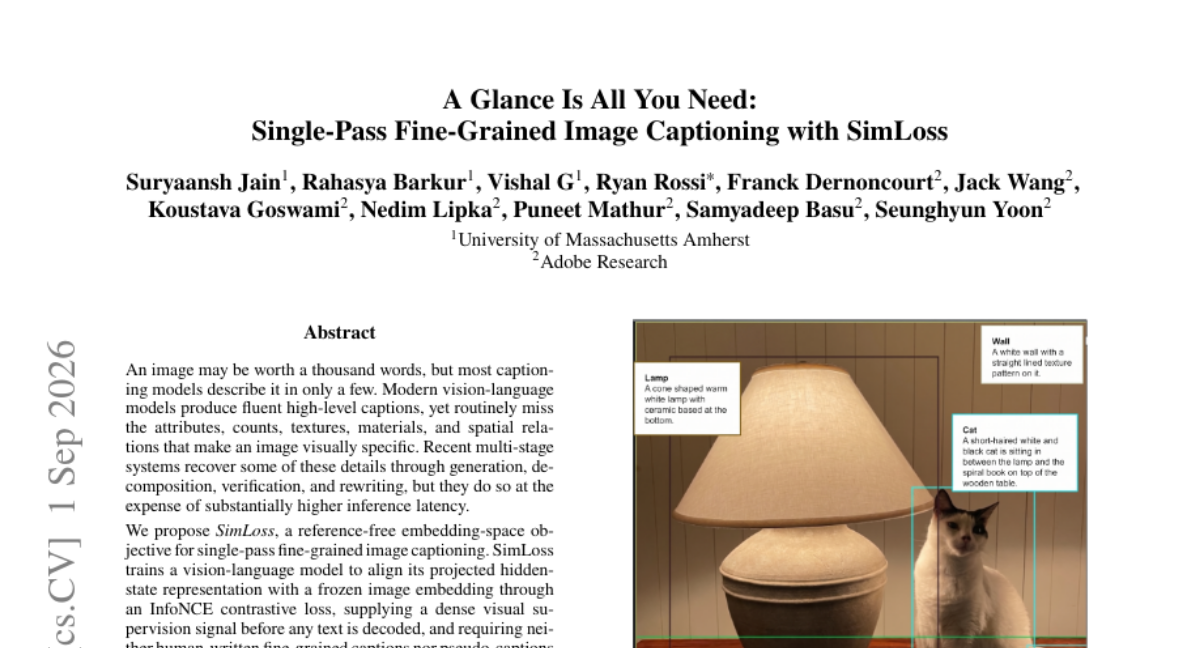
一张图片或许抵得上一千个词,但大多数图像描述模型只能生成寥寥数语。现代视觉-语言模型能够产出流畅的高层次描述,却常常遗漏让图像在视觉上独特具体的属性、数量、纹理、材质和空间关系。近年来的多阶段系统通过生成、分解、验证和改写,部分恢复了这些细节,但是以显著增加推理时延为代价。 我们提出 SimLoss,一种无需参考标注的嵌入空间目标函数,用于单次前向的细粒度图像描述。SimLoss 训练视觉-语言模型,使其投影后的隐藏状态表示与冻结的图像嵌入通过 InfoNCE 对比损失对齐,在解码任何文本之前提供密集的视觉监督信号,并且既不需要人工编写的细粒度描述,也不需要来自多阶段流程的伪描述。我们将其实例化为 SimLoss FFT(通过本地可用的嵌入模型进行反向传播)和 SimLoss GRPO(将该嵌入模型视为黑盒奖励)。 与单次前向、多阶段验证、奖励优化和感知感知基线相比,完全可微的微调变体 SimLoss FFT 实现了最高精确率,同时其 F1 分数几乎与多阶段方法持平,而且保持单次前向推理速度,运行速度比多阶段流程快约 20 倍。奖励变体 SimLoss GRPO 取得了最强召回率。 这些结果表明,嵌入空间监督能够在单次前向描述器的时延下恢复多阶段验证的质量。
论文精读
TL;DR SimLoss 用 embedding 空间对比监督训练单次推理的细粒度图像描述模型,在不牺牲精度的情况下将延迟降至多阶段方法的约 1/20,重构了质量-速度权衡。
问题
问题背景
视觉-语言模型在图像描述任务上已能生成流畅的高层摘要,但实际应用对 细粒度覆盖 与 低延迟 同时提出要求。
现有方法局限
- 单遍 captioner 倾向生成概括性描述,遗漏属性、计数、纹理、材质及空间关系等视觉细节,信息损失明显。
- 多阶段 pipeline(如 CapMAS:生成 → 分解 → 验证 → 重写)虽能提升细节覆盖,但需多次 LLM / VLM 调用,推理延迟呈数量级增长,难以服务在线场景。
- 奖励优化方法 依赖 LLM-judge 或伪 caption 提供监督,信号脆弱,且需要额外数据或模型,部署成本高。
为什么难/重要
核心挑战在于:如何在不引入多阶段推理的前提下,为单遍模型提供足够密集的视觉监督信号?预训练模型隐状态与图像嵌入的跨模态对齐缺乏显式参考,直接优化容易导致模式坍塌或语义漂移。业界高度关注将高质量细粒度描述压缩到单次前向计算中,因为这对降低 serving 成本与延迟有直接价值,是实际产品落地的关键瓶颈。
行业类比
类似实时视频理解场景:若每帧都需多轮验证再输出描述,无法满足流式处理的时延要求,必须找到单遍高质量生成方案。
核心洞察
- SimLoss 将细粒度图像描述从多阶段验证重构为 embedding 空间对比学习目标,使单遍 captioner 在解码前就与冻结图像 embedding 对齐,无需人工细粒度标注或伪标签。与 CapMAS 等多阶段 generation-decomposition-verification-rewriting 管线相比,SimLoss 通过 InfoNCE 损失将 VLM 投影隐状态与图像 embedding 的相似度作为参考无关监督,避免了多轮 LLM/VLM 调用和伪标签噪声,却能在单次前向中保留属性、计数和空间关系等细粒度信息。
- SimLoss 的两个变体 FFT 与 GRPO 揭示了 embedding 奖励在优化路径上的差异:FFT 通过可微反向传播获得精确梯度,提升 precision 并生成更简短 caption;GRPO 将 embedding 模型视为黑盒奖励做策略优化,提升 recall 但引入更多冗长和误报。这一对照与常见使用 LLM judge 作为奖励的 RLHF 方法不同,embedding 奖励计算廉价且信号稳定,FFT 的精确梯度促使模型学习高效的视觉编码,而 GRPO 的奖励最大化则倾向于覆盖更多视觉元素,导致召回高但精度下降。
方法
输入
SimLoss 训练时使用图像及其对应的普通高层字幕(无需人工细粒度标注或伪字幕),核心监督信号来自冻结的图像嵌入模型(如 CLIP)。
关键模块
- 嵌入空间对齐目标:在 VLM 解码文本之前,将其投影后的隐藏状态与同一图像的冻结嵌入进行对比。采用 InfoNCE 对比损失 拉近正样本对(图像-对应隐藏状态)并推远负样本,从而提供逐 token 之前的密集视觉监督。
- 可微变体 SimLoss FFT:反向传播穿过本地嵌入模型,同时更新 VLM 和投影层,实现端到端优化,使生成的隐藏表示更贴近视觉语义。
- 强化变体 SimLoss GRPO:将冻结嵌入模型视为黑盒奖励函数,用 GRPO 策略优化 VLM,允许在嵌入模型不可微或不可访问梯度的情况下训练。
输出
训练后的 VLM 在单次前向推理中直接生成高精度、视觉特异性强的细粒度字幕,无需多阶段生成-验证-重写流程,推理延迟大幅降低(约为多阶段管道的 1/20)。
与同类方法差异
与多阶段验证系统(如 CapMAS)或感知感知优化(PAPO)不同,SimLoss 完全在嵌入空间中操作,不依赖额外推理步骤或冗长的奖励分解,将多阶段验证的质量压缩到单遍生成中。
实验
实验设计
论文对比了单 pass 基线、多阶段验证管线 CapMAS、奖励优化 FeedQuill、感知感知策略 PAPO 以及提出的 SimLoss FFT 与 SimLoss GRPO。训练数据与模型细节未在摘录中给出。评估重点为 precision、recall、F1 及推理延迟。
关键发现
- SimLoss FFT 取得最高 precision,同时 F1 接近多阶段 CapMAS,且保持单 pass 推理,速度约为多阶段管线的 20 倍。
- SimLoss GRPO 大幅提升 recall,但 precision 略低,体现黑盒奖励优化与全可微微调之间的差异。
- 多阶段 CapMAS 在 F1 上仍有轻微优势,但代价是极高延迟。
与基线对比解读
SimLoss FFT 通过 embedding 空间对比损失提供密集视觉监督,无需多阶段生成-验证-改写,因此在精度上直接对齐详细描述,同时避免额外的推理步骤。SimLoss GRPO 将 embedding 模型作为黑盒奖励,更偏向召回,可能因奖励信号稀疏或噪声导致 precision 下降。整体上,SimLoss 系列在质量-延迟权衡上显著优于多阶段和奖励优化基线,证明单 pass embedding 监督足以复现大部分多阶段验证的收益。
行业影响
落地场景
SimLoss 适用于需要 单次推理生成高细节描述 的产品线,典型场景:
- 电商商品详情生成:对商品图输出材质、颜色、数量、空间位置等细粒度属性,代替人工标注或简化后处理。
- 内容平台无障碍 alt-text:社交媒体 / UGC 平台自动生成包含对象关系和属性的 alt 文本,提升可访问性与 SEO 效果。
商业价值
降本 最直接:SimLoss FFT 在精度最高且 F1 接近多阶段方法的同时,推理延迟约为多阶段流程的 1/20,意味着同等 GPU 配额可处理约 20 倍图片量,显著降低单张 caption 的推理成本。
体验提升:更精确的属性描述能改善搜索相关性、推荐匹配率和辅助功能质量,可能带来转化率与留存提升。
增收:电商场景中,更细粒度的商品属性能提升长尾搜索命中,减少因描述缺失导致的退换货。
与现有产品/工作流的接口
SimLoss 可作为现有 single-pass captioner 的微调目标直接嵌入:
- 依赖轻:不需要人工细粒度 caption 或伪标签,只需一个冻结的图像嵌入模型(如 CLIP / SigLIP)。
- 两种集成路径:若嵌入模型可本地反向传播,使用
SimLoss FFT;若嵌入模型为黑盒或 API,可用SimLoss GRPO作为 reward 优化,适合已有 RLHF / GRPO 训练框架的团队。 - 推理零改动:训练后模型保持单次前向,便于替换现有 VLM caption 服务,支持在线实时生成。
局限
- **嵌入空间监督的局限性**:SimLoss 的核心假设是模型隐藏状态与冻结图像嵌入能在同一语义空间对齐,从而提供密集视觉信号。但该方法的有效性高度依赖嵌入模型对细粒度视觉属性的编码能力。若所用嵌入模型对物体属性、纹理、空间关系等细节不敏感,则对比学习目标可能无法充分传递这些信息,导致监督信号存在偏差。论文未系统分析不同嵌入模型对性能的影响,这限制了方法在嵌入模型更换时的鲁棒性和可迁移性。
- **精度与召回的权衡**:SimLoss FFT 在精度上最优,SimLoss GRPO 在召回上最强,但两个变体似乎无法同时获得最佳精度和召回。摘要提到 FFT 的 F1 分数仅“接近”多阶段方法,并未完全超越,说明在需要全面覆盖细节的场景中仍有差距。此外,GRPO 虽然召回高,但精度较低,可能导致生成描述中出现更多错误或不准确信息。这种 trade-off 需要用户根据具体应用场景在精确性和完整性之间做出选择。
- **评估与泛化性**:论文主要评估了在特定数据集和指标(如 CLAIR、命题验证等)上的表现,但对模型在不同分布图像、长尾概念或复杂场景下的泛化性讨论不足。此外,尽管单遍推理大幅降低了延迟,但训练过程中需要额外的嵌入模型进行对比学习,增加了训练复杂度和资源需求。另外,幻觉抑制能力是否因对齐嵌入而得到实质改善,论文未给出明确验证,可能仍有生成与图像不符内容的风险。