Token-Efficient Data Reasoning Agents via Adaptive Structuring of Unstructured Data
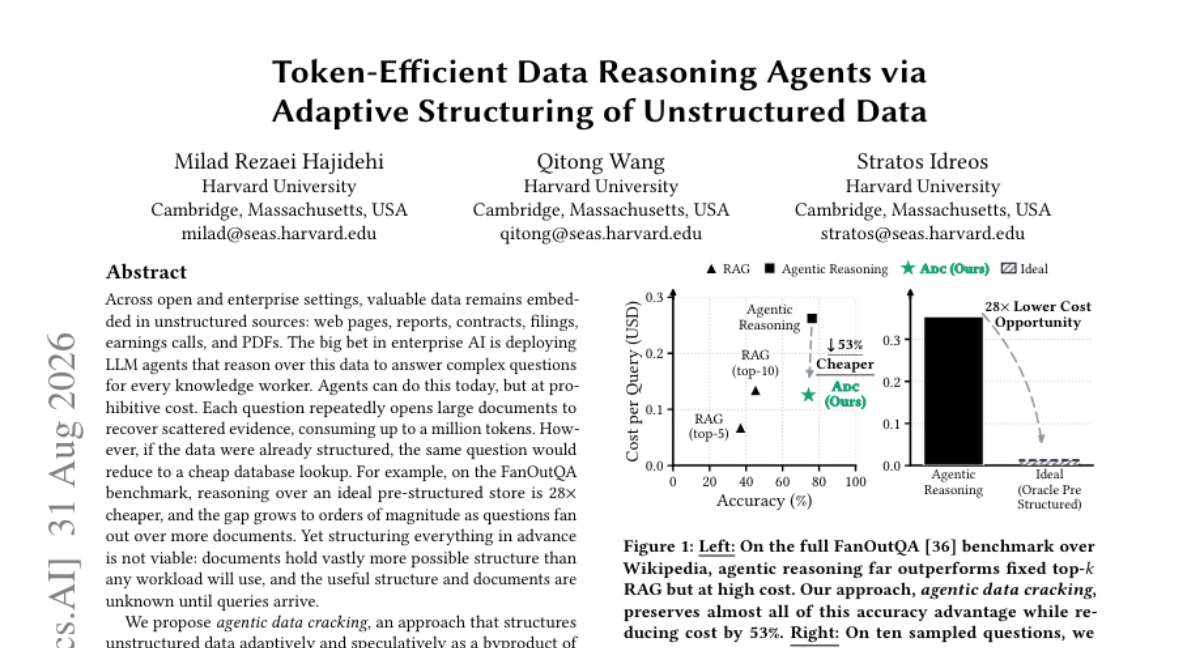
企业数据中大量价值仍深埋于非结构化来源:网页、报告、合同、申报文件、财报电话会与 PDF。企业 AI 的核心赌注,是让 LLM 智能体对这类数据进行推理,为每个知识工作者解答复杂问题。当前智能体虽能完成此类任务,但代价高昂:每个问题都会反复打开大型文档以寻找分散的证据,一次消耗可达百万 token。 核心观察 是:若数据已被结构化,同类查询即可退化为一次廉价的数据库检索。例如在 FanOutQA 基准上,基于理想预结构化存储进行推理可便宜 28 倍,且当问题需要跨更多文档展开时,差距更可扩大至数个数量级。然而预先结构化一切并不现实——文档中蕴含的结构远超任何工作负载实际会用到的部分,且真正有用的结构与文档在查询到达前并不可知。 为此我们提出 agentic data cracking(智能体式数据裂解):一种将非结构化数据以自适应、推测性方式结构化的方法,且这种结构化是推理过程的副产品。其适应性体现在:由实际查询决定何时发生结构化、什么才算重要;其推测性体现在:结构化会超越当前问题本身。每当智能体打开文档回答问题,一个 cracking 子智能体 会从已加载的上下文中分叉出来,以边际成本提取扎根于原文的结构化知识,用于满足未来可能的相关查询。 随时间的推移,逐渐增多的查询将完全由结构化数据覆盖,无需再打开原始文档即可回答——使智能体精度维持在接近 RAG 的成本水平。在 FanOutQA 上,仅需在每个测试问题后附加一个相关问题,cracking 即可在保持精度的前提下降低 53% 的成本。Agentic data cracking 是为面向非结构化数据的智能体推理构建下一代数据基础设施的第一步:在模型之下构建一个共享基座,让推理已付出代价挖掘出的知识得以在此沉淀。
论文精读
TL;DR 提出 agentic data cracking,让 LLM agent 在开文档推理时顺手提取可复用的结构化数据,后续类似查询直接查表而免开文档;在 FanOutQA 上仅加一个相关问题即降本 53% 且精度不变。
问题
问题背景
当前企业级 AI 的核心叙事是部署 LLM agents 对非结构化数据(网页、报告、合同、PDF)进行推理,以回答复杂问题。但每次查询都重复打开大型文档,消耗大量 token,成本高昂。
现有方法局限
- 直接 agent 推理:每次回答都从头读取相关文档,证据分散时需重复加载上下文,FanOutQA 上单查询可消耗近百万 token,成本不可接受。
- 预先全量结构化:将文档一次性转换为结构化存储(如关系表)虽可将查询降至数据库 lookup 成本(理想情况下便宜 28×),但文档可能蕴含的结构远超实际 workload 需要的,且有用结构在查询到达前未知,全量转换既不可行也极度浪费。
为什么这个问题难/重要
技术难点在于:需要在不显著增加单次推理成本的前提下,根据已观察到的查询 动态决定何时结构化、结构化什么,并让提取的结构能被后续相关查询复用。这要求系统具备自适应和推测能力,同时保证提取的结构是grounded(有依据)且对未知查询有用。业界关注度极高,因为 token 成本是 agent 规模化落地的核心瓶颈;若能将 agent 推理成本拉近 RAG 水平而保持准确性,将直接改变企业数据架构的 ROI 模型。
行业类比
这类似于数据库领域从静态索引转向 adaptive indexing / database cracking:不预先建立所有可能索引,而是根据实际查询负载逐步构建,使系统随使用而优化。
核心洞察
- 该工作把数据库 cracking 范式迁移到 LLM agent 推理中,用查询工作负载驱动非结构化数据的自适应结构化。与预先 ETL 全量结构化不同,它不试图提前覆盖所有可能结构,而是在 agent 打开文档时根据当前查询“裂解”出相关结构,并投机地扩展到潜在未来查询。这种按需、增量的结构积累避免了大规模前期投入,同时逐渐把后续查询转化为廉价的结构化查找,从架构上弥合了 pure RAG 与理想预结构化数据库之间的成本鸿沟。
- 该方法的核心经济性来自“已加载上下文的边际成本”:cracking sub-agent 从主推理流程 fork 出来,利用已经支付 token 的文档内容提取额外结构,而不是为结构化单独打开文档。这使每次推理都沉淀出可共享的知识资产,存入统一 substrate,后续查询直接受益。这区别于单纯的缓存或提示压缩,因为它不仅重用结果,还主动扩展数据 schema,形成“系统越用越便宜”的正反馈,为多租户场景下的知识积累提供了新机制。
方法
输入 → 关键模块 → 输出
输入:非结构化数据源(web pages、reports、contracts、filings、earnings calls、PDFs)与到达的复杂问题。
关键模块:核心是 agentic data cracking,受数据库 cracking 与自适应数据系统启发。当 agent 为了回答而打开文档时,从已加载上下文 fork 出一个 cracking sub-agent,以边际成本提取 grounded structure(有依据的结构),这些结构可能服务于未来相关查询。结构化是 自适应 的:由观察到的查询决定何时发生、哪些内容重要;也是 推测性 的:提取范围超出当前问题。提取出的结构累积到共享 substrate 中,后续查询若被覆盖则直接查结构化数据,不再打开文档。
输出:一个随查询不断增长、覆盖度提升的结构化存储/索引,使系统在保持 agent 精度的同时逼近 RAG 成本。在 FanOutQA 上,仅增加一个相关问题,该方法降低 53% 成本且保持精度;对比理想预结构化 store 的开销差距逐步缩小。
差异点:与预先全量结构化(成本不可行)和传统 RAG(每次重读文档)不同,该方法将结构化作为推理副产物,按需增量构建,实现 token 效率与准确性的平衡。
实验
实验设计
- 数据集采用 FanOutQA 基准,并扩展为每个测试问题附带一个相关后续问题,模拟真实负载中的相关查询流。
- 对比方案包括:基准 agentic reasoning(每次查询打开文档)、agentic data cracking(边推理边提取结构化数据)、以及理想预结构化 store(成本下界)。
- 评测指标为 token 成本、准确率、以及结构化数据覆盖查询的比例随查询数的变化。
关键发现
- 仅增加一个相关后续问题,cracking 便使总成本下降 53%,同时准确率保持不变。
- 单题节省分布中,第 10 百分位已达到 9× 成本降低,说明部分查询收益显著大于平均。
- 随着查询推进,结构化数据覆盖份额增长,越来越多查询无需打开文档即可回答,成本逐步逼近 RAG 检索。
与基线对比
- 与纯 agentic reasoning 相比,cracking 利用已加载的上下文在边际成本上提取结构化信息,避免后续重复阅读大文档。
- 理想预结构化 store 成本为 28× 更低,证明结构化是关键;但完全预结构化因工作量未知而不现实,cracking 在可实现性与成本间取得折中。
- 与静态 RAG 相比,cracking 保留 agentic 多跳推理能力,同时通过累积共享结构化数据降低长期成本。
行业影响
落地场景
agentic data cracking 适用于需要跨多份非结构化文档进行复杂推理的企业场景。例如:
- 电商智能客服:用户询问某商品是否适合特定场景,需综合商品详情、用户评价、售后政策等多份资料,传统 agent 需反复打开文档,成本高昂。
- 金融研报分析:分析师提问“对比两家公司过去三年营收驱动因素”,需翻阅多份年报、新闻稿、电话会议记录。该技术在查询过程中自适应抽取结构化事实(如财务指标、事件),后续相似查询可直接命中结构化存储。
商业价值
核心价值在于大幅降低 token 消耗,论文显示在 FanOutQA 上成本降低 53%,且准确率保持不变。这直接转化为企业 RAG/agent 应用的运营成本下降;同时,因减少文档打开次数,响应延迟降低,用户体验提升。长期看,积累的结构化数据形成可复用资产,降低新查询的边际成本。
与现有产品/工作流集成
可作为中间层 插入现有 agent 流水线:在 agent 调用 LLM 读取文档时,并行触发 cracking 子代理,将提取的结构化事实写入现有 向量数据库 或 关系型数据库。无需重构现有 RAG 栈,只需增加一个缓存/索引构建模块。随着查询增多,系统自动将热点知识沉淀为结构化形式,实现“越用越便宜”。
局限
- 论文主要在 **FanOutQA** 基准上评估,且仅通过为每个测试问题增加一个相关问题来模拟后续查询。这种设置偏于理想,未能覆盖真实场景中查询分布动态变化、多轮交互以及文档集合持续更新的情况。实验缺乏对更复杂工作负载(如多跳推理、跨文档聚合)和更大规模数据集的验证,因此方法的泛化性和实际收益仍有待观察。
- **agentic data cracking** 依赖一个 cracking 子 agent 在回答当前问题时提取对未来有用的结构化知识。但论文未深入分析子 agent 提取结构的准确率和召回率,也未讨论当提取的结构存在错误或不完整时,如何避免对后续查询产生误导。这种错误传播风险在长期累积场景下可能抵消成本优势,当前缺乏相应的容错和纠错机制。
- 方法借鉴了数据库 cracking 的自适应索引思想,但 LLM 推理与关系数据库查询存在本质差异:结构化提取的 cost 不可忽略,且结构是否“有用”难以先验判断。论文未与更直接的检索优化、缓存或增量索引方法进行充分对比,也未说明在何种查询分布下 cracking 会失效或反而增加开销。