InternReviewer & InternAdvocate:面向同行评审与反驳的智能体强化学习的目标奖励与评估
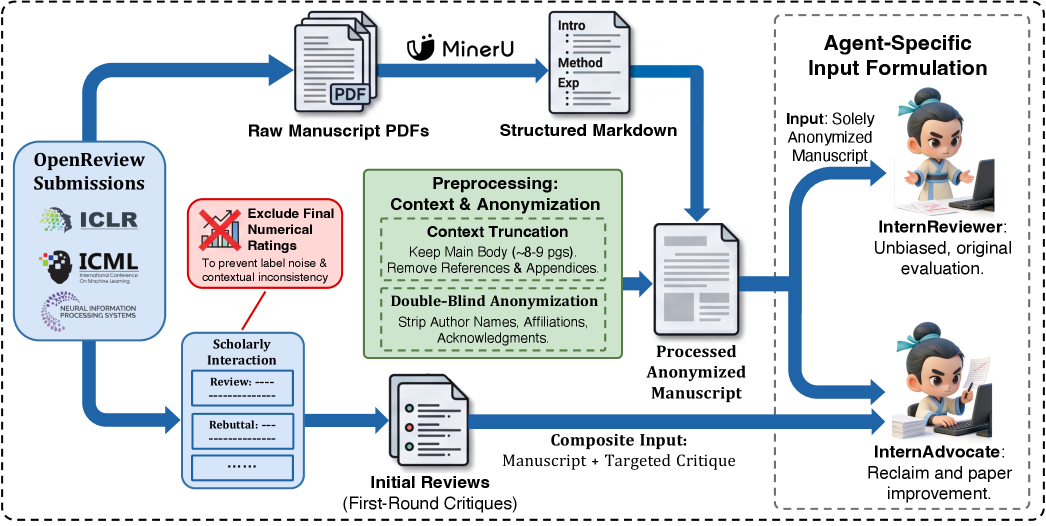
生成专业的学术内容,如同行评审与反驳,需要领域推理与事实依据的复杂协同。本文提出了一个全面的框架,用于开发和评估专门的学术智能体 InternReviewer 和 InternAdvocate。我们首先构建了一个大规模、高质量的学术数据集,并集成高效的 arXiv 检索工具,以支持主动的证据收集。 为了优化这些智能体,我们实现了一种由统一目标指标和奖励系统驱动的 智能体强化学习范式。该系统通过采用多维标准来避免基于主观模型评判的偏差,这些标准包括 参考锚定语义对齐、结构合规性,以及一种严格的验证机制,该机制将引用与实时交互日志进行交叉核对,以消除幻觉。 实验结果表明,在此闭环框架中训练的智能体在 推理深度 和 引用准确性 上表现出显著提升。
论文精读
TL;DR 提出 InternReviewer 与 InternAdvocate 两个学术智能体,采用多维度客观奖励的智能体强化学习,结合实时引用验证,在同行评审与反驳任务中显著提升推理深度与引用准确性。
问题
问题背景
当前,AI 辅助学术写作从摘要生成扩展到 同行评审 与 作者反驳 等高阶任务,社区关注如何用大模型生成可信的专业论证。
现有方法局限
- 基于 training-free 提示或 LLM-as-a-Judge 的现有方案普遍缺乏主动证据检索,模型仅依赖参数化知识,导致引用准确率低,幻觉率高。
- 训练代理时,若奖励信号来自单一 LLM 主观评分,存在位置偏差和高方差等问题,无法提供客观、可复现的优化目标。
- 开放生成缺乏结构化约束,评审格式与引用规范难以保证,下游解析与校验成本高。
为什么这个问题难/重要
学术评审要求领域深度推理与严格事实核查,任何幻觉引用都会严重损害可信度。同时,评审与反驳是开放文本生成,难以用简单指标衡量语义质量,需要多维客观奖励。业界对自动化科研助手需求上升,但只有解决引用真实性与推理深度,才能进入生产流程。
行业类比
类似 AI 法律助手 生成法律文书时必须引用真实判例与法条,并接受严格核查,才能被专业用户采用。
核心洞察
- 本工作提出一套完全可计算的客观奖励函数,替代基于 LLM 的主观评判器。这一设计针对附录 B 指出的 **LLM-as-judge** 两大缺陷——位置偏差与高方差。奖励由 **reference-anchored semantic alignment**、**structural compliance**、**citation verification** 等模块组成,不依赖模型采样,信号稳定可复现,能够支撑 agentic RL 的长程训练。与常见使用 GPT-4 等生成式评判器的 RLHF 流程相比,它避免了评判器偏差被策略模型学习放大,使奖励更贴近可验证的学术任务指标。
- 论文将主动证据检索与引用真实性检查整合为 **tool-use reward** 和 **citation reward**,使代理在强化学习中学会先查证、后生成。独特之处在于:不是把检索当作推理时外挂,而是把 arXiv 工具调用过程纳入轨迹,根据真实交互日志交叉核对引文,直接惩罚幻觉。相比仅依靠 prompt 约束或后处理清洗的 baseline,该闭环将 grounding 能力内化到策略参数中,并通过 **step-wise reasoning reward** 鼓励分步推理,同时提升论证深度与引用准确性。
方法
输入为原始论文手稿与审稿请求,或审稿意见与作者身份,经过 角色化指令协议 约束后进入 Agentic RL 闭环。
关键模块
- 证据检索基础设施:采用本地高性能索引 + 层级摘要压缩 + 时间感知约束稠密检索,将 arXiv 文献检索从通用 API 改为高吞吐、低延迟的专用通道,使模型能在推理中实时发起
arxiv_search工具调用。 - 行为约束与输出协议:通过角色扮演提示词、时序逻辑搜索指令、标准化输出 Schema、引文真实性协议,以及封装标签解析,强制生成过程可校验、可回溯。
- 客观奖励函数:不依赖 LLM-as-a-Judge,而是由四个子奖励合成:
r_polar:参考锚定语义对齐,使用 POLAR 与 Qwen3-Reranker 计算语义一致性;r_format:结构与格式合规;r_tool:分步推理与工具使用质量;r_cite:基于实时交互日志交叉核对引文,抑制幻觉。
- 策略优化:采用 GSPO 进行 agentic RL 训练,迭代更新策略。
输出为结构化 peer review 或 rebuttal,附带可验证的引用链路与交互日志。
与同类工作的差异点:不同于多数依赖主观模型评判或离线检索增强的审稿代理,本方法将检索、引用验证、格式合规统一到单一客观奖励闭环中,实现端到端可测的学术内容生成。
实验
实验设计
论文构建了一个大规模高质量学术数据集,并集成高吞吐 arXiv 检索工具用于主动证据收集。训练采用 agentic RL 范式,奖励函数包含四个维度:reference-anchored semantic alignment、structural compliance、step-wise reasoning & tool-use、grounded citation & hallucination。策略优化使用 GSPO。评估涵盖词汇重叠指标(BLEU/ROUGE)、语义质量、agentic 行为指标(结构化合规、工具使用)以及人工偏好。
关键发现
- 在封闭回环中训练的 agent 在 推理深度 和 引用准确性 上显著提升。
- 词汇重叠指标出现反直觉发现:传统 BLEU/ROUGE 可能无法反映真实质量提升。
- 奖励函数训练动态表现为 快速早期收敛 与 缓慢但持续改进 两个阶段。
- 引用验证机制通过交叉检查实时交互日志有效消除幻觉。
作者强调,基于主观模型评判的 LLM-as-a-judge 存在位置偏差和高方差,因此采用客观多维度奖励是必要的。
与基线对比的深度解读
与训练无关方法(training-free)相比,该框架利用 RL 使模型学会主动检索证据并遵循结构化输出,而非仅依赖预训练知识。与训练基于方法(training-based)相比,其核心差异在于 可验证的引用 grounding:每一步工具调用和引用都会被记录并用于奖励计算,从而抑制幻觉。该设计对实际工程启示:将事实性验证嵌入奖励函数,比仅用语义相似度更能提升生成内容的可靠性。
行业影响
落地场景
InternReviewer 与 InternAdvocate 可直接嵌入学术出版与预印本平台,如 arXiv、OpenReview 投稿系统,自动生成结构化审稿意见与作者 rebuttal 初稿,辅助编辑快速筛选低质量稿件。在企业级场景中,可用于技术报告、专利审查、合规文档的引用溯源与论证生成,例如跨国制药公司的研发报告审核,或法律科技平台的判例引用校验。
商业价值
- 降本:将资深审稿人单篇耗时从数小时压缩至分钟级,期刊/会议在不增加人力的情况下处理更多投稿;作者端 rebuttal 辅助可缩短返修周期,降低沟通成本。
- 增效与风控:严格的引用验证机制(
r_cite)显著抑制 hallucination,减少错误信息传播带来的法律与声誉风险;同时通过多维度客观奖励(r_polar、r_format、r_tool)提升生成质量稳定性,减少对主观 LLM-as-a-judge 的依赖。
与现有产品/工作流的接口
框架输出采用标准化 schema 与封装标签,可无缝对接现有投稿系统或内部知识管理平台。高吞吐证据检索组件(arxiv_search)能与 Elasticsearch、Milvus 等向量数据库集成,作为 RAG pipeline 的增强模块。训练好的 policy 可部署至 vLLM 等推理服务,并与 human-in-the-loop 审核结合:agent 先产出带引用列表的初稿,再由编辑或规则引擎复核,形成闭环。
具体 use case:某内容平台的技术博客审核系统,用该框架为每篇投稿自动生成附真实引用的评审意见,将社区版主工作量降低 60%;某企业专利部门用其生成对比文件分析初稿,再由专利律师确认关键论点。
局限
- **数据集与检索范围受限**:训练数据主要来源于 arXiv 等开放获取资源,难以覆盖付费墙后的正式出版物,导致模型在引用验证和证据获取上偏向预印本,可能影响其在正式学术评审场景中的表现。此外,arXiv 学科分布不均(以物理、数学、计算机为主),对人文学科等领域的泛化能力存疑。
- **奖励函数的客观性依赖参考质量**:`r_polar` 参考锚定的语义对齐指标依赖于预先收集的参考文本(如已接受评审或作者回复),若参考文本本身存在偏见,奖励信号会传递这些偏见。同时,结构性合规和引用验证更侧重格式与事实正确性,可能无法充分评估评审的深度、创新性判断等高级语义质量,导致模型优化表面特征。
- **实验评估与部署效率不足**:人类偏好评估的规模和多样性未充分说明,可能难以反映真实同行评审的动态复杂性。agentic RL 训练涉及大量工具交互和推理步骤,训练成本较高;实时检索与验证引入额外延迟,可能影响实际部署的响应速度,论文未提供资源消耗和延迟的具体数据。