数学推理中 Chain-of-Thought 的 SHAPE
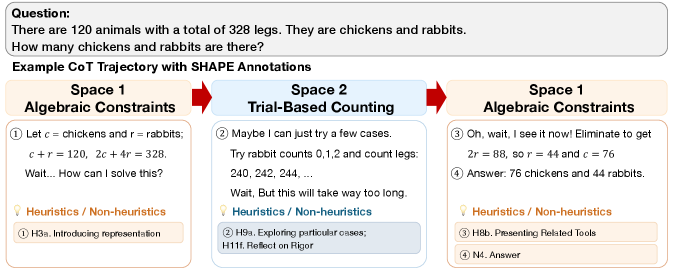
大语言模型(LLMs)在数学推理基准上表现强劲,但其推理背后具有数学意义的技能仍未被充分探索。为此,我们提出 SHAPE 框架,通过数学教育中的两个视角分析 Chain-of-Thought(CoT) 轨迹:(1) 语义空间:模型对问题不断演化的数学解释(如代数、几何);(2) 启发式:模型在这些空间内采取的具体数学行动(如简化问题、逆向工作)。 我们首先使用 SHAPE 分析多种模型的推理模式。结果表明,模型采用的 数学启发式 比传统 CoT 特征更能解释最终答案的正确性;并且,模型更倾向于将推理努力集中在少数几个语义空间,而非分散探索多个不同空间——这一模式与人类行为一致。接着,我们利用 SHAPE 视角评估后训练是否真正提升数学能力,发现 强化学习 导致启发式使用出现 模式寻求(mode-seeking) 现象。 最后,我们通过促进多样化启发式对 LLM 进行后训练,并证明其能有效提升准确率。综上,SHAPE 为解码 LLM 推理提供了有理论基础的诊断框架,也为数学推理中的 LLM 后训练开辟了新路径。代码见 https://github.com/holi-lab/SHAPE-of-CoT。
论文精读
TL;DR 提出 SHAPE 框架,用语义空间与启发式剖析数学 CoT 推理,发现启发式比常规 CoT 特征更能解释正确性,且基于启发式多样性的后训练可提升准确率。
问题
问题背景
LLM 在数学推理基准上已达到较高准确率,但其推理轨迹中蕴含的数学能力仍像一个黑箱。从业者急需理解模型到底运用了哪些可解释的数学策略,而非仅仅关注最终答案。
现有方法局限
传统 CoT 分析多停留在表层特征,例如链长度、困惑度、步骤数或 token 级模式,这些指标与最终正确率的相关性较弱,且无法刻画推理中“做了什么数学动作”。更关键的是,现有分类往往来自通用认知框架,缺少数学教育领域成熟的概念——语义空间(如代数、几何、概率)与启发式(如简化问题、逆向工作、特例代入)的细粒度映射,导致错误诊断流于表面,难以转化为可操作的训练信号。
为什么这个问题难/重要
同一道数学题可以在多个语义空间中被不同表征理解,模型选择哪种空间以及在该空间内执行哪些启发式,直接决定了解题路径是否稳健。仅靠最终奖励的强化学习容易诱导模式坍缩(mode-seeking),使模型过度依赖少数高频启发式,丧失泛化能力。此类“答案对但过程单一”的现象在分布外测试中尤为突出,是当前 LLM 数学推理可信度提升的核心瓶颈。
行业类比
类似对话式推荐系统中只优化最终点击率,却忽略中间解释是否包含多样且合理的用户意图理解——模型可能学会一套固定话术,在未见过的场景中表现脆弱。
核心洞察
- SHAPE 将数学教育中的语义空间与启发式引入 CoT 分析,发现模型采用的启发式比传统 CoT 特征(如序列长度、困惑度)更能解释最终答案正确性。这一角度独特在于,传统 CoT 分析多依赖表层语言统计,而 SHAPE 提供了可解释的数学行为单元,使诊断模型推理短板成为可能。工程上,可将启发式标注模型作为离线评估组件,在部署前识别推理策略缺陷,而不仅仅看准确率。
- 分析揭示正确解答通常伴随模型在少数语义空间内集中推理,而非广泛探索;但后续实验表明强化学习会诱发启发式使用的 mode-seeking,导致多样性下降。作者针对这一矛盾提出显式促进启发式多样性的后训练方法,验证了在 RL 基础上保留多样性可进一步提升准确率。该洞察的独特价值在于连接了人类专家行为与训练动力学,提示奖励设计不应只奖励最终答案,还应保持策略层面的丰富性,为优化推理模型提供了新维度。
方法
SHAPE 方法输入为一段数学推理的 Chain-of-Thought (CoT) 轨迹。核心流程如下:
- 内容单元切分:使用标注模型将轨迹切分为不可再分的推理步骤,每个步骤对应一个数学动作。
- 语义空间标注:判断每个步骤所属的数学语义空间,例如代数、几何、数论等,追踪模型在解决问题时的解释框架变化。
- 启发式标注:根据数学教育中的启发式分类法,为每个步骤打上具体动作标签,如“简化问题”“逆向工作”“代入验证”等。该分类法基于人工构建的 gold standard,并通过共识编码确保一致性。
- 指标计算:基于标签计算各类结构指标,包括启发式多样性、语义空间切换次数、推理专注度等,用于刻画推理模式。
SHAPE 的自动化 pipeline 先由人工标注构建 gold heuristic set,再选择标注模型(开源自选)对大规模 CoT 数据进行标注,流程包括分段、标注、共识校准。输出为每个轨迹的结构化标签序列与聚合统计。
在分析之外,SHAPE 可直接用于后训练:通过 Heuristic-Augmented RL 奖励多样化启发式使用,避免模型陷入单一模式(mode-seeking),从而提升数学推理准确率。
与同类 CoT 分析工作的差异在于:它不依赖表层特征(如步数、困惑度),而是从数学教育理论出发,用语义空间与启发式作为可解释、可干预的分析单元,既能诊断推理结构,又能直接指导强化学习目标设计。
实验
实验设计
SHAPE 框架通过对 CoT 轨迹进行自动标注,将每一步映射到 语义空间(如代数、几何)和 数学启发式(如简化问题、反向推理)。实验分三阶段:
- 分析多种 LLM 在数学推理基准上的推理模式;
- 对比后训练(尤其 RL)前后启发式分布变化;
- 实施 启发式增强的强化学习,奖励使用多样化启发式的策略。
关键发现
- 启发式特征比传统 CoT 特征(如长度、困惑度)更能解释最终答案正确性,说明数学技能本身是决定性能的关键。
- 正确解法往往集中在少数几个语义空间内持续深入,而非在多个空间间频繁跳转,这与人类解题行为一致。
- RL 后训练会导致 启发式使用趋同(mode-seeking),模型丧失探索不同数学策略的多样性。
- 通过显式促进启发式多样性的后训练,可以提升数学推理准确率,验证了 SHAPE 诊断对训练干预的指导价值。
基线对比解读
传统 CoT 分析多关注推理链的表面特征(如步骤数、tokens 长度),难以解释“为何正确”。SHAPE 的启发式维度提供更本质的数学语义解释,与正确答案的相关性更强。对比 RL 模式坍缩,引入多样性正则相当于在优化目标中加入 数学策略熵项,鼓励模型在不同语义空间中灵活选择启发式,而非死记固定路径。这为可解释性和可干预的后训练提供了新视角,工程上可集成到 reward shaping 中,用较小标注成本获取可迁移的启发式标签。
行业影响
落地场景
SHAPE 的核心能力是解析数学 CoT 中的语义空间 (algebraic/geometric)与启发式策略 (simplify/working backward),可直接嵌入 在线数学辅导平台、自适应学习系统、科学计算助手 与 金融量化分析工具。例如,数学教育产品可实时诊断模型解题路径:若模型过度依赖代数操作而忽略几何转化,系统可针对性地提示或切换模型。
商业价值
它提供可量化的推理质量指标,降低端到端错误率,提升用户信任,减少人工审核成本。启发式多样性后训练 能提升基准准确率,同时避免强化学习中的 mode-seeking 坍缩,让模型在复杂问题上更稳健,支撑高价值场景的付费转化与续费。
工作流集成
在现有 LLMOps 中,SHAPE 可作为 CoT 诊断层:调用开源标注模型对生成轨迹打启发式标签,输出 heuristic_entropy / semantic_span 等特征;这些特征可接入 RLHF/GRPO 的奖励塑形,也可作为模型选型与回归测试的门禁指标,兼容 vLLM/transformers 推理栈。
具体用例:某在线数学教育平台发现模型在应用题上频繁使用“代入试错”启发式,导致几何题准确率仅 62%;引入 SHAPE 分析后,通过启发式多样性后训练(鼓励几何语义空间与逆向工作策略),几何题准确率提升至 78%。另一场景中,金融文档分析代理在复利计算任务上过度依赖单一算术步骤,SHAPE 诊断出语义空间集中度过高,团队据此调整 prompt 与采样策略,错误率下降 30%。
局限
- **1. 依赖 LLM 标注的可靠性** SHAPE pipeline 使用 open-weight LLM 作为启发式标注与语义空间跟踪的 annotator,虽然报告了与 gold standard 的一致性,但模型自身 bias 可能造成系统性误判,尤其在启发式边界模糊或语义空间重叠时。这导致分析结果的可信度受限于标注模型能力,推广到其他模型或领域需重新验证标注可靠性。工程上需谨慎对待自动标注的中间结论,建议引入人工抽检或 ensemble 标注以降低错误传播风险。
- **2. 实验范围与泛化性局限** 论文主要聚焦数学推理任务(如 GSM8K、MATH),使用的启发式 taxonomy 源自数学教育,对代数、几何等语义空间有效,但能否迁移到代码、科学或其他推理任务未经验证。跨领域应用可能需要重新设计分类体系,增加了框架的通用性成本。此外,实验未涉及更大规模或闭源模型,结论可能受限于当前模型能力。工程启示:在非数学领域部署前,需针对领域特性调整启发式类别并验证语义空间覆盖度。
- **3. 评估指标单一与相对优势不明** 论文以最终答案正确性为主要指标,未深入分析中间推理步骤质量、CoT 长度或推理成本。post-training 促进多样化启发式虽提升准确率,但可能使 CoT 变得冗长,增加推理开销。此外,未与 self-consistency、process reward model 等常见 CoT 改进方法充分对比,难以判断启发式增强 RL 的独特优势。工程上,实际部署需权衡准确率与推理延迟,且需更多基准和模型规模验证其稳健性。