Acquire, Repair, Preserve: 面向小型模型对话游戏代理的诊断引导式后训练方案
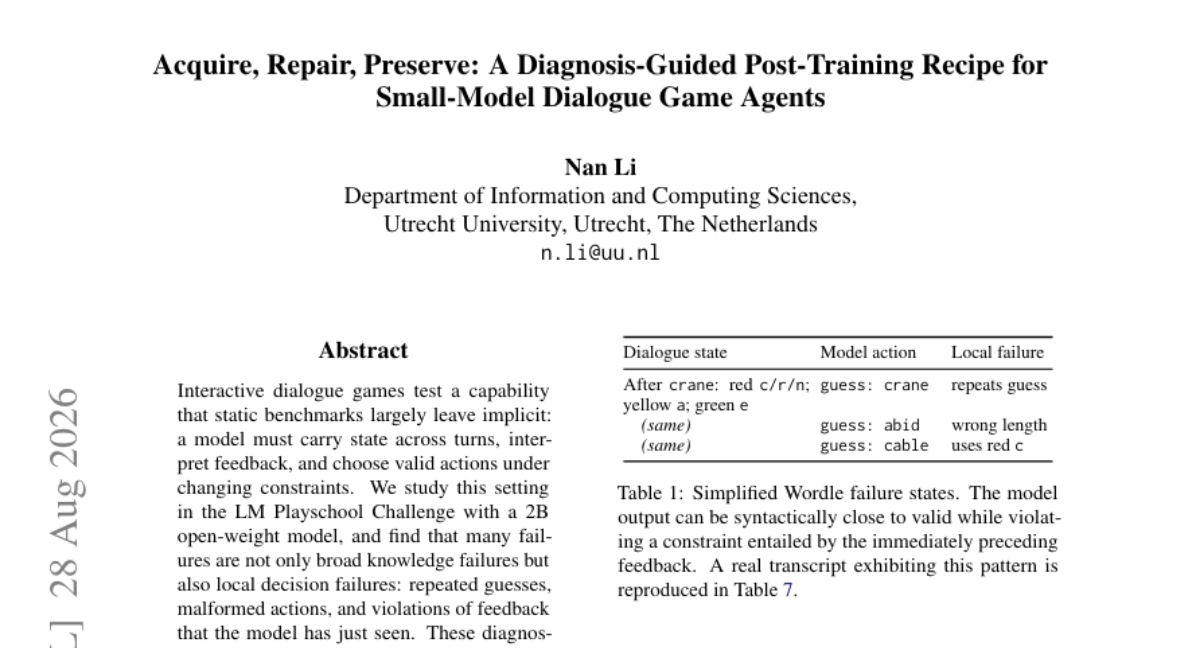
交互式对话游戏检验了一种静态基准大多未明确考察的能力:模型必须在多轮对话中携带状态、解读反馈,并在不断变化的约束下选择有效动作。我们在 LM Playschool Challenge 中研究该场景,使用一个 2B 开源模型,发现许多失败不仅源于广泛知识缺失,也源于局部决策失误:重复猜测、格式错误的动作,以及无视刚看到的反馈。这些诊断启发了一套围绕三步走的训练方案:通过监督微调获取广泛的游戏参与能力,在单一目标对话游戏族内通过回合级偏好对修复可机械验证的失败,并保持这些对话游戏之外的通用能力。在官方最终评测中,我们的提交将公共 clemscore 从 10.67 提升至 38.92,封闭域内得分从 13.41 提升至 41.17,同时大致保持静态聚合性能(基线 44.14 对 44.24)。域外 clemscore 仍低至 7.88,最大增益集中在目标游戏族的未见变体上。我们的结果表明:广泛 SFT 带来了模型能力的大部分提升;当失败检测精确时,回合级监督是有效的,观察到的迁移主要局限于族内。
论文精读
TL;DR 本文提出诊断引导的三阶段后训练配方:先 broad SFT 获取对话游戏能力,再用 turn-local 偏好对修复可验证的局部决策失败,并保持通用性能;2B 模型 public clemscore 从 10.67 提升至 38.92,静态性能几乎不降。
问题
问题背景
交互式对话游戏正成为评估语言模型状态追踪、反馈解释与动态约束下动作选择的重要场景,因为静态基准难以捕捉这些能力。
现有方法局限
- 传统静态基准(如知识问答、文本生成)无法暴露模型在多轮交互中的局部决策失败,例如重复猜测、输出格式错误、忽略刚获得的反馈。
- 监督微调(SFT)通常使用通用语料,缺少针对交互失败模式的精确监督信号;而偏好优化(如 DPO)偏好全局轨迹级奖励,难以定位和修复单轮内的机械可验证错误。
- 小模型(2B 参数)在动态状态追踪与反馈解释上能力不足,训练后期易出现泛化与特定任务能力失衡。
为什么这个问题难/重要
- 交互式场景要求模型同时完成规则理解、历史状态记忆与即时反馈响应,任何一环出错都会导致任务失败。
- 失败往往是局部决策而非知识缺失,诊断与定位成本高,且修复某类错误可能影响其他能力。
- 业界对对话式 AI、游戏智能体、自动化交互系统兴趣持续上升,后训练方法在提升任务表现的同时保持通用能力是关键工程挑战。
行业类比
类似对话式推荐系统或智能客服:模型必须根据用户即时反馈调整下一步动作,同时保持输出格式合法、避免重复无效尝试,这与游戏中的交互约束高度一致。
核心洞察
- 将模型失败拆分为知识失败与局部决策失败,并针对后者引入可机械验证的 turn-local 偏好对进行修复。这不同于以往依赖大规模 SFT 或 RLHF 的隐式学习路径,而是把“诊断-修复”变成工程化流程:通过规则检测重复猜测、格式错误、违反即时反馈等可验证错误,构造正负样本对,在不引入额外人工标注的前提下提高模型在交互任务中的稳定性。
- 训练阶段严格解耦为 broad SFT、turn-local repair、preserve 三步,并量化各阶段贡献:broad SFT 带来大部分能力提升,repair 仅在失败检测精确时有效,preserve 则通过权重空间模型选择而非简单的正则化或混合训练来实现。这与常见的多任务联合训练或端到端 RLHF 不同,避免了不同目标间的相互干扰,为小模型后训练提供了更可解释、更可控的配方。
- 实验结果表明,交互能力的改进高度集中在目标游戏家族内部,OOD clemscore 仅 7.88,说明对话游戏能力可能远不如传统静态基准所暗示的那样通用。这提示当前模型选择与评估体系需要重新审视:仅凭静态基准得分近似保持,并不能预测交互式任务的跨域泛化,未来需要更结构化的任务相似性度量来指导训练与评测。
方法
输入:对话游戏的多轮状态与反馈历史(先前的猜测、约束、反馈 token)。
关键模块:分三个阶段。
- Acquire(获取):在大规模对话游戏语料上执行 SFT,让 2B 模型习得基础交互、状态追踪和反馈解读,初步适应多轮游戏。
- Repair(修复):针对目标游戏家族(如 Wordle 变体),构造 turn-local 偏好对。先自动检测机械可验证的局部错误(重复猜测、格式非法、违反刚给出的反馈),将错误响应作为 rejected,修正响应作为 chosen,进行偏好训练(例如 DPO)。Turn-local 指仅使用当前轮次的局部上下文而非整条轨迹,避免全局偏好噪声。
- Preserve(保持):通过 权重空间模型选择 或混合保留,保持静态基准上的通用能力,防止游戏特化损害原有性能。
输出:在每一轮生成合法且满足约束的动作,降低局部决策失败率。整体流程为:输入多轮上下文 → 诊断器标记机械错误 → 构造 turn-local 偏好对 → 分阶段 SFT + 偏好训练 + 模型选择 → 输出约束满足的动作。
跟同类方法的差异点:与全程轨迹级偏好优化或纯 SFT 方案相比,该方法以诊断驱动、turn-local 的偏好修复为核心,只修正可精确验证的局部错误,既避免全局奖励噪声,又将泛化集中在目标游戏家族内部。
实验
实验设计
研究工作基于 LM Playschool Challenge 环境,使用 2B 开源权重模型进行诊断与训练。首先通过诊断发现小模型在对话游戏中的失败不仅包括知识缺失,更常见于局部决策错误(重复猜测、格式错误、违反刚看到的反馈)。据此设计三阶段后训练流程:1) 广泛 SFT(broad SFT) 获取基础游戏参与能力;2) 面向一个目标对话游戏家族,用回合局部偏好对(turn-local preference pairs) 修复可验证失败;3) 通过权重空间模型选择保留通用能力。最终在官方评测上验证。
关键发现
- 公共 clemscore 从
10.67提升至38.92,封闭域内分数从13.41提升至41.17。 - 聚合静态性能基本保留(
44.14vs 基线44.24)。 - 域外 clemscore 仍低(
7.88),提升主要集中在目标家族的未见变体。 - 研究表明 SFT 带来大部分能力提升;回合局部监督在失败检测精确时有效,但迁移主要限于家族内部。
与基线对比解读
与未训练基线相比,对话游戏分数有数倍提升,但泛化边界明显:目标家族内迁移强,跨家族迁移弱。这提示工程实践中,机械可验证的局部失败可通过低成本回合级偏好数据修复,但不应期望其自动泛化到完全不同的任务结构;同时,保留通用能力需要显式的权重空间模型选择,而非仅依赖数据混合。与单纯扩大 SFT 相比,诊断驱动的局部修复在数据效率上可能更高,但适用场景受限。
行业影响
落地场景
本研究针对小模型在交互式对话游戏 中的局部决策失败(重复猜测、格式错误、无视刚出现的反馈)提供诊断驱动的后训练配方,可迁移至需多轮状态追踪与约束变化的对话代理产品。典型如电商客服:处理退货、改地址等流程中,用户多步修改需求,模型需记住上下文并执行有效操作,避免重复询问;在线教育:语言练习对话中,模型根据学生回答动态调整难度并给出即时纠错,而非机械重复。
商业价值
主要沿降本 与体验提升 两条线。2B 小模型推理成本远低于大模型,可在边缘或低成本实例部署;SFT 阶段已带来大部分能力提升,数据采集与训练成本可控。论文显示 clemscore 从 10.67 提升至 38.92,证明针对性修复可大幅减少人工接管率,提升用户满意度与转化。但需注意 out-of-domain 迁移有限,因此适合垂直场景深度优化,而非通用泛化。
跟现有工作流接口
该方法可嵌入现有 LLM 应用栈,使用标准工具链(如 TRL / Axolotl)实现 SFT 与偏好优化。关键组件是可验证失败检测器(规则或模型判断),用于自动生成 turn-local preference pairs,类似 RLHF 中的 reward model 但更轻量。工程团队可在现有对话系统上先做诊断,再定向采集失败样本进行微调,形成“诊断-修复-评估”闭环。与 RAG 或工具调用框架兼容,作为对话状态管理模块独立迭代。
局限
- - **机械可验证修复范围有限**。论文在 Discussion 中明确承认了 “Scope of mechanically verifiable repair”,即 turn-local 偏好训练仅适用于可精确检测的局部错误,如重复猜测、格式错误、直接违反刚看到的反馈等;对于需要更广泛推理或语义理解的失败类型则无能为力。实验显示 out-of-domain clemscore 仅 7.88,远低于 in-domain 41.17,表明学到的修复策略主要局限于目标对话游戏家族,跨家族泛化极弱。这意味着该方法高度依赖针对特定失败模式的检测模板,迁移到新任务时需要重新设计与标注,工程成本不可忽略。
- - **对 acquire 阶段父模型的依赖未充分探索,阶段归因不完整**。论文在局限中列出 “Untested dependence on the acquisition-stage parent” 和 “Limits of phase attribution and model selection”。现有实验未系统比较不同 SFT 数据规模、质量或基座模型对后续 repair 阶段收益的影响,无法确定三步流程的最优配置;模型选择仅基于聚合静态性能,没有组件级能力保持分析,可能掩盖某些子能力(如数学、代码或长文本理解)的显著退化。此外,最终能力提升可能大部分来自 broad SFT,而 turn-local repair 的贡献需更精确的消融才能分离。
- - **与现有后训练方法对比不足,额外成本较高**。论文提出的诊断引导食谱在方法层面与标准 SFT + 偏好优化流程差异有限,创新更多体现在问题诊断与数据构造上;缺少与简单基线(如仅做 SFT、使用全局 DPO 或 Rejection Sampling)的公平对比,难以证明 turn-local preference 的独特增益。同时,turn-local 偏好对的生成需要额外的规则引擎或自动验证器来标注偏好,这引入了额外的先验知识和开发成本,相比更通用的后训练技术(如细粒度奖励建模)适用范围更窄,可复用性受限。