什么造就了好的 Agentic 数据?ACE 视角下的 LLM 智能体数据生成
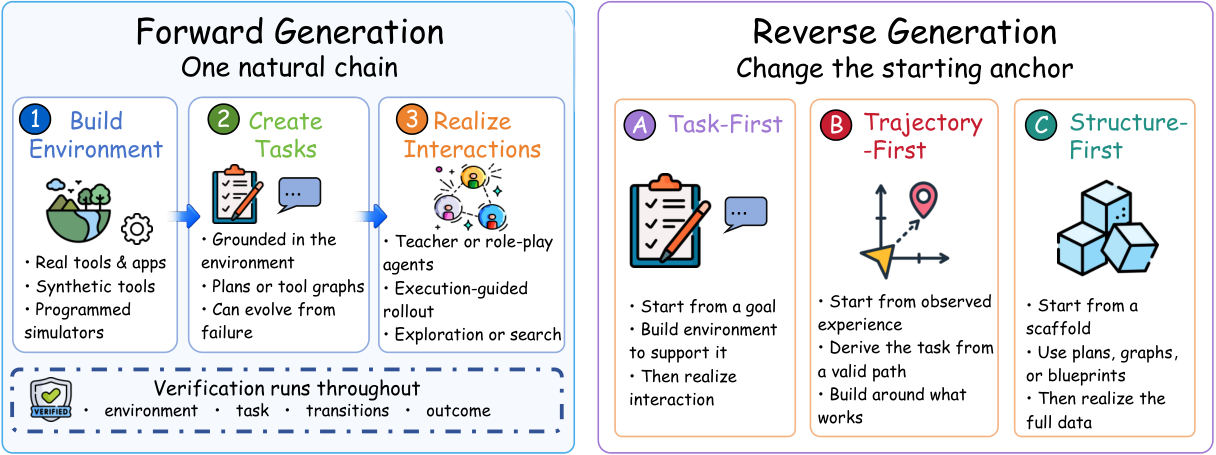
LLM 智能体越来越依赖生成的交互数据来学习如何与外部环境交互。智能体数据生成必须在维护环境、任务、交互与成功信号之间一致性的同时,产生有用的经验,而不仅是海量的数据。现有工作覆盖了多个智能体领域,但以领域为中心的组织方式和异构评估往往掩盖了共同的生成机制,并将候选构建与验证、选择混为一谈。 本文为该领域提出了一个两层框架。首先,将智能体数据表示为共同的分解对象 (E,q,τ,v),即环境规格、任务信号、交互实现和可选的验证器。按主要锚点和依赖结构来组织生成范式。其次,通过 准确性-复杂度-多样性(ACE) 视角将生成建模为受约束的分布设计。准确性确定基础且内部一致的数据的可行支撑;在此支撑内,复杂度根据声明的学习者和执行配置来放置学习质量;多样性控制数据的覆盖度和冗余。 利用该框架,探讨了先前工作如何验证生成经验、构建和校准难度,以及扩展行为覆盖。文献显示了一种转变:趋向于执行基础的准确性、学习者相对的复杂度,以及超越表面变化或数据集规模的多样性。进一步讨论了通过 ACE 视角看智能体数据生成的更广泛方向和新兴趋势,包括对扩展、数据来源、训练制度和自适应学习的启示。总之,核心挑战不是简单地生成更多数据,而是在智能体和环境演化时持续分配有效、信息丰富且不冗余的经验。
论文精读
TL;DR 用 ACE 框架将 agentic 数据生成建模为受限分布设计,主张好的数据是 execution-grounded 准确、学习者相对复杂且非冗余的经验,而非单纯更多数据。
问题
问题背景
LLM agents 日益依赖生成的交互数据来学习如何与外部环境交互,领域当前关注如何让这些数据不仅规模大,还能有效支撑智能体能力提升。
现有方法局限
- 领域中心化且评估异构:不同 agent 领域(工具调用、GUI、具身等)各自独立组织数据生成,缺乏统一视角,难以比较和迁移生成机制。
- 生成阶段混淆:现有工作常把候选构建、验证、选择三个环节混在一起,导致难以定位数据质量问题来源。
- 数据规模导向而非学习价值导向:大量努力集中在产生更多交互轨迹,却忽视了环境、任务、交互与成功信号之间的一致性,以及数据对特定学习器的信息增量。
- 缺少约束化设计视角:没有把数据生成看作在准确性、复杂度、多样性三个维度上受约束的分布设计问题,难以系统控制数据质量。
为什么这个问题难/重要
- 多因素一致性要求高:一条有效 agentic 数据必须同时满足环境规范、任务信号、交互实现与验证器之间的语义对齐,任一环节错位都会引入噪声。
- 验证成本与偏差权衡:执行接地验证虽然准确但代价高,基于模型或规则的检查又会引入 verifier bias,且验证强度会与复杂度和多样性耦合。
- 复杂度必须相对学习者校准:单纯增加任务困难度不等于提升学习价值,需依据目标学习器的当前能力与执行配置动态调整。
- 业界关注点从“更多数据”转向“有效数据”:随着 agent 能力提升,冗余低质数据的边际效益骤降,而精准生成高信息密度、非冗余经验的成本压力上升。
行业类比
类似自动驾驶仿真场景生成:不能只堆砌事故数量,必须保证场景物理合理(accuracy)、难度与当前自动驾驶系统能力匹配(complexity)、覆盖长尾且不重复(diversity),否则训练出的模型会过拟合仿真分布而无法泛化真实路况。
核心洞察
- Agentic 数据生成的核心洞察是把每条经验视为可因子化对象 `(E, q, τ, v)`,并明确候选构建与验证选择分离。与按工具、GUI、coding、embodied 等领域割裂的现状不同,该因子化视图统一了生成机制,使工程师能在环境规范、任务信号、交互实现、验证器四个维度独立诊断和修复数据缺陷,例如发现某类任务信号不接地时只需替换对应生成逻辑,不影响整体管线。
- 第二个关键角度是把数据生成重新表述为 **约束分布设计**,而非追求更多样本。在 **Accuracy** 划定的可行支撑内,**Complexity** 须相对于当前学习者能力与执行配置校准,**Diversity** 则控制覆盖与冗余。这与只看数据集规模的 baseline 有本质差异:同一份经验对不同策略价值不同,因此数据生产应闭环至具体 agent 的训练状态,持续分配对当前模型有效、信息丰富且非冗余的样本,避免静态收集造成的浪费与偏差。
方法
输入与因子化表示
Agentic data 生成被统一为对因子化经验元组 (E, q, τ, v) 的操作:E 是环境规格,q 是任务信号,τ 是交互实现(多轮轨迹),v 是可选验证器。这一表示将不同领域(工具使用、GUI、编程、具身等)的数据生成抽象到同一对象上,便于跨域分析生成机制。
关键模块:ACE 约束分布设计
生成范式按主锚点和依赖结构分为正向生成(环境→任务→交互)与反向生成(任务优先、轨迹优先、结构优先),但核心是将数据生成视为在可行支持集上设计分布,受三个维度约束:
- Accuracy(准确性):定义数据的合法支持集,要求环境、任务、交互、验证器及结果在事实上正确且内部一致。实践机制包括分层规则/模型/人工检查、约束基础构造、执行与状态验证、反馈修复与选择性准入。
- Complexity(复杂度):在准确性约束的支持集内,将学习质量密度分配到与目标学习者能力和执行配置相匹配的复杂度区域。通过结构规格与组合、任务信息控制、环境交互设计、完成反馈设计、进化变换、失败驱动校准等构造难度,同时避免课程漂移和闭环偏差。
- Diversity(多样性):控制覆盖与冗余,扩大行为覆盖而非仅增加数据量。机制包括源与支持扩展、组合重组、探索式发现、扰动与反事实变体、覆盖引导的平衡与适配,并针对不同领域实例化。
输出
输出不是单一数据集,而是一个数据生成策略或分布,能够在训练过程中持续分配有效、信息丰富且非冗余的经验,支持 scaling、混合数据源和自适应学习。
与同类方法差异点:该方法用统一的 ACE 视角将数据生成从“构造候选+验证筛选”的混杂流程中解耦,明确区分为支持集约束(Accuracy)与质量密度分配(Complexity/Diversity),从而将数据质量评估从静态指标转向面向学习者的动态分布设计。
实验
实验设计叙述
本文非实验论文,而是通过 ACE 框架 对现有 agentic data generation 文献进行结构化综述。将 agentic 数据因子化为 (E,q,τ,v),从三个维度分析生成机制:
- Accuracy 关注环境、任务、交互、验证器的一致性;
- Complexity 将学习难度相对化到 learner 能力与执行配置;
- Diversity 超越表面变异,强调行为非冗余与覆盖。
关键发现
- 文献呈现从“规模优先”向 执行接地准确性、学习者相对复杂度、行为多样性 的明确转向;
- 验证方式从纯模型判别转向执行与状态验证;
- 复杂度校准越来越多基于失败驱动与模型能力,而非静态难度标签。
与基线对比解读
与传统 data-centric 生成相比,该框架将候选构造与验证选择解耦,强调约束分布设计而非单纯数据量;与单一领域基准不同,ACE 跨域归纳共同机制,为后续自适应学习与 scaling 提供可操作维度。
行业影响
落地场景
论文提出的 ACE 框架 可直接指导 LLM agent 训练数据生成 pipeline,尤其适用于需要与环境交互的多步任务。典型场景包括:
- 电商购物助手:生成模拟的浏览、搜索、比价、下单轨迹,训练 agent 在商品推荐、优惠券使用、售后对话中的决策能力。
- 企业服务自动化:生成 CRM 操作、工单处理、API 调用序列,训练 agent 处理客户查询与内部流程,减少人工介入。
商业价值
- 降本:通过因子化数据对象
(E,q,τ,v)和执行接地验证,筛选有效样本,避免低质量数据浪费标注与训练资源。 - 增收/提效:提升 agent 在真实任务中的成功率与鲁棒性,直接改善客户转化率与工单解决率,同时缩短模型迭代周期。
- 体验提升:生成数据更贴合真实环境分布,减少 agent 幻觉与错误动作,增强用户信任。
与现有产品/工作流的接口
- 集成进 MLOps/DataOps 栈:将因子化对象作为统一数据 schema,对接 feature store、data versioning 工具。
- 与 RLHF/偏好优化 结合:利用 verifier 信号构造偏好对,用于 DPO 或 PPO 训练。
- 建立持续学习闭环:线上部署后,通过 execution-grounded 反馈筛选交互数据,自动扩充训练集,实现自适应学习。与单纯堆数据量的做法相比,该框架强调 learner-relative complexity 与 diversity,更适合资源受限的团队。
局限
- **概念性框架缺乏实证验证**:本文提出的 **ACE 框架** 主要是在文献梳理基础上构建的抽象分析工具,并未通过新的实验或基准测试来证明该框架能实际提升 agentic data 生成的质量或下游 agent 性能。与提出具体生成算法(如 **AgentInstruct**、**Evol-Instruct** 等)的工作相比,其指导意义停留在理论层面,工程团队难以直接落地为数据 pipeline 的优化策略。框架中的 **Accuracy**、**Complexity**、**divErsity** 三个维度如何量化、如何加权优化仍没有给出可操作的指标或算法。
- **统一抽象可能掩盖领域特定约束**:将 agentic data 统一分解为 `(E, q, τ, v)` 四元组虽然便于跨领域比较,但不同 agent 场景(如 **Web 导航**、**具身操作**、**代码生成**、**科学推理**)的物理真实性、安全规范、环境可逆性等约束差异极大,四元组无法完整表述这些细微但关键的领域限制。因而 ACE 框架在具体领域应用时可能需要大量定制扩展,其通用性主张在真实 heterogeneous 环境中可能被削弱。
- **对动态平衡与迭代优化的讨论不足**:论文在 4.4、5.5、6.5 节分别讨论了 **Accuracy**、**Complexity**、**divErsity** 各自的 tradeoffs,但对三者在数据生成全生命周期中的协同调节和闭环反馈机制缺少系统性建模。实际工程中,随着 agent 能力提升和环境演化,数据分布需要不断重分配,而 ACE 框架没有提供如何在训练过程中动态调整三者权重的方法论,这限制了它在 **adaptive learning** 和持续数据引擎中的直接应用。