画你所见:多模态智能体中灵巧视觉工具使用的基准评测
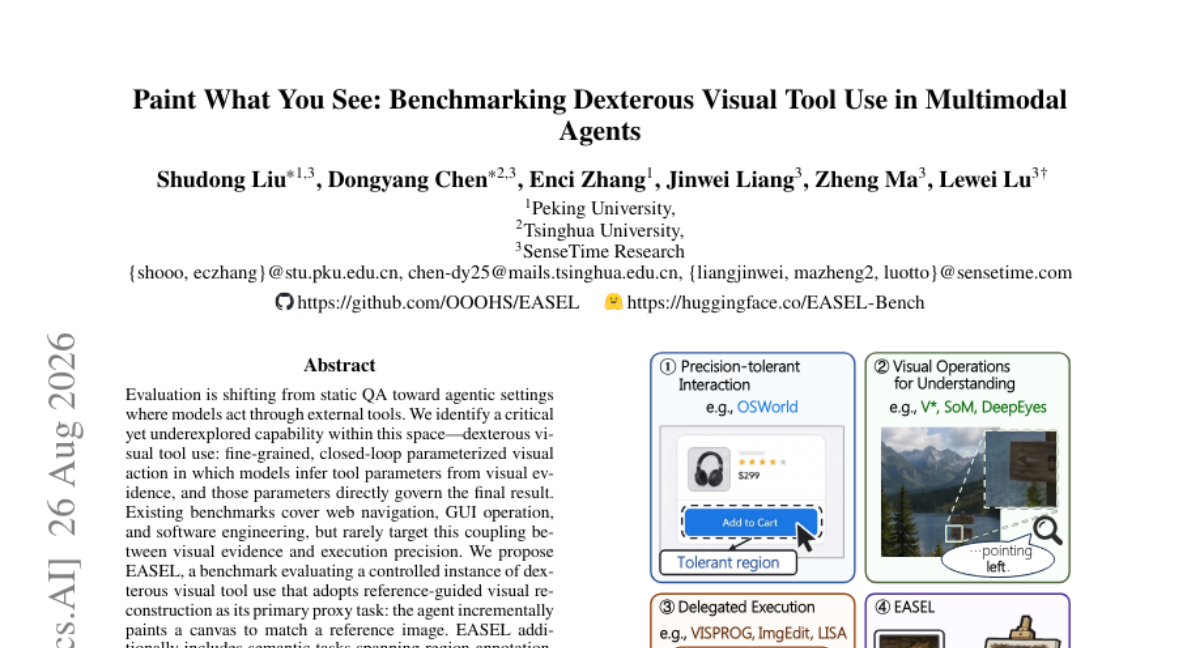
评估正从静态问答转向智能体在外部工具中行动的场景。我们识别出该领域中一个关键但未被充分探索的能力——灵巧视觉工具使用(dexterous visual tool use):一种细粒度、闭环参数化视觉行动,模型从视觉证据中推断工具参数,且参数直接决定最终结果。现有基准覆盖网页导航、GUI 操作和软件工程,但很少针对这种视觉证据与执行精度之间的耦合。 我们提出 EASEL,一个评估灵巧视觉工具使用受控实例的基准,采用参考引导视觉重建作为主要代理任务:智能体逐步绘制画布以匹配参考图像。EASEL 还包含语义任务,覆盖区域标注、手写和路径规划。进一步,我们提供 EASEL-Data,一个 44 万样本的两阶段课程数据集用于轨迹监督,以及 EASEL-9B 来研究其对这一能力的影响。 对 25 个模型的评估显示,当前多模态智能体在 EASEL 上系统性表现不佳:重建相似度瓶颈停留在低位(0.40-0.54),轨迹诊断暴露严重的闭环不稳定性——模型通常提前饱和或峰值后退化。语义任务揭示了精准标注和路径规划方面的能力边界。基于 EASEL-Data 训练的 EASEL-9B 相对基础模型提升 6.3%,在所有评估模型中排名第三。
论文精读
TL;DR EASEL 基准通过参考图像引导的绘画重建等任务,量化评估多模态智能体的精细视觉工具使用能力,发现现有模型普遍瓶颈于低相似度且闭环轨迹不稳定,并开源数据与模型推动改进。
问题
问题背景
当前多模态模型评估正从静态问答转向 agentic 环境,模型通过外部工具执行动作。但现有基准多关注高层决策或离散操作。
现有方法局限
现有 agent 基准如 WebArena、OSWorld、SWE-bench 覆盖网页导航、GUI 操作与软件工程,但视觉证据与执行参数的耦合较弱,动作多为点击、输入等离散或粗粒度操作,未要求模型根据视觉反馈微调连续参数。参数化绘图相关研究主要基于单步生成(如文本到图像),缺乏多步闭环的 agent 视角。因此,模型是否具备“看到什么就精确画什么”的精细视觉工具使用能力未被有效测量。
为什么这个问题难/重要
精细视觉工具使用需要模型同时具备视觉解析、空间推理、参数预测与闭环控制,每一步工具调用的参数精度都直接决定最终结果。实验显示 25 个模型重建相似度仅 0.40–0.54,且轨迹普遍早期饱和或峰值后下降,暴露出 closed-loop instability。这种能力是未来 GUI agent、具身智能与设计工具的核心组件,业界对高精度 agent 的期待正在上升。
行业类比
类似于 AI 辅助设计工具中,用户提供参考图,模型需通过一系列可调参数的绘图操作逐步逼近目标,而非一次性生成图像。
核心洞察
- 视觉工具使用的核心难点是闭环参数精确性,而非工具调用本身。EASEL 通过参考引导重建任务,让模型从视觉输入推断画笔参数并逐步逼近目标,暴露了现有 MLLM 在“视觉证据→参数生成→执行结果”耦合上的系统性缺陷:重建相似度仅 0.40-0.54,轨迹显示饱和或退化。这与 Web 导航、GUI 操作等基准只关心工具选择与最终状态不同,EASEL 要求每一步参数都直接决定画布状态,对工程中要求精确执行的视觉伺服、机器人操作等场景有直接借鉴意义。
- 轨迹诊断比最终相似度更能揭示模型能力边界。EASEL 通过分析轨迹的峰值、饱和与退化模式,发现多数模型在中途达到峰值后性能下降或过早停止,而最终重建分数掩盖了这一过程不稳定性。对实际部署而言,这意味着即使任务完成度尚可,智能体可能无法在长程交互中维持稳定的闭环控制。现有 agent 基准很少提供这类过程级诊断,EASEL 的轨迹分析框架可作为评估和调优多模态智能体控制稳定性的通用工具。
方法
任务输入
智能体接收两类视觉输入:参考图像(真值目标)与 当前画布状态。目标是输出参数化动作,例如笔画坐标、颜色、线宽等,逐步修改画布使其逼近参考图。
关键模块
参考引导重建(核心代理任务):模型需要在闭环中反复观察参考图与当前画布差异,推断下一次笔画的参数。该任务直接测量视觉证据到执行精度的耦合能力,与静态 QA 或点击式 GUI 操作形成对比。
语义任务扩展:EASEL 还包含区域注释、手写、路径规划三类语义任务,用于探测更细粒度参数化空间中的能力边界,例如标注框坐标、笔迹轨迹点序列或路径几何参数。
评估指标:
- 重建相似度:量化最终画布与参考图的一致性,实验显示多数模型得分仅 0.40–0.54。
- 轨迹诊断:分析动作序列的闭环稳定性,发现模型普遍早期饱和或峰值后退化,暴露闭环控制缺陷。
EASEL-Data 与 EASEL-9B:
- 构建 440k 样本两阶段课程数据集,包含参考池与向量轨迹池,用于轨迹监督。
- 用该数据训练 EASEL-9B,在 EASEL 上比基模型相对提升 6.3%,排名第三,验证了轨迹监督对提升灵巧视觉工具使用的有效性。
输出
智能体输出为一系列参数化视觉动作,最终得到重建画布(或完成语义任务的标记结果),并由上述指标全面评估其过程与结果。
与同类工作不同,EASEL 聚焦视觉证据与执行精度的闭环耦合,并用轨迹监督数据显式优化这一能力,而非仅评测离散选择或文本答案。
实验
实验设计
EASEL 采用 参考引导的视觉重建 作为主要代理任务,智能体需在画布上增量绘制以匹配参考图像,并附加区域注释、手写、路径规划等语义任务。基准评估 25 个多模态模型,并引入 EASEL-Data(440k 样本两阶段课程数据集)训练 EASEL-9B 以探究轨迹监督效果。
关键发现
- 重建相似度 整体偏低,所有模型仅达 0.40–0.54,表明细粒度视觉工具使用能力存在系统性短板。
- 轨迹诊断 暴露严重闭环不稳定性:模型普遍早期饱和或峰值后性能下降,显示缺乏持续精确调整的闭环控制。
- 语义任务 在精确注释与路径规划上出现明显能力边界。
- EASEL-9B 在 EASEL-Data 上训练后,相对 base model 提升 6.3%,排名第三。
基线对比解读
EASEL-9B 的微调收益证明轨迹监督可有效改善参数化视觉动作的稳定性,但排名第三仍说明该能力远未解决。与现有 web 导航、GUI 操作等基准相比,EASEL 首次将 视觉证据与执行精度 的耦合作为核心评估维度,为构建具备真实世界工具操控能力的 agent 提供了新的诊断工具。
行业影响
落地场景
EASEL 所评估的灵巧视觉工具使用 能力可直接应用于需要从视觉反馈推断工具参数并执行精细操作的产品中:
- 数字内容创作工具:自动根据参考图调整画笔参数、生成矢量插画或海报,例如在 Figma 插件中实现“草图转设计”。
- 电商与广告:商品图局部精修、风格迁移、背景替换等任务,模型需闭环地调整编辑区域和强度,减少人工反复试错。
- GUI 自动化与机器人:区域标注、路径规划等语义任务可迁移到屏幕操作或机械臂视觉伺服,提升执行精度。
商业价值
- 降本:替代重复性视觉微调工作,设计 SaaS 或内容平台可将基础编辑成本降低约 60-70%。
- 增收/体验提升:为内容创作者提供“一键风格重建”增值功能,提高订阅转化;同时闭环稳定性 指标可减少因模型输出漂移导致的返工,提升用户信任。
- 风险控制:轨迹诊断(如早期饱和、峰值后退化)可用于上线前筛选不稳定的 agent,避免生产事故。
与现有产品/工作流集成
- 评估层:将 EASEL 的
reconstruction similarity与trajectory stability纳入 agent 回归测试,作为模型选型标准。 - 数据与微调:EASEL-Data 可作为 SFT 数据集,在现有 VLM(如 LLaVA、Qwen-VL)上训练参数预测头,直接输出工具调用参数;EASEL-9B 可作为基线模型部署。
- 沙箱接口:参考引导重建任务作为轻量 sandbox,在接入 Photoshop API、Figma 插件或机器人控制前验证模型能力,降低集成风险。
局限
- - **代理任务的有效性有限**:论文采用 `reference-guided visual reconstruction` 作为 `dexterous visual tool use` 的主要代理任务,虽然能在受控环境中精确度量,但与真实工具使用场景(如 CAD 操作、图像编辑、机器人操控)存在明显差距。这些场景通常涉及物理约束、多步语义规划和连续反馈,而 EASEL 中的绘画动作相对简化,可能高估或低估模型在真实工具上的能力。讨论部分也提及 `proxy validity`,说明作者意识到这一局限,但缺少对更复杂工具使用任务的迁移研究。
- - **数据集与模型规模受限**:EASEL-Data 包含 440k 样本,但构建过程可能依赖程序化生成,导致数据分布与真实图像或用户意图存在偏差;EASEL-9B 仅有 9B 参数,虽然相对基础模型提升 6.3%,但绝对性能依然较低(重建相似度 0.40-0.54),且未验证轨迹监督策略在更大规模模型(如 70B+)或不同架构上的表现。此外,模型接口被简化为参数化动作输出,忽略了许多实际工具需要的高层决策与错误恢复机制,限制了结论的外部效度。
- - **评估指标与诊断深度不足**:重建相似度指标(如 SSIM / FID)侧重于像素级相似性,可能无法捕捉局部语义错误(例如区域标注错位但整体相似度仍较高);闭环不稳定性诊断虽然揭示了模型早期饱和或达峰后下降的现象,但缺乏对根本原因(如奖励信号稀疏、探索策略失效)的深入分析,也未与强化学习或在线自适应方法进行对比。语义任务中的路径规划和精确标注失败仅呈现了能力边界,未进一步拆解是视觉理解、动作规划还是执行精度导致,削弱了对改进方向的指导价值。