Super Star: 面向数字人的流式实时交互智能体
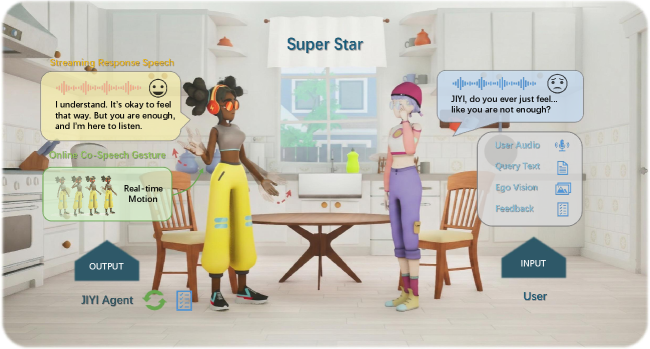
现有共语手势生成方法多在离线设置下研究,从完整语音片段合成手势,难以满足真实交互场景中 流式语音响应、低延迟 的要求。这些方法要么依赖未来语音信息,要么推理延迟过高,无法用于实时交互。 为此,本文提出实时交互框架,将 流式语音响应模块 与 在线手势生成模块 耦合。手势生成器采用 因果多模态自回归模型(causal multimodal autoregressive model),基于当前响应语音与运动历史逐帧预测身体姿态,无需等待未来语音,实现低延迟与语音同步的手势合成。同时,针对虚拟伴侣场景,设计离线数据合成流程,利用主题与情感感知的语料构建多样化人机对话,并生成条件于智能体响应的共语手势。为弥合离线与在线差距,引入 自进化训练循环,将在线交互中收集的用户反馈纳入数据生成,持续适应用户偏好。 实验表明,该框架相较于现有基线在 延迟-质量权衡、语音-运动同步 和 用户偏好 上均取得更优性能。
论文精读
TL;DR Super Star 面向实时数字人交互,用因果多模态自回归模型在线生成语音同步手势,无需未来语音,实现低延迟;并自进化整合用户反馈持续优化,延迟-质量与用户偏好显著优于基线。
问题
协同语音手势生成(co-speech gesture generation)是数字人交互的核心能力,当前研究正从离线合成转向实时流式生成,以满足虚拟助手、游戏 NPC 等场景对低延迟自然响应的需求。
现有方法局限:
- 离线范式依赖完整语音:多数工作假设整句音频可用,模型基于双向上下文或未来帧信息生成手势,推理必须等待语音结束,延迟达数百毫秒至秒级,无法满足严格实时约束。
- 与流式语音模块脱节:现有模型缺乏对历史运动状态与当前语音增量的逐帧融合机制,导致手势与语音节奏错位或动作抖动。
- 数据构造不匹配:真实交互中只有流式语音片段,但训练数据多由完整语音离线标注,缺乏在线场景的成对数据。
为什么难且重要:在线生成本质上是一个因果序列建模问题——模型在每个时间步只能利用已到达的音频流和自身运动历史预测下一帧姿态。挑战包括跨模态时序对齐精度、推理延迟与生成质量的平衡,以及如何利用用户反馈实现自进化。业界对可实时驱动、高自然度数字人的需求快速增长,该问题是具身智能与多模态交互的交叉热点。
行业类比:类似自动驾驶在线轨迹预测,系统必须在每个时间步基于部分观测立即输出未来动作,而不能等待完整轨迹序列。
核心洞察
- 将离线 co-speech 手势生成重构为流式在线问题,采用因果多模态自回归模型,通过运动历史和因果掩蔽音频条件交叉注意力,在不访问未来语音的情况下实现低延迟、语音对齐的手势生成。区别于现有离线方法依赖完整语音或推理延迟大,本工作从模型架构层面而非工程优化层面解决实时性问题,为交互式数字人的部署提供了真正可用的在线方案。
- 构建离线数据合成与用户反馈驱动的自我进化训练循环,面向虚拟陪伴场景生成主题/情感感知对话及对应手势,并将在线交互反馈注入数据生成流程,实现持续适应用户偏好的闭环。该设计突破了传统静态数据集训练的局限,将部署后的用户信号纳入迭代,使系统能动态适应真实交互中的个性化需求,这是同类基准方法(如 BEATv2 上的离线生成)所不具备的。
方法
输入
- 流式语音响应模块接收用户输入与对话上下文,产生流式语音片段(agent 的回复音频)。
- 在线手势生成模块接收当前流式语音特征与运动历史 token(已生成的身体运动离散编码)。
关键模块
1. Streaming Speech Response Generation
耦合一个流式语音响应模块,基于主题和情感感知语料库生成实时回复语音,保证语音流持续输出。
2. Online Co-Speech Gesture Generation
- 组合式身体运动 tokenization:使用 VQ-VAE 或 RQ-VAE 将连续身体运动编码为离散 token 序列,便于自回归建模。
- 因果多模态自回归模型:以流式语音 token 和运动历史 token 为条件,通过因果掩码音频条件交叉注意力逐 token 预测下一时刻运动,天然支持在线推理,无需未来语音。
- 低延迟设计:每收到一个音频帧即可对应输出手势 token,实现语音-手势同步。
3. Offline Interactive Data Synthesis
构建主题与情感感知的对话语料库,先合成多样化人机对话,再离线生成对应 co-speech 手势,作为初始训练数据。
4. Self-Evolving Training Loop
将在线交互中收集的用户反馈(偏好样本)回注到数据生成流程,持续更新模型,适应个性化偏好。
输出
流式、语音对齐的 3D 身体运动序列,可直接驱动数字人实时交互。
差异点
与依赖完整语音或未来信息的离线手势生成方法不同,本框架采用纯因果建模与流式处理,并通过用户反馈闭环提升长期适配性。
实验
实验设计
论文在自定义 JIYI Dataset 和公开 BEATv2 上评测,对比多个离线和在线基线。主要指标包括 FGD (手势分布距离)、L1 Diversity、Beat Constancy (节拍一致性),并辅以用户偏好研究。消融实验检验 因果音频条件建模、跨模态交互、自进化循环 的贡献。
关键发现
框架在延迟-质量权衡上取得更好表现,语音-运动同步性更强。因果建模避免未来信息泄漏,自进化循环利用在线交互用户反馈提升个性化适应。
与基线对比
相比依赖完整语音的离线方法,该框架在严格实时约束下仍保持竞争力;相比其他在线方法,通过多模态自回归与运动历史,改善了同步性与用户偏好。
行业影响
落地场景
实时交互数字人对低延迟语音-手势同步有强需求,典型产品包括电商直播数字人、在线教育虚拟教师、金融咨询助手以及企业虚拟客服。Super Star 采用因果多模态自回归模型,仅依赖流式语音与运动历史,无需未来音频即可预测手势,适用于直播问答、实时客服等时延敏感场景。
商业价值
- 降本:替代真人主播或客服的重复性劳动,减少人力与动捕采集成本。
- 增收:数字人可 7×24 小时在线,提升用户互动时长与转化率。
- 体验提升:自我进化训练循环能吸收在线用户反馈持续优化,使手势更符合用户偏好,提高自然度与满意度。
与现有工作流接口
可直接集成到流式 TTS + LLM 语音响应管线中:TTS 输出音频 token,手势模型消费音频 token 与运动历史 token,生成骨骼动画并输出至 Unity/Unreal 或 WebRTC 渲染端。离线数据合成管道可复用现有对话语料与动捕数据;部署时以推理微服务形式插入现有数字人栈,前端无需改动。
具体 use case:电商直播中用户实时提问,数字人在语音回答的同时生成同步手势;在线教育虚拟教师讲解概念时,通过手势强调关键信息,提升教学沉浸感。
局限
- **依赖合成数据与种子动作捕捉**:该方法需要预先构建的冷启动动作捕捉数据集(Cold-start motion capture dataset)来训练离线手势生成器,并依赖合成对话数据扩充训练样本。如果缺少种子数据或目标场景与虚拟伴侣对话差异较大,合成数据分布的偏差会直接影响在线模型性能。论文自承认“Dependence on synthesized interaction data”和“Generalization without seed data”,表明在全新 embodiment 或非对话场景下的泛化能力有限。
- **在线约束下长时程规划不足**:由于采用因果建模,模型只能基于当前和过去的音频片段预测手势,无法像离线方法那样利用完整语音进行全局规划。这可能导致长时间交互中手势序列的语义连贯性和节奏一致性下降,尤其对于需要前瞻性动作(如指向未来提及的对象)的情况表现欠佳。论文将“Long-horizon planning under strict online constraints”列为未来工作,说明当前方案在复杂长对话中仍有明显局限。