对齐中的语言链:跨语言排序偏好优化
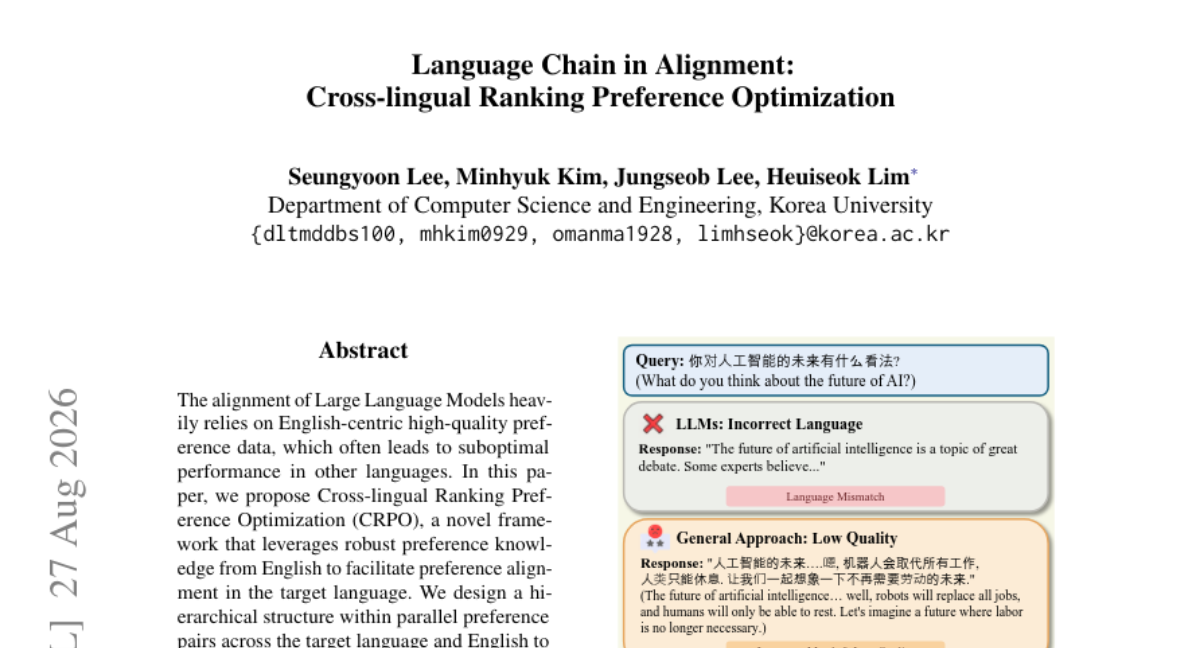
大语言模型的对齐高度依赖以英语为中心的高质量偏好数据,这往往导致模型在其他语言上的表现欠佳。为此,我们提出跨语言排序偏好优化(CRPO),一种利用英语的稳健偏好知识来促进目标语言偏好对齐的新框架。我们在目标语言与英语的平行偏好对中设计层次化结构,联合优化语内偏好(intra-lingual)与语际偏好(inter-lingual),从而增强语言适配性与输出质量。 基于 LambdaLoss 框架,CRPO 超越了传统的二元比较优化,通过多个候选响应提供相对排序信号。我们在五种资源规模不同的语言上开展实验,结果表明 CRPO 在指令遵循与知识利用能力上均稳定优于标准方法。值得注意的是,不同权重方案下的稳健性能提升进一步验证了层次化设计在多语言环境中的实证有效性。此外,我们的发现强调 CRPO 显著改善了奖励边际(reward margins)及理想响应的对数概率,有助于形成更稳定的跨语言对齐偏好流形。代码已开源:https://github.com/dltmddbs100/CRPO。
论文精读
TL;DR CRPO 将英语偏好知识通过 LambdaLoss 排序目标迁移到目标语言,联合优化语言内与跨语言排序,显著提升多语言指令遵循与知识利用。
问题
问题背景
LLM 对齐(alignment)依赖大规模高质量偏好数据,但现有偏好语料高度以英语为中心,导致模型在其他语言上表现明显退化。业界关注点已从单纯英语指令跟随转向多语言对齐一致性。
现有方法局限
- 主流方法如 DPO 采用二元比较损失,仅区分“好/坏”样本,无法利用多个候选之间的相对排序;在跨语言场景中,目标语言偏好数据稀缺,二元比较容易过拟合噪声。
- 直接将英语偏好数据翻译到目标语言会引入语义漂移,且翻译质量波动大,难以保持原始偏好结构。
- 现有跨语言迁移通常只在词嵌入层或共享编码器上做适配,未显式建模语言内与语言间的偏好层级,造成奖励信号在语言间不对齐。
为什么这个问题难/重要
- 偏好结构跨语言不一致:同一指令在不同语言中,理想回答的排序可能不同;单一语言训练的奖励模型会偏向英语语义,难以泛化到低资源语言。
- 数据获取成本高:为每个目标语言单独标注高质量偏好数据不现实,尤其是低资源语种;需要有效利用已有的英语偏好知识。
- 工程影响直接:多语言产品(如全球客服、多语种助手)要求模型在非英语输入下也能准确遵循指令并正确使用知识,现有对齐方法常导致“英语以外”的灾难性遗忘或性能骤降。
原作者核心论点:CRPO 通过平行偏好对构建跨语言层次结构,联合优化语言内和语言间相对排序,从而把英语的稳健偏好知识迁移到目标语言。
行业类比
如同多语言代码补全工具:训练数据以英语注释和函数名为主,但用户用西班牙语或日语写注释时,模型若不经过跨语言排序对齐,就会错误理解意图或输出风格不一致;CRPO 相当于在偏好层建立一条跨语言“排序链”,让模型在不同语言间保持一致的偏好标准。
核心洞察
- CRPO 的核心创新在于将跨语言偏好对齐从二元对比提升到多响应排序,借助 LambdaLoss 的 ranking 信号而非单一的 chosen/rejected 对。这种方式相比 DPO 等基线更能捕捉细粒度偏好差异,尤其在跨语言场景下,英语偏好知识可通过相对排序更稳健地迁移到目标语言,避免因语言差异导致的成对比较噪声。
- 论文提出的层级结构同时优化 intra-lingual 与 inter-lingual 偏好,形成“语言链式”对齐。该设计与仅做单语言对齐或独立多语言对齐不同,它显式利用英语作为高质量偏好锚点,通过并行偏好对联合训练,使目标语言模型在保持自身语言特性的同时吸收英语偏好分布,从而提升低资源语言的指令跟随和知识利用能力。
方法
输入与数据构建
- 使用平行偏好数据:每个指令包含目标语言与英语的多候选响应,并按质量标注排序。
- 构建层次结构:目标语言内部偏好对 (
intra-lingual) 与跨语言偏好对 (inter-lingual)。
关键模块:CRPO 优化目标
- 基于 LambdaLoss 框架,将标准 DPO 的二值比较扩展为多候选排序损失。
- 对每对响应计算增益差异,利用 nDCG 等加权方案(如
LambdaRank、nDCG2、nDCG2++)生成排序权重,使模型不仅区分好坏,还能保留相对位置信号。 - 同时优化目标语言内部偏好和英语到目标语言的跨语言偏好,通过语言链将英语偏好知识迁移到目标语言,缓解英语中心数据带来的偏差。
输出与训练信号
- 模型输出为策略模型,通过增大理想响应的 log-prob 与奖励边际,使跨语言偏好流形更稳定。
- 相比标准 DPO 只做二值比较,CRPO 提供相对排序信号并融合跨语言层次,这是与同类方法的差异点。
实验
实验设计
CRPO 在五种资源规模不同的语言上验证,评估覆盖 AlpacaEval 的指令跟随与知识利用任务。训练采用跨语言平行偏好对,构建目标语言与英语的层级结构,联合优化语言内(intra-lingual)和语言间(inter-lingual)偏好。基线包括标准 DPO 等二元比较方法。
关键发现
- CRPO 在所有测试语言上一致优于基线,低资源语言提升尤为明显。
- 通过 LambdaLoss 排序目标,CRPO 提供多候选相对排序信号,而非二元比较,显著扩大奖励边际(reward margin)与期望响应对数概率(log-probability)。
- 不同加权方案(如 LambdaRank、nDCG2、nDCG2++)下性能稳健,验证层级设计的有效性。
与基线对比解读
相比 DPO 仅优化成对偏好,CRPO 引入跨语言排序层级,直接利用英语高质量偏好知识迁移到目标语言,缓解英语中心数据导致的性能下降。LambdaLoss 框架使模型感知候选集内的相对排序,避免了二元比较中信息损失,从而在指令跟随和知识利用上均获得更稳定的偏好流形。
行业影响
落地场景
CRPO 适用于需要多语言指令跟随的场景,例如跨境电商平台的智能客服机器人、全球内容平台的推荐/审核、多语言 AI 助手(如办公套件中的 Copilot)。通过将英语偏好知识迁移到目标语言,可在低资源语言上快速提升模型对齐质量,减少对目标语言人工标注偏好数据的依赖。
商业价值
降低多语言对齐成本:无需为每种语言收集大量偏好对,利用英语数据即可提升其他语言性能,显著节省标注费用。同时提升用户体验:模型在多语言指令跟随和知识利用上更稳定,可减少错误输出,提高用户满意度和留存。此外,可加快新语言支持的上线周期,扩大市场规模。
与现有产品/工作流的接口
CRPO 可集成到现有 RLHF / DPO 训练管线中,替换或补充偏好优化阶段。它基于 LambdaLoss 框架,兼容 DPO 的数据格式,只需构造跨语言平行偏好对(如英语正例 + 目标语言正负例)。推理端无需额外改动,可直接部署。权重方案如 nDCG2 / nDCG2++ 提供调节粒度,便于在不同语言资源条件下调整。
具体 use case:
- 跨境电商客服机器人:支持英语 + 小语种(如泰语、越南语),用英语偏好数据训练后,机器人能更好地遵循用户指令,减少跨语言误解。
- 全球内容平台的 AI 审核:多语言评论/帖子的安全分类和指令遵循,利用英语审核偏好迁移到其他语言,提升低资源语言的审核准确率。
局限
- - 实验语言覆盖与泛化边界未充分验证:论文在五种语言上评估,但摘要未明确具体语种及资源规模分层;且未在极低资源语言、非拉丁文字或与英语语言类型差异大的语言上测试。跨语言迁移主要依赖英语偏好作为“锚点”,若目标语言与英语结构差异显著,平行偏好对的质量和可对齐性可能下降,结论未必外推。
- - 平行偏好数据构建成本与噪声未讨论:CRPO 要求目标语言与英语的平行偏好对,并对多候选响应做排序;实际工程中,为每个目标语言标注或翻译高质量偏好排序成本较高,低资源场景下种子数据稀缺,容易引入翻译噪声或标注不一致。论文未提供数据构造细节、质量控制或成本分析,这限制了该方法在真实多语言产品中的可复现性。
- - 与现有排序式偏好优化及奖励模型的对比不足:虽然论文提到超越二元比较并用了 LambdaLoss 的多种加权方案(LambdaRank、nDCG2、nDCG2++),但未系统对比其他基于排序的偏好优化方法(如 LiPO、RankDPO 等),也未在多种 reward model 或更大规模模型上验证。奖励边际和对数概率的改善是否能稳定转化为人类评估或 Arena-Hard 等外部基准的收益,仍缺乏充分证据。