VA-Judger: 从人类偏好反馈中为联合视频-音频生成进行奖励建模
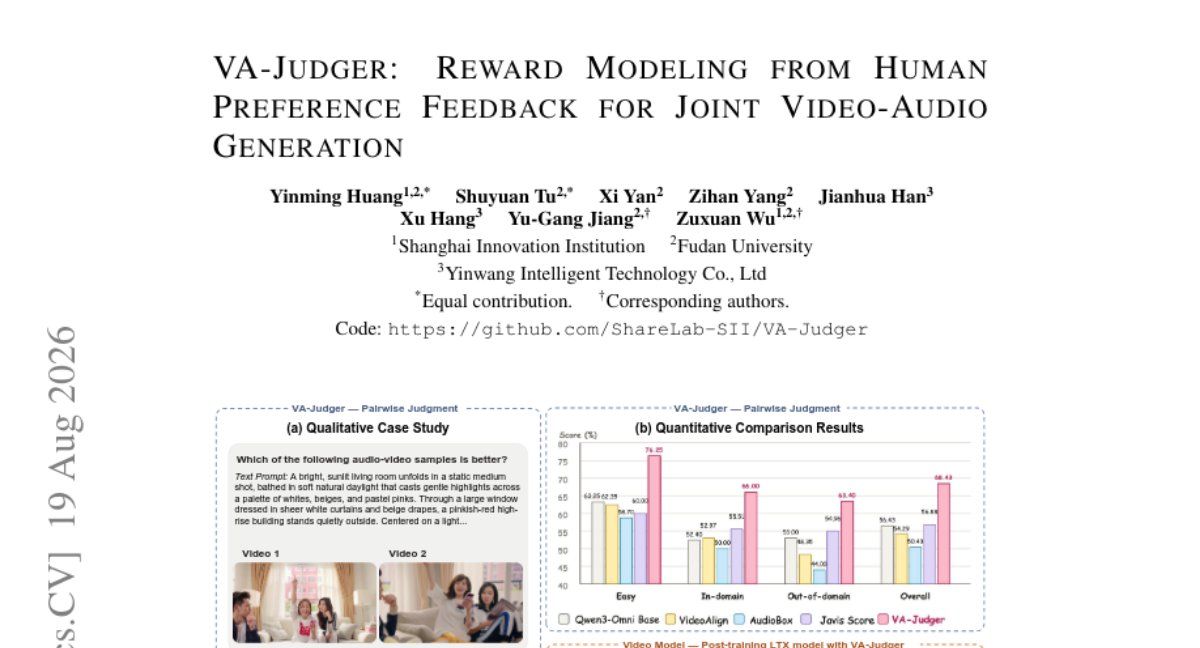
使用强化学习对联合视频-音频生成模型进行后训练需要奖励信号。现有方法通过组合音频质量、视觉保真度和同步性等指标的度量来构建奖励,但这些度量分别评估感知维度,未能捕捉文本提示、视频和音频之间塑造人类偏好的整体语义与时间连贯性。针对此类度量进行优化会诱发奖励黑客攻击,生成得分高却对人类观感不连贯或不忠实的内容。 为此,我们构建大规模人类偏好数据集 VAPref-10K,包含9K提示与10.3K条来自开源生成模型的细粒度成对比较。我们引入 VA-Judger-Bench 基准,涵盖域内与域外模型比较,以评估奖励模型是否真正对齐人类偏好。我们进一步提出 VA-Judger,一种用于联合视频-音频生成的思维链全能奖励模型。具体而言,VA-Judger 首先从具有清晰质量差异的样本对中学习,建立结构化输出与粗略偏好判别;随后利用拒绝采样为更难的近质量比较提炼可靠的偏好解释,并对照人类标注进行验证;最后执行逐维度强化学习,将人类反馈分解为各质量维度,提供比单一二元偏好标签更密集的奖励信号。 实验表明,VA-Judger 在域内与域外评估中均优于基于指标的基线。将其人类对齐奖励用于音视频生成模型后训练,也能显著提升生成质量。
论文精读
TL;DR VA-Judger 构建 VAPref-10K 人类偏好数据集与链式思维奖励模型,用维度级强化学习替代碎片化指标,解决视频-音频生成中的奖励欺骗并显著提升生成质量。
问题
联合视频-音频生成(joint video-audio generation)模型近年来发展迅速,通过强化学习(RL)进行 post-training 成为提升生成质量的关键路径,但 RL 需要一个可靠的奖励信号。
现有方法通常将音频质量、视觉保真度、音画同步等单维度指标加权组合作为 reward。这些指标彼此独立地评估感知维度,无法建模文本提示、视频、音频三者之间的整体语义与时间一致性,更与真实人类判断对齐较差。直接优化这类组合指标会诱导 reward hacking:模型倾向于生成在各项指标上得分很高、但人类观看时明显不连贯或不忠实于提示的内容。
这个问题难在:人类对视频-音频内容的偏好是多维、隐式且高度主观的,构建大规模人类偏好数据成本高、标注一致性难保证;同时,缺少与人类判断对齐的 reward model,RL 后训练容易朝错误方向优化,反而损害生成体验。业界对多模态生成质量的评估要求已从“分维度合格”升级为“整体体验可信”,reward model 的可靠性成为关键瓶颈。
类似 LLM 的 RLHF 中 reward model 需要超越 BLEU/ROUGE 等表面指标、捕捉语义与风格偏好,视频-音频生成同样需要一个全模态奖励模型(omni-reward model)来替代碎片化 metric。
核心洞察
- 提出从整体人类偏好而非分项指标来建模视频-音频生成质量,以规避奖励黑客。现有方法将音频质量、视觉保真、同步性等指标线性组合作为奖励,各维度独立评估,无法捕获文本、视频、音频三者间的语义与时序连贯性;VA-Judger 通过链式思维进行全局判断,使奖励信号对齐人类整体观感,而非片面追求单项高分。
- 引入课程式人类偏好对齐:先用质量差距明显的易样本建立结构化输出与粗粒度判别,再用拒绝采样从难样本中蒸馏可靠偏好解释。相比直接对近质量样本做监督微调,这种两阶段策略降低了标注噪声与模型不确定性引入的错误奖励,提升了难样本上偏好预测的可靠性。
- 提出维度级强化学习,将人类反馈分解为音频质量、视觉保真、同步性等维度生成稠密奖励,替代单一二元偏好标签。这为生成模型 post-training 提供更细粒度的梯度信号,缓解稀疏奖励问题,同时保持与整体偏好一致,避免各维度独立优化时的不协调。
方法
输入与数据构造
输入为文本提示、视频-音频对及其人类偏好标注。论文构建 VAPref-10K 数据集,包含 9K 个提示和 10.3K 个细粒度成对比较,均来自开源联合生成模型;同时建立 VA-Judger-Bench 基准,覆盖 in-domain 与 out-of-domain 模型比较,用于评估奖励模型与人类偏好的一致性。
训练流程(三阶段)
- Easy Cold-start:先利用质量差距明显的 pairs 进行监督微调,让模型学习链式思维(chain-of-thought)的结构化输出格式,并建立粗粒度偏好判别能力。
- Hard Preference Alignment:对质量接近的难样本,通过 rejection sampling 生成偏好解释,仅保留与人类标注一致的样本,蒸馏出可靠的推理依据。
- Dimension-wise Reinforcement Learning:将整体偏好反馈分解为音频质量、视觉保真度、音画同步等独立维度,获得比单一二元标签更密集的奖励信号,指导生成模型 post-training。
输出与差异
输出一个 human-aligned 的 omni-reward model,可直接作为 RL 的 reward signal。与现有方法拼接独立指标(如音频质量、视觉保真度、同步性)不同,VA-Judger 显式建模文本-视频-音频的全局语义与时间一致性,并通过维度分解强化学习避免 reward hacking。
实验
实验设计
构建 VAPref-10K 人类偏好数据集,包含 9K prompts 和 10.3K 细粒度成对比较,来源为开源视频-音频生成模型。引入 VA-Judger-Bench 基准,覆盖 in-domain 与 out-of-domain 模型比较,用于评估奖励模型是否真正对齐人类偏好。
训练采用课程学习策略:
- 先用质量差距明显的样本进行冷启动,建立结构化输出与粗粒度偏好判别;
- 再针对难样本(near-quality pairs),通过 rejection sampling 蒸馏可靠偏好解释;
- 最后执行 dimension-wise reinforcement learning,将人类反馈分解到各质量维度,获得比单一二值标签更密集的奖励信号。
关键发现
实验表明 VA-Judger 在预测人类偏好上显著优于现有 metric baselines,在 in-domain 和 out-of-domain 评估中均取得更好表现。将其人类对齐的奖励用于 post-training 视频-音频生成模型 LTX-2 后,生成质量获得显著提升,定量与定性结果一致,并通过人类评估验证。
与基线对比解读
现有方法组合音频质量、视觉保真度、同步性等独立指标作为奖励,但这些指标分割评估感知维度,无法捕捉文本、视频、音频三者间的整体语义与时序一致性,导致优化时出现 reward hacking。VA-Judger 作为 chain-of-thought omni-reward model,直接输出推理过程与整体偏好判断,提供更符合人类主观感受的稠密奖励,有望替代碎片化指标组合,成为视频-音频联合生成强化学习的可靠基础。
行业影响
落地场景
VA-Judger 作为 joint video-audio generation 的奖励模型,可直接用于 视频配音、有声内容生成、虚拟主播、互动娱乐 等产品。典型场景包括:
- 电商营销视频:根据商品文案自动生成匹配的解说音频与动态视频,保证语义一致性;
- 在线教育:生成课件动画配语音,时序对齐提升学习体验;
- 内容平台:将文本故事转为有声短视频,降低创作门槛。
商业价值
传统生成模型依赖分项指标(音频质量、视觉保真、同步性)导致 reward hacking,产出的内容虽指标高但观感割裂。VA-Judger 通过 人类偏好数据 与 chain-of-thought 奖励 对齐整体语义与时间一致性,能:
- 减少人工审核成本:自动筛选生成结果,降低低质内容的无效分发;
- 提升用户留存:连贯的视频-音频内容带来更好的观看体验;
- 加速模型迭代:作为 RL 后训练的可靠奖励信号,替代昂贵的人类反馈循环。
与现有产品/工作流的接口
VA-Judger 可部署为 评分服务,接入现有生成 stack:
- 生成模型(如 LTX-2 等 joint video-audio 模型)产出候选内容;
- VA-Judger 输出 维度级奖励 与整体偏好分数;
- RL 训练框架(如 GRPO)利用该奖励更新生成策略。
工程上,VAPref-10K 数据集与 VA-Judger-Bench 基准可用于验证奖励模型的对齐程度。与现有指标式 reward 相比,VA-Judger 的 dimension-wise RL 提供更稠密的梯度信号,减少训练不稳定。
实际集成时,可将 VA-Judger 封装为轻量级 API,与 Hugging Face 生态、DeepSpeed 等训练框架兼容,支持在线偏好打分与离线批量评估。
局限
- **数据集规模与来源偏差**:VAPref-10K 包含约 9K prompts 和 10.3K 对比,对于视频-音频联合生成的高维空间而言规模偏小,可能难以覆盖复杂语义和时序组合。对比数据仅来自开源生成模型,未包含专有模型或未来模型产生的分布,导致奖励模型在面对新架构输出时泛化性存疑。人类标注者自身存在主观偏好与不一致性,且标注成本限制了对比数量,可能引入系统性偏差,影响奖励模型的真实对齐能力。
- **方法复杂度与多阶段设计风险**:VA-Judger 采用链式思维、拒绝采样蒸馏和维度级强化学习,虽然提升了偏好建模精度,但大幅增加了工程复杂度与计算开销。链式思维解释依赖 MLLM 生成,可能产生与真实偏好不一致的幻觉;拒绝采样筛选高置信解释的阈值需人工设定,可能误删有效样本或保留噪声;维度分解后的密集奖励信号虽然缓解了稀疏性问题,但人类对视频-音频的整体感知不一定可线性分解,各维度权重权衡复杂,可能破坏整体偏好结构。
- **评估基准与后训练泛化有限**:VA-Judger-Bench 虽包含 in-domain 和 out-of-domain 对比,但整体规模较小,且评估仅关注偏好预测准确率,未深入分析奖励模型的校准性、对抗鲁棒性和跨分布稳定性。使用 VA-Judger 进行生成模型后训练仅在 LTX-2 单一架构上验证,其提升效果能否迁移至其他联合生成模型尚未可知。此外,缺少与现有视频奖励模型(如 VideoScore、LiFT)或基于大语言模型评分的系统对比,无法充分证明所提方法在同类工作中的相对优势。