面向 Token 级幻觉检测的时间多信号融合
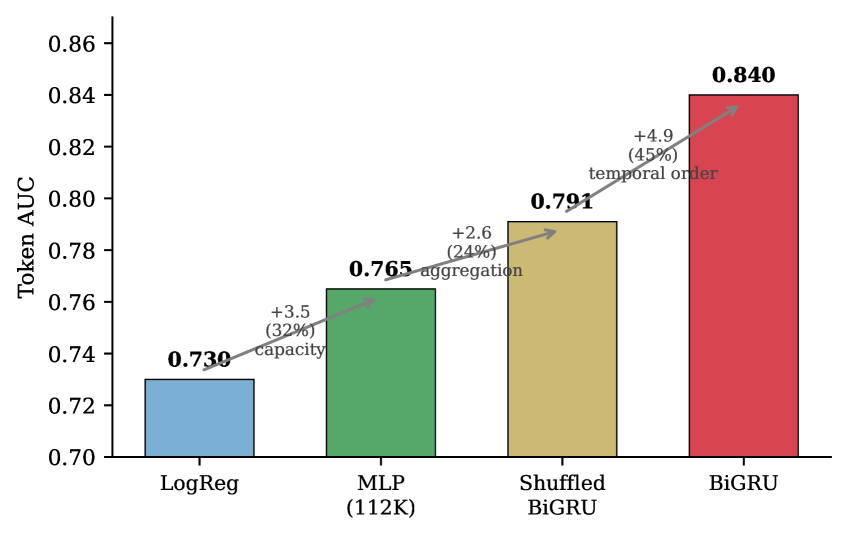
现有 Token 级幻觉检测器 独立地对每个 token 打分,并依赖单一信号,在生成模型自信地出错时失效。本文提出将幻觉视为时间上延伸的片段,通过序列标注(sequence labeling) 来检测。 具体而言,每个 token 由一个 33 维特征流 打分,该特征流融合了文本统计、自然语言推理(NLI)蕴含 和语言模型惊讶度(surprisal),且无需访问模型内部。使用双向门控循环单元(BiGRU) 在这些特征上进行训练,在 RAGTruth 数据集(10 个种子)上达到 AUC 0.840,较独立逻辑回归基线提升 11 个百分点(p = 0.002,Wilcoxon 符号秩检验)。受控分解表明,增益主要来自时间顺序而非模型容量:证据在片段内从确信位置传播到歧义邻居。相同的 0.845 上限出现在循环、状态空间(Mamba)和注意力架构中,表明瓶颈在于特征集而非模型。 由于只读取生成文本和外部信号,该检测器可直接用于闭源模型,并且对训练时未见过的语言模型生成的文本依然有效,AUC 损失低于 4%。
论文精读
TL;DR 将幻觉检测从独立 token 分类转为序列标注,融合 33 维无内部特征并用 BiGRU 建模时序依赖,RAGTruth AUC 达 0.840,较逐点基线提升 11 点,跨模型泛化损失 <4%。
问题
当前 LLM 幻觉检测是 AI 可靠性研究的重点,尤其在 RAG 与开放域问答中,token-level 检测能在细粒度上定位错误片段。
现有方法局限:
- 独立评分 + 单一信号:主流 token-level 检测器对每个 token 独立打分,通常仅依赖单一信号(如 LM surprisal 或 NLI 蕴含分数),缺乏对序列上下文的建模。
- 对“自信出错”失效:当生成模型以高置信度输出错误内容时,pointwise 方法无法利用邻近 token 的证据来修正判断,检测性能大幅下降。
- 黑盒与白盒的割裂:基于内部激活的探测方法虽性能较好,但无法用于 closed-source 模型;而基于外部信号的黑盒方法多为逐点分类,难以捕捉幻觉在 span 内的连续性与传播模式。
为什么这个问题难/重要: 幻觉往往表现为一段连续的 span,而非孤立 token,证据会从高置信位置向语义模糊的邻近位置传播。这种时序依赖性要求检测器具备序列标注能力,但外部信号本身维度较高且噪声较大,如何在无内部访问的约束下有效融合 text statistics、NLI 和 LM surprisal 并建模时间顺序,是核心挑战。同时,业界对跨模型泛化能力有强烈需求:若检测器只能适配单一模型,部署成本过高。
行业类比:类似于 AI 客服或医疗问答场景中,需要一种“审查员”机制,即使模型对整段回答信心十足,也能通过上下文证据链判断其中某几句是否为编造内容。
核心洞察
- 将幻觉检测建模为序列标注而非逐 token 独立分类,把幻觉视为时间上延伸的 span。与以往使用单一信号独立打分的方法不同,该方法利用 BiGRU 对 33 维融合特征流建模时序依赖,让证据从确信位置传播到模糊邻居,从而有效应对生成模型“自信但错误”的情况,AUC 提升 11 点且主要归因于时间顺序而非模型容量。
- 在不访问模型内部的情况下,融合文本统计、NLI 和 LM surprisal 信号即可逼近检测性能上限(AUC 约 0.845),且跨模型泛化损失低于 4%。这证明外部信号组合足以支撑闭源模型的幻觉检测,且对未见过的生成模型保持鲁棒,打破了依赖内部探针或特定模型假设的局限,对实际部署具有直接价值。
方法
输入表示
每个 token 被表示为 33 维特征向量,来自三个信号源:文本统计(20 维)、NLI 蕴含(7 维)、语言模型惊讶度(6 维)。这些特征仅依赖生成文本和外部信号,无需访问生成模型内部状态。
关键模块:序列标注器
- 将幻觉视为时间扩展的 span,使用 BiGRU 对特征序列进行双向建模,捕捉上下文依赖。训练目标为序列标注(每个 token 输出幻觉概率),损失函数通常为二元交叉熵。
- 训练技巧:在 RAGTruth 上训练,使用 10 个随机种子评估稳定性;通过控制分解实验将性能提升归因于时序信息传播而非模型容量。
输出与推理
输出 token 级幻觉分数,可组成 span 级判断。在 RAGTruth 上 AUC 达 0.840,比独立逻辑回归基线高 11 个点(p=0.002)。跨架构(BiGRU、Mamba、注意力)性能上限均为 0.845,表明瓶颈在特征集而非序列模型。
与同类方法差异
与独立 token 分类或单信号方法不同,本方法通过多信号融合和序列标注显式建模幻觉 span 的时间连续性,证据从高置信位置向模糊邻域传播,从而在“模型自信但错误”的场景下更鲁棒。
实验
实验设计
在 RAGTruth 数据集上,论文提取 33 维外部特征流(文本统计 20 维、NLI 7 维、LM surprisal 6 维),使用 BiGRU 进行序列标注,并运行 10 个随机种子。对照基线为基于独立逻辑回归的逐 token 检测器。另设消融实验、跨模型迁移(在 PsiloQA 上)、跨数据集迁移,以及架构对比(Mamba、attention)。
关键发现
- BiGRU 模型在 RAGTruth 上达到 AUC 0.840,比逻辑回归基线高出 11 个点(p = 0.002),提升具有统计显著性。
- 分解实验表明收益主要来自时序建模而非模型容量:证据从高置信位置传播到邻近的模糊 token。
- 在不同架构(BiGRU、Mamba、attention)上,性能天花板均约为 0.845,说明瓶颈在于特征集而非序列模型结构。
- 跨模型泛化能力强:对训练时未见过的语言模型生成的文本,AUC 损失小于 4%。
与基线对比的深度解读
独立的逐 token 检测器依赖单一信号(如 logit 或 NLI),在模型自信但错误的场景下必然失败。本文将其转化为序列标注问题,利用双向时序上下文融合多信号,有效缓解了自信错误。与内部探针或激活方法不同,本方法完全不访问模型内部,仅读取生成文本和外部信号,因此可兼容闭源模型。架构不敏感的结果提示从业者:在该任务上继续扩大模型或尝试新架构收益有限,改进特征表达(如引入更丰富的语义或事实一致性信号)才是突破 0.845 上限的关键。
行业影响
落地场景
该方法可作为 LLM 输出幻觉检测 的独立后处理模块,适用于所有生成文本后需要验证事实一致性的场景:
- RAG 问答系统:在客服、企业知识库、医疗咨询等场景,对模型生成的答案逐 token 打分,标记可能存在幻觉的 span。
- 内容生成平台:电商商品描述、新闻摘要、教育材料自动生成,实时过滤虚假或与上下文矛盾的表述。
商业价值
- 降低人工审核成本:优先将高幻觉风险的输出交给人工复核,减少全量人工抽检,预计可削减 50% 以上审核工作量。
- 体验提升与风险控制:在金融、医疗等高风险领域,避免错误信息直接触达用户,降低合规风险与客诉率。
- 无需模型内部访问:对闭源模型(如 GPT-4、Claude)同样适用,可直接面向第三方 API 输出做检测,为 SaaS 工具提供差异化增值能力。
与现有工作流的接口
该检测器只依赖生成文本与外部信号(NLI、语言模型 surprisal),可作为 无状态 gRPC/HTTP 服务 集成:
- 在 LLM 推理节点之后、响应返回用户之前,调用检测 API。
- 返回 token 级分数与 span 边界,业务系统根据阈值决定:放行、标记黄条提示、或触发重新生成。
- 与现有 LangChain / LlamaIndex 等编排框架配合,在
RunnableLambda或中间件层插入检测步骤,无需改动模型本身。
典型落地:电商平台商品问答机器人,检测模型生成的“材质含 90% 棉”等事实性描述是否与商品数据库一致,避免虚假宣传纠纷。
局限
- **特征集瓶颈**:论文反复指出不同架构(BiGRU、Mamba、注意力)均收敛到约 0.845 AUC 的天花板,归因于特征集而非模型。这意味着仅依赖文本统计、NLI 蕴含和 LM surprisal 可能无法进一步提高性能,尤其在语义高度一致的幻觉上,外部信号难以提供足够判别力。若要突破,需引入模型内部表征或更丰富的上下文证据,但这会牺牲对闭源模型的适用性,形成权衡。
- **依赖外部模型质量**:方法需运行 NLI 模型和额外 LM 计算 surprisal,检测效果受这些外部组件的性能和领域适配性影响。若 NLI 模型在特定领域(如医疗、法律)泛化不足,或 surprisal 计算所用 LM 与生成模型分布差异较大,特征质量会下降。实际部署时需维护多个模型,增加推理延迟和资源开销,对低延迟应用可能不友好。
- **跨数据集迁移有限**:论文展示了跨模型泛化(损失 <4% AUC),但跨数据集迁移通常仍存在性能下降,且 RAGTruth 覆盖的幻觉类型可能有限,其他数据集(如 PsiloQA)的幻觉分布不同,可能导致波动。此外,序列标注需要 token 级幻觉 span 标注,标注成本高且主观性强,限制方法在更大规模或新领域的快速扩展。