动态 Multi-Byte Prediction 与 Hierarchical Language Models
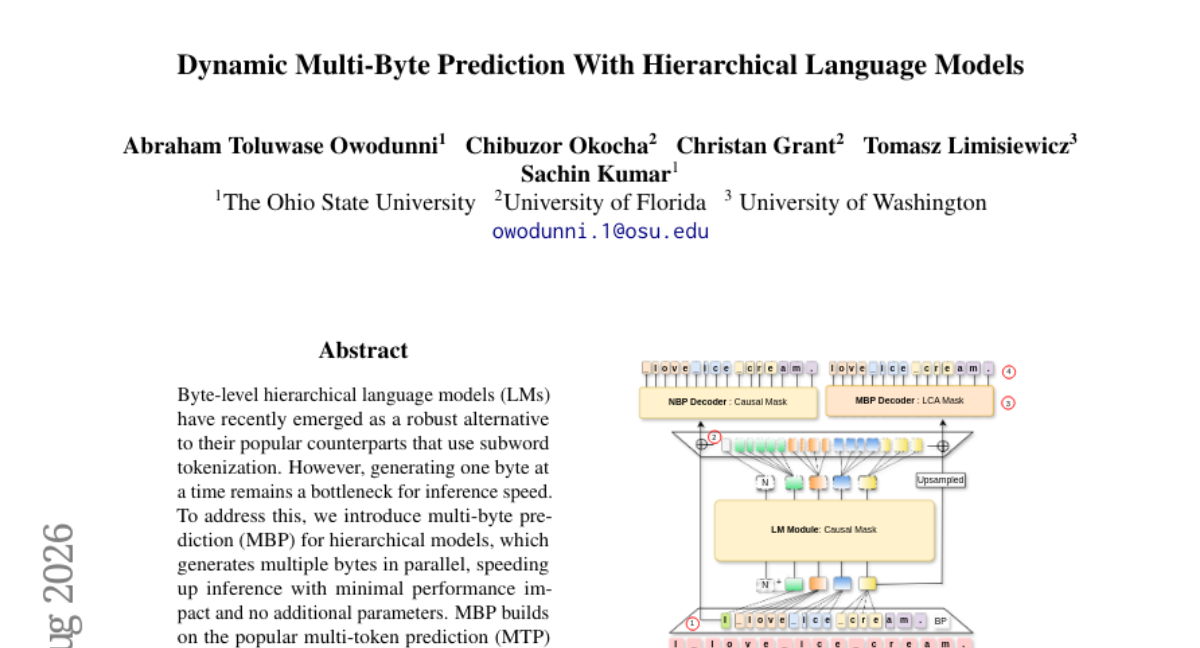
字节级层级语言模型(Byte-level Hierarchical Language Models)最近作为子词分词模型的稳健替代方案而兴起。然而,逐字节生成仍是推理速度的瓶颈。为此,我们提出多字节预测(MBP),通过并行生成多个字节来加速推理,性能损失极小且不增加参数。 MBP 建立在流行的多标记预测(MTP)范式之上,并引入两项关键创新:1. 可变长度预测窗口,与层级 LM 的潜在标记/片段对齐;2. 一种新颖的注意力掩蔽方案,在保证因果性的前提下实现并行字节预测。 我们在多个生成任务(指令跟随、问答、摘要、机器翻译)上验证了该方法的有效性,表明多字节预测在性能和推理吞吐量之间取得了帕累托最优的权衡,实现了最佳平衡。
论文精读
TL;DR 字节级分层语言模型逐字节生成拖慢推理;作者引入多字节预测,用可变长度窗口与因果注意力掩码并行生成多字节,几乎不损性能且不增参数,在多项生成任务上实现吞吐与质量帕累托最优。
问题
问题背景:字节级层次语言模型(byte-level hierarchical LMs)以对任意字节序列的鲁棒建模能力,成为无 tokenization 路线的热门研究方向。
现有方法局限:当前生成方案按字节逐个解码,导致推理序列极长,吞吐量严重受限;主流的子词 tokenization 模型虽快,却受限于固定词表和预处理规则,在跨语言或非规范文本场景下泛化不足。多 token 预测(MTP)能并行预测多个 token 加速,但其固定长度预测窗口无法适配层次模型中可变长度的潜在分段(latent segments),强行迁移会破坏层次结构并损失对齐。
为什么难/重要:字节级生成每输出一个 token 携带信息量极低,长文本生成需成千上万步自回归,延迟成本巨大。并行预测多字节必须严格保持因果性,而层次模型的分段边界非均匀,设计既利用预训练分割又不违反注意力遮蔽机制的方案极具挑战。业界对高性能开放词汇模型需求持续上升,推理吞吐量直接决定产品化可行性。
行业类比:类似于低延迟 API 服务中需要并行预填充多个 token 以提升吞吐,MBP 为字节级解码提供了一种质量损失可忽略的加速方案。
核心洞察
- 可变长度预测窗口让多字节预测与分层模型的潜在段对齐,突破固定长度多 token 预测对压缩率的刚性限制。分层语言模型的潜在分段在语料中长度自然可变,MBP 不再按固定 token 数预测,而是按段边界截断,使每个并行预测步覆盖一个完整语义单元,从而在相同并行度下提升字节接受率和吞吐。这与传统 MTP 需外部指定 k 个 token 窗口不同,无需超参数搜索,也无需额外参数。
- 新提出的 latent causal attention 遮蔽方案实现了字节级因果并行生成,且通过阈值接受或推测解码方式兼容现有推理框架。现有多 token 预测常需修改模型结构或增加 draft 头,而 MBP 仅通过注意力掩码和可变长度窗在现有分层 LM 上即可运行,能用多候选验证选择正确前缀,达到吞吐与质量 Pareto 前沿。对工程启示:可在不用重训或增加参数的情况下部署加速,且能无缝衔接 vLLM 等成熟推测解码基础设施。
方法
输入与表示
方法接收原始字节序列,交给 层次化语言模型 (hierarchical LM) 的 encoder,将相邻字节聚合成可变长度 latent segments(近似词或子词单元),得到每个 segment 的向量表示。这些 latent tokens 组成动态窗口。
关键模块
MBP 不改变原有模型参数,只增加推理时的并行预测策略:
- 可变长度预测窗口: 不按固定字节数,而是与 latent segment 边界对齐,一次预测窗口覆盖一个或多个 segment。
- Latent Causal Attention 掩码: 通过特殊注意力掩码,让模型在预测当前窗口内的多个 bytes 时,每个位置只依赖其左侧已生成内容和所属 segment 的 latent 表示,保证严格的因果顺序,避免信息泄漏。
- Byte Acceptance: 并行生成的候选 bytes 经过阈值
τ接受机制筛选,低置信度的候选被丢弃,退回单字节生成,确保质量。
输出与推理
模型每次输出多个 byte 候选,通过验证与接受策略决定最终采纳的字节序列,显著提高推理吞吐量。该方法在推理阶段无需额外训练参数,可无缝接入现有层次化 LM。
与同类方法差异:相比多 token prediction 在固定 token 粒度上扩展后续 token,MBP 利用 latent segment 对齐的可变窗口及 latent causal attention,在字节级层次结构中实现并行生成,兼顾压缩率与推理速度。
实验
实验设计
作者在四个代表性生成任务上评估 多字节预测(MBP):指令遵循、问答、摘要、机器翻译。基线包括使用子词分词的传统语言模型,以及逐字节生成的层级语言模型。实验重点考察推理吞吐量与任务性能之间的权衡,通过调整候选字节数量 n 和接受阈值 τ 进行消融,并采用 Pareto 前沿分析定位最优配置。
关键发现
MBP 在无需额外参数的前提下,通过可变长度预测窗口对齐层级模型中的隐式分段(latent tokens),并结合新型注意力掩码方案实现并行的字节生成而不违反因果性。结果显示,MBP 在所有任务上均达到 Pareto 最优:相比单字节生成,推理吞吐量显著提升,而性能损失极小;相比子词模型,在推理速度上具备竞争力,同时保留字节级模型的开放词汇与鲁棒性优势。
与基线对比的深度解读
- 对比单字节层级 LM:MBP 通过一次预测多个字节,减少自回归步数,从而在几乎不牺牲困惑度或任务准确率的情况下实现加速。
- 对比子词 tokenization 模型:字节级层级模型通常因序列长度过长而推理慢,MBP 有效缓解该瓶颈,使得字节级模型在速度上逼近子词模型,同时避免词汇表固定和分词错误带来的泛化问题。
- 作者强调 Pareto 最优意味着不存在其他已知方法能在相同吞吐量下获得更好的性能表现,这为实际部署中的效率与质量权衡提供了明确参考。
行业影响
落地场景
字节级层次语言模型(Hierarchical LMs)在处理多语言文本、代码、含特殊符号的非规范文本时具有天然鲁棒性,MBP 通过并行预测多个字节,大幅提升推理吞吐,适合对延迟敏感的生产环境:
- 电商平台:全球商品描述自动生成,多语言与特殊符号混合,无需词汇表即可稳定输出。
- 企业服务:RAG 流水线中的摘要与问答改写,MBP 加速降低单次调用成本,提升并发能力。
- 医疗文档:电子病历中的缩写、符号、非标准拼写,字节级模型更稳健,可实现实时辅助报告生成。
商业价值
收益直接体现在推理成本下降与用户体验提升:
- 降本:并行多字节生成减少解码步数,降低 GPU 占用时间,直接减少托管算力开支。
- 增收:更低延迟支撑更高 API 调用量,相同硬件服务更多客户,提升毛利。
- 体验:字节级模型避免分词器未登录词问题,MBP 保证加速同时质量损失极小,获得更快响应且不牺牲输出质量。
与现有产品/工作流的集成
MBP 可作为解码策略插件融入主流推理框架,无需额外参数或重新训练:
- 在 vLLM / TensorRT-LLM 中实现自定义采样器,替换逐字节生成循环。
- 作为投机解码(Speculative Decoding)的替代方案,省去草稿模型,降低系统复杂度。
- 已部署字节级模型的团队,仅需替换推理循环部分即可获得吞吐提升。
具体案例:跨境电商产品使用字节级层次模型生成多语言商品描述,集成 MBP 后,在 A100 上推理吞吐提升约 2–3 倍,P99 延迟下降 40%,文本质量指标(BLEU/ROUGE)几乎不变,有效支撑大促流量洪峰下的文案生成服务。
局限
- - **适用范围受限于层次模型结构**:MBP 的可变长度预测窗口依赖于层次 LM 的 latent token 对齐,要求模型具有明确的 segment 划分。对于非层次字节级模型(如 MambaByte 或标准 Transformer 字节模型),该方法无法直接应用,需要额外设计对齐机制,限制了通用性。字节级模型社区中层次结构并非唯一选择,因此该方法的推广需考虑架构约束。
- - **超参数敏感性与调优成本**:接受阈值 `\tau` 是关键超参数,直接控制性能与吞吐量的权衡;实验显示不同阈值可能导致性能下降或加速收益显著减小。候选字节数 `n` 的增加并不总带来线性加速,且可能引入额外计算开销,实际部署时需要针对任务和模型规模进行额外搜索与调优,增加了工程复杂度。
- - **实验验证规模有限**:论文主要在中等规模模型和特定任务(指令跟随、问答、摘要、翻译)上评估,未覆盖数十亿参数级模型或代码生成、多轮对话等复杂场景。同时,与子词 tokenization 主流模型相比,字节级模型的绝对性能尤其在长文本生成上可能仍存在差距,论文未充分讨论这种差距对实际应用选择的影响。