严重声学偏移下基于原型校正的迭代自监督流形去噪
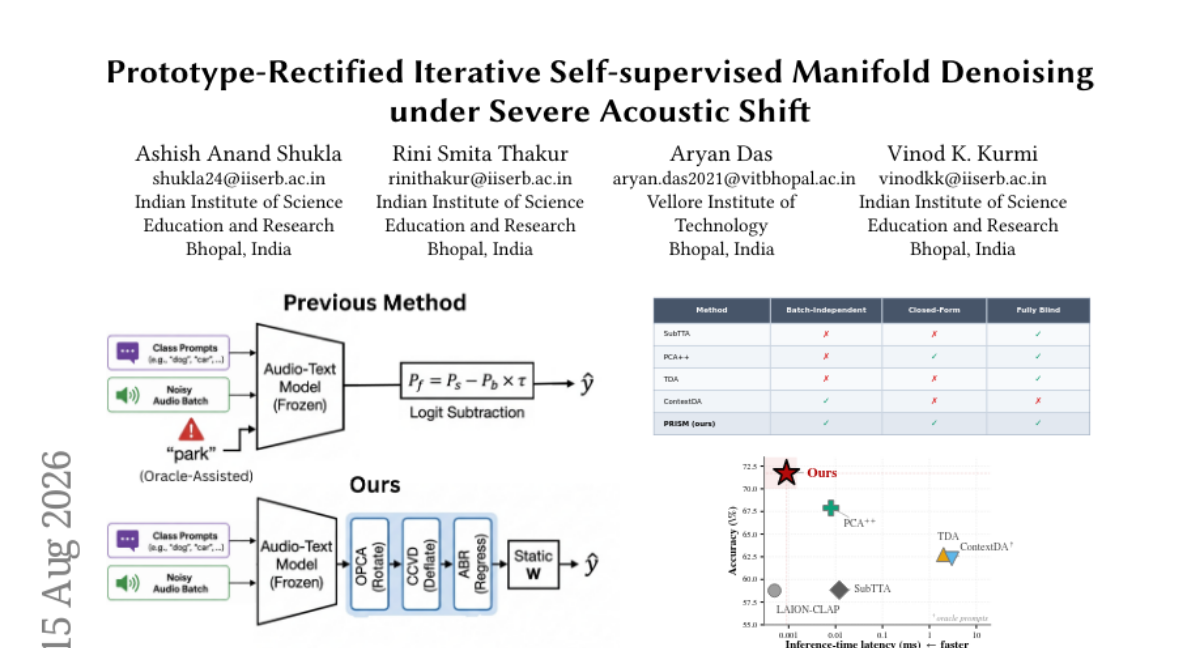
问题:音频-文本基础模型(Audio-Text Foundation Models, ATMs)在严重声学噪声下性能大幅下降。现有测试时自适应(Test-Time Adaptation, TTA)方法要么依赖梯度更新,反而强化噪声而非信号;要么需要特权噪声标注(如 prompt tuning),这在推理时无法获得。 方法:我们提出 PRISM(Prototype-Rectified Iterative Self-supervised Manifold Denoising),一种无训练、无源的测试时自适应框架。其核心是 仿射噪声假设(Affine Noise Hypothesis):严重声学噪声会在多模态潜在空间中引发低秩仿射偏移,且超过 90% 的畸变能量集中在前 60 个主成分中。PRISM 以冻结的文本原型作为几何锚点,通过三个闭式几何校正量——合并为单个静态投影矩阵(仿射偏差回归, Affine Bias Regression)——从无标注目标批次中估计并逆转该畸变。推理时仅需一次矩阵-向量乘法(约 0.0009 ms),速度远快于基于梯度的 TTA,且无需额外训练。 实验:在 UrbanSound8K 上,PRISM 比零样本基线高出 12.94 个百分点,并超越 oracle 辅助的 TTA 基线 9.41 个百分点。此外,我们识别出 复音陷阱(Polyphonic Trap),即子空间去噪对宽带类失效的模式,并通过 置信度感知回归(Confidence-Aware Regression, CAR)解决,为受影响最严重的类别恢复最多 8.16 个百分点。
论文精读
TL;DR PRISM 在严重声学噪声下,为 Audio-Text Foundation Models 提供无需训练、源无关的 test-time adaptation:用低秩仿射噪声假设和几何校正编译出静态投影矩阵,推理仅一次矩阵乘法,精度提升 12.94 个百分点且速度远快于梯度 TTA。
问题
问题背景
Audio-Text Foundation Models (ATMs) 在常规声学条件下已展示出强大的零样本泛化能力,但面对严重声学偏移(如室内混响、机械噪声、远场拾音)时,性能会出现灾难性下降。行业当前聚焦于 Test-Time Adaptation (TTA) 与提示微调,希望在不重新训练的前提下恢复模型鲁棒性。
现有方法局限
- 梯度基 TTA:在目标噪声批次上直接更新模型参数,容易强化噪声而非信号——因为没有可靠监督,梯度方向常被噪声主导,导致模型越适应越偏;同时计算开销大,难以满足边缘推理的实时要求。
- 提示微调 / Oracle 辅助方法:例如 ContextDA,需要特权噪声标注(privileged noise prompts)来指导适应,而真实推理场景根本拿不到这些标注,无法落地。
- 常规子空间去噪:使用 PCA 或 deflation 去除噪声成分时,容易误删语义方差——尤其是宽带类(broadband classes)的信号与噪声在频谱上高度重叠,导致“去噪”反而损害判别信息,即 PRISM 提出的 Polyphonic Trap。
为什么这个问题难/重要
严重声学偏移在 latent space 中表现为低秩仿射变换(>90% 失真能量集中在前 60 主成分),但该偏移必须从无标签、无源数据的目标批次中盲估。同时,工业部署要求训练自由(不更新模型权重)和极低延迟(PRISM 的单次推理仅需 0.0009 ms),这对几何校正的解析解设计提出了极高要求。若无法解决,ATMs 在真实声学环境中的可靠性始终受限,阻碍其在语音助手、工业质检、远程会议等场景的规模化应用。
行业类比
类似视觉-语言模型在恶劣天气或低光照下的 TTA 难题,但音频的噪声偏移更隐蔽,且宽带类语义极易被误当作噪声子空间去除。
核心洞察
- PRISM 将测试时适应从梯度迭代重定义为静态投影矩阵 `W` 的估计:基于 **Affine Noise Hypothesis**,用闭式几何校正(**OPCA**、**CCVD**、残差平移)从无标签目标批次恢复低秩仿射偏移,最终推理仅需一次矩阵-向量乘法。与依赖梯度更新的 TTA(如 **ContextDA** 需要 oracle 噪声提示)相比,PRISM 无需任何特权标注、不强化噪声,且延迟从毫秒级降至 `0.0009 ms`,为边缘部署提供了新的工程范式。
- 作者识别出子空间收缩的 **Polyphonic Trap**:宽带类(如多音符混合)的语义方差与噪声方向重叠,直接去噪会误删有效信号。为此引入 **Confidence-Aware Regression** (CAR),用置信度加权回归替代均匀收缩,使最受影响的类恢复 8.16 个百分点。不同于只报告平均增益的同类工作,该机制揭示了基于流形假设的闭式方法在特定类分布上的失效条件,为设计鲁棒的几何 TTA 提供了可操作的 fault analysis。
方法
输入与核心假设
PRISM 输入为无标签目标音频批次与冻结文本原型(frozen text prototypes)。核心假设是 Affine Noise Hypothesis:严重声学噪声在音频-文本联合潜空间引起的失真具有低秩仿射结构,超过 90% 的能量集中在前 60 个主成分。
关键模块
- Orthogonal Procrustes Cross-modal Alignment (OPCA):用伪标签和置信度门控筛选可靠样本,计算置信度加权类质心;估计最优正交旋转与自适应缩放,将受扰音频特征对齐到文本原型。
- Class-Conditioned Variance Deflation (CCVD):基于置信子集计算类内/类间散度,识别噪声主导子空间,通过正交投影抑制噪声方差。
- Per-Class Residual Translation:逐类补偿残余平移偏差,校正类中心偏移。
- Affine Bias Regression (ABR):将上述旋转、缩放、投影、平移等几何校正通过仿射增广与闭式岭回归编译为单个静态投影矩阵
W。 - Iterative Calibration and Static Inferencing:校准阶段迭代估计校正项;推理时只需把输入特征与
W做一次矩阵-向量乘法,得到降噪后特征用于分类。
输出与推理开销
输出为适配后的分类预测;推理延迟约 0.0009 ms,远低于梯度类 TTA。与同类方法相比,PRISM 不依赖梯度更新(避免噪声强化),也不需要推理时的特权噪声标注或 oracle 提示,而是将几何校正一次性固化在 W 中。
实验
实验设计
在 UrbanSound8K 数据集上评估严重声学噪声场景。对比基线包括 zero-shot 和 oracle-assisted TTA(如 ContextDA)。PRISM 采用无训练、无源 TTA,使用冻结文本原型作为几何锚点,通过三个闭式几何校正编译成单一静态投影矩阵 W。
关键发现
- PRISM 在 zero-shot 基线上提升 12.94 个百分点,并超过 oracle-assisted TTA 9.41 个百分点,尽管从未访问其特权增强噪声提示。
- 推理时仅需一次矩阵向量乘法,延迟 0.0009 ms,远快于梯度 TTA。
- 识别并解决 Polyphonic Trap(子空间降维对宽带类别的失效模式),通过 Confidence-Aware Regression (CAR) 使最差类别恢复最多 8.16 个百分点。
与基线对比解读
PRISM 的关键优势在于 盲适应:不需要 oracle 噪声提示,也不需要梯度更新,避免了梯度 TTA 中“强化噪声”的问题。相比 ContextDA 等依赖特权信息的基线,PRISM 的静态投影矩阵可在边缘设备上以极低开销部署,满足实时推理需求。其几何校正基于 Affine Noise Hypothesis(噪声引起低秩仿射偏移,>90% 失真能量集中于前 60 个主成分),提供了理论保障。
行业影响
落地场景
PRISM 可直接用于音频事件检测、语音交互、内容安全审核等对噪声鲁棒性要求高的场景。例如,智能音箱在厨房或街道噪声下识别用户指令;工业设备监听系统在机械轰鸣中检测异常声响;媒体平台对用户上传音频进行内容分类(如音乐、人声、警报)。由于推理仅需一次矩阵乘法,适合部署在边缘设备(如智能家居 hub、车载芯片)。
商业价值
- 降本:无需梯度更新或额外训练数据,省去 GPU 成本与专家调参;单次推理 0.0009ms,可在毫秒级响应预算内完成 TTA。
- 增收/体验:在严重噪声下提升准确率超过 12 个百分点,显著减少误报漏报,降低人工复核量;语音助手在嘈杂环境的可用性提升直接改善用户留存与付费意愿。
- 差异化:相比需要特权噪声提示的 prompt tuning 方法,PRISM 完全盲适应,无需部署时知道目标噪声类型,降低数据采集与标注成本。
与现有工作流集成
PRISM 以 静态投影矩阵 W 的形式插入推理管线:将预训练的音频编码器输出 embedding 与 W 相乘即可。可封装为轻量推理前处理层,无需修改已部署模型权重,支持热更新。与 CLAP / AudioCLIP 等 ATM 模型配合,只需预先在无标注目标域批次上计算一次 W(离线),即可跨设备分发。也可通过模型服务网关动态加载不同噪声域的 W,实现多场景切换。
具体 use case:
- 智能语音助手:在车载或户外场景中,用户说“导航到最近的加油站”,背景有引擎声和风噪。PRISM 对音频 embedding 去噪后,指令识别准确率显著提升,避免重复唤醒。
- 内容平台音频审核:短视频平台自动检测违规声音(如辱骂、枪声),在街道录音中也能稳定触发,减少漏审导致的合规风险。
局限
- **语义方差与噪声混淆**。作者在 Limitations 中明确指出,当类别内部的语义方差与噪声分布相似时(例如复调声音的多声源叠加),子空间收缩会误删有用语义信息,导致特定类别性能下降。虽然 **Confidence-Aware Regression (CAR)** 通过置信度加权回归缓解了该问题,但 CAR 的效果依赖置信度估计的准确性;在极低信噪比或训练数据本身存在标签噪声的情况下,置信度可能不可靠,仍然存在残余风险。该局限本质上由方法假设(噪声与语义在低维子空间可分离)导致,难以在框架内完全消除。
- **仿射噪声假设的覆盖范围**。PRISM 的核心——**Affine Noise Hypothesis** 假定严重声学噪声在跨模态潜空间中表现为低秩仿射位移,且 90% 以上的失真能量集中在前 60 个主成分。但真实世界噪声类型多样:脉冲噪声、非高斯噪声、时变噪声或非线性失真可能不满足低秩仿射结构,此时几何校正的静态投影矩阵会失效。此外,方法需要从一批无标签目标数据中估计噪声子空间,因此批量大小和批内样本的多样性会直接影响估计稳定性;在流式或单样本推理场景下难以直接应用,限制了其部署灵活性。
- **实验验证范围较窄**。论文主要在 **UrbanSound8K** 上报告了详细的量化结果,虽然该数据集包含 10 类环境声,但类别数量和噪声类型仍有限;缺少在更大规模音频分类基准(如 AudioSet 子集、ESC-50 的多噪声变体)以及不同 **Audio-Text Foundation Model** 架构(如 CLAP 的不同变体、Wav2CLIP 等)上的跨模型验证。与 baselines 的对比中,虽然超过了 oracle-assisted TTA,但未充分纳入更多近期无源测试时适应方法(如 SAR、TENT 的变体)进行系统比较;GitHub 仓库目前 star 数较少,第三方复现和社区验证尚不充分。