训练留下痕迹:面向语言模型谱系验证的中心化残差签名
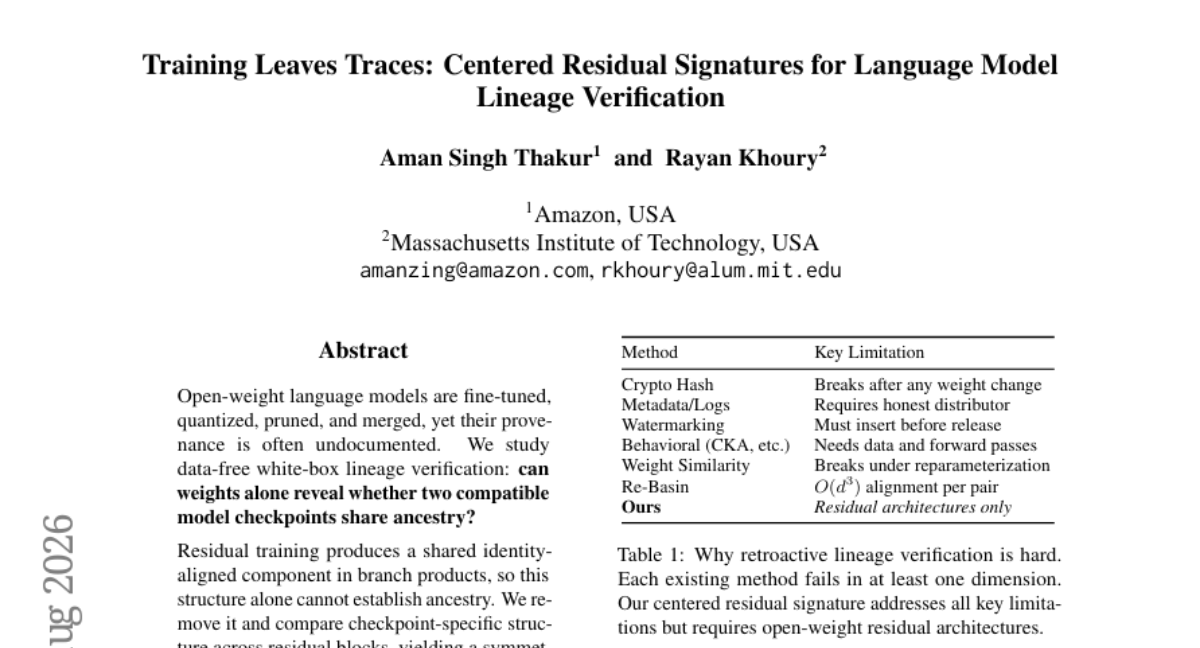
开放权重语言模型常被微调、量化、剪枝和合并,但其出处往往缺乏记录。本文研究无数据白盒谱系验证:仅凭权重能否判断两个兼容检查点是否同源? 作者发现,残差训练会在分支产物中留下共享的身份对齐成分,但这不足以确定祖先;于是将其移除,并比较跨残差块的检查点特定结构,得到针对独立检查点校准的对称谱系分数。 在 residual-MLP 和 GPT-2 基准上,该分数可将微调、LoRA 合并、剪枝、量化后的后代与独立及蒸馏模型区分开(AUROC=1.0),并能区分权重祖先与行为相似性。在保持功能的检查点清洗实验中,权重空间基线失去裕度或失败;本方法分数不变,且在 GPT-2 上比最接近的稳健基线快 76×。 投影配对信号 在六个语言模型家族上均出现,案例研究正确识别了 3 个相关与 7 个无关的 LLaMA-2 检查点,证明了被动、无数据的出处验证可行性。
论文精读
TL;DR 论文提出数据无关的白盒血统验证方法,通过中心化残差签名分析权重,精确区分微调、LoRA 合并、剪枝、量化后的衍生模型与独立模型,并能抵抗功能保持的洗白攻击,速度比最近的鲁棒基线快 76 倍。
问题
问题背景
开放权重语言模型的 checkpoint 常经过 fine-tune、LoRA merge、quantization、pruning 等处理,形成复杂供应链,但 provenance 往往缺失。业界需要从权重本身判断两个兼容 checkpoint 是否共享训练血统。
现有方法局限
已有 provenance 方法存在三方面不足:
- 行为相似性 无法区分 lineage 与 distillation:独立训练或蒸馏得到的模型可能行为高度相似,却无血统关系。
- 权重空间基线 如余弦相似度,在 function-preserving checkpoint laundering(权重置换、层重组等)下 margin 显著下降甚至失效。
- 共享 identity-aligned component 由残差训练在 branch products 中产生,是所有同架构模型共有结构,直接使用会误判同源。
为什么难/重要
数据自由白盒验证要求在无训练数据条件下提取稳定且可泛化的 provenance 信号。核心挑战是必须先消除架构原生共享结构,仅保留 checkpoint 特定结构;同时信号需对微调、LoRA 合并、剪枝、量化鲁棒,并能抵抗 checkpoint laundering。该问题对模型供应链审计、许可证合规与恶意篡改检测具有直接工业价值。
行业类比
类似软件供应链中对二进制制品做来源验证,模型权重需要一种无需原始数据、仅凭参数即可判定“这段训练血统”的签名机制。
核心洞察
- **中心化残差签名移除身份对齐分量** 是本工作的核心创新。论文观察到,残差训练会在不同分支产物的分支乘积中自然产生共享的 identity-aligned 组件,因此仅比较残差结构本身无法证明血统。该方法先移除该共享分量,再比较各残差块中 checkpoint 特有的结构,从而避免将共同初始化或相同训练轨迹误判为血统关系。与直接使用权重距离或残差统计的 baseline 相比,这一去偏步骤让信号聚焦于真正的派生关系,在 function-preserving 白盒洗白实验中保持稳定,解决了此前方法在权重空间易受噪声干扰或失效的问题。
- **血统信号与行为相似性解耦** 是该方法的另一独特贡献。论文在 residual-MLP 和 GPT-2 基准上实现 AUROC=1.0,能区分 fine-tuned、LoRA-merged、pruned、quantized 后代与独立或蒸馏模型,并且其 lineage score 对 checkpoint 洗白(如功能保持变换)不变,而权重空间 baseline 会失去 margin 或失败。该 score 计算效率高,在 GPT-2 上比最接近的鲁棒 baseline 快 76 倍,无需任何数据或前向传播,适合对开放权重供应链中的大量 checkpoint 进行快速被动溯源,为实际模型发布合规与审计提供可落地的白盒验证手段。
方法
输入与前提
给定两个架构兼容的白盒 checkpoint,无数据。目标:判断两者是否共享祖先。残差结构提供分支乘积(branch products)信号,但训练本身使该信号中混有共享的、与恒等映射对齐的成分(identity-aligned component),不能直接作为 lineage 证据。
关键模块
- 分支乘积提取:对每个残差块,计算其分支乘积,代表该层的线性变换组合。观察发现,不同训练轨迹的 branch products 中均含一个共享的 identity-aligned component。
- 中心化(centering):利用独立 checkpoint 集合估计并减去该共享成分,得到中心化残差签名(Centered Residual Signatures)。减法去除训练动态的公共部分,保留 checkpoint 特异性结构。
- 投影配对打分:对两个 checkpoint 的签名进行逐块投影配对(projection-pairing),度量子空间对齐程度,聚合生成对称分数。该分数不受层内重排或部分重参数化影响。
- 校准与判定:用独立模型分布校准分数(如 z-score),设定阈值输出 lineage 验证结果。
输出
输出对称 similarity score 与校准后的二值判定。在 residual-MLP、GPT-2 系列基准上 AUROC=1.0,对 LoRA 合并、剪枝、量化后裔保持判别力,并在 function-preserving laundering 下分数不变。
跟同类方法差异:相比基于权重空间余弦或 L2 距离的基线,本方法先移除身份对齐成分再进行投影配对,因此不受函数保持变换影响,且运行速度比最近鲁棒基线快 76 倍。
实验
实验设计
在 Residual-MLP 与 GPT-2 基准上构造 lineage verification 任务,涵盖 fine-tuned、LoRA-merged、pruned、quantized 后代与独立 / 蒸馏模型。引入 Centered Residual Signatures 计算对称 lineage score,并针对 function-preserving checkpoint laundering 评估鲁棒性。在六个语言模型家族验证投影配对信号,另对公开 LLaMA-2 检查点做案例研究。
关键发现
- AUROC = 1.0:完美区分血缘后代与独立 / 蒸馏模型,表明权重空间信号与行为相似性解耦。
- 在 checkpoint laundering 下,本方法分数保持不变,而 weight-space baselines 边界丧失或失效。
- 速度提升 76× vs 最近稳健基线(GPT-2)。
- LLaMA-2 案例正确识别 3 个相关与 7 个无关检查点(10/10)。
与基线对比
传统 weight-space 方法依赖原始参数距离,在 function-preserving 变换下易被规避;本方法通过去除 identity-aligned component,仅保留 checkpoint-specific 结构,具备更强的抗 laundering 能力。同时计算开销显著降低,适合大规模开放权重模型供应链验证。
行业影响
落地场景
- 开源模型市场 / 模型仓库:平台能在新 checkpoint 上传时自动运行 lineage verification,标注其是否为现有模型的微调、LoRA 合并、剪枝或量化后裔,同时识别独立训练或蒸馏模型冒充原创的情况。
- 企业 ML 治理与模型风险管理:金融、医疗等高合规行业的团队在引入第三方开源模型前,可仅凭权重判断其真实血缘,避免供应链投毒或许可证违规。
- 具体案例:某模型市场对 LLaMA-2 衍生 checkpoint 做血缘校验,仅用权重即可正确区分 3 个相关与 7 个无关模型;某银行用该工具验证供应商交付的微调模型确实来自其已审核的基座。
商业价值
- 降低人工审计与法律合规成本,缩短模型采购、上架和安全评估周期。
- 提升模型交易与开源发布的信任度,为模型授权和知识产权保护提供可验证证据。
- 方法被动、数据无关(data-free)且比最接近的稳健基线快 76 倍,可规模化扫描大型模型库,带来直接的算力与时间节省。
与现有工作流集成
- 以 无数据白盒验证器 形式嵌入 CI/CD、模型注册表(如 MLflow、Hugging Face Hub)或安全扫描流水线。
- 输入两个兼容 checkpoint 的权重,输出对称 lineage score 和校准判定,可封装为 API 或命令行工具。
- 与现有许可证检查、模型指纹和漏洞扫描并行运行,不改变训练流程,也不要求访问训练数据。
局限
- - **架构兼容性限制**:方法要求两个检查点具备可对齐的残差块结构(相同维度、激活函数、残差配置),因此仅适用于“compatible”模型。现实中的衍生模型常涉及宽度剪枝、层数调整或注意力头数变化,此时逐块比较的投影配对信号可能无法计算或显著退化。论文虽在层移植和线性合并实验中部分覆盖结构修改,但未系统评估跨规模架构变化场景,这限制了方法在复杂供应链上的普遍适用性。
- - **校准对负样本集的依赖**:血统分数的判定阈值需要从一批独立检查点中统计校准得到,这些负样本若来自相似的预训练分布或初始化策略,可能低估真实世界中的结构多样性,导致误判。论文未量化校准集大小和多样性对 AUROC 的影响,也未探讨在目标领域(如特定垂直行业微调模型)缺乏足够同架构独立检查点时,分数是否会产生假阳性或假阴性,这在实际部署中是一个关键风险。
- - **白盒假设与对抗鲁棒性边界**:方法要求完整访问权重,无法处理仅通过 API 暴露的模型。此外,尽管包含梯度抑制攻击实验,但并未证明对任何白盒对手都鲁棒:攻击者可针对 Centered Residual Signature 显式添加正则项进行洗白,或利用重参数化、权重混洗等变换抹除签名,论文仅验证了有限几类功能保持操作。对大规模模型,计算投影配对信号和校准所需的时间与存储开销也未充分报告。