DumpsterCluster: 从拾荒到在60美元GPU上服务LLaMA-70B
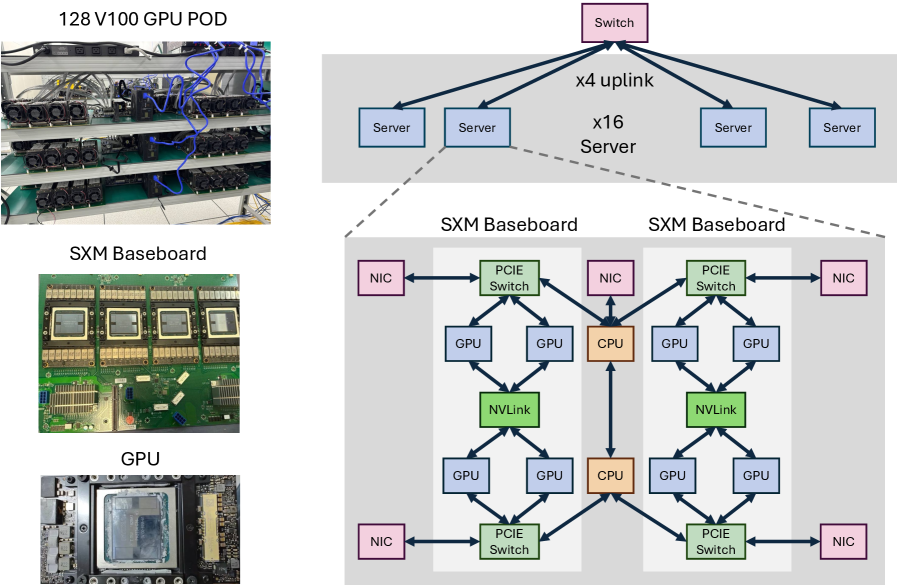
随着AI数据中心淘汰功能正常的GPU,大量仍具计算能力的加速器进入二手市场。本文研究这些退役GPU能否重获新生,构成一个DumpsterCluster来服务现代LLM推理,并探讨在何种条件下这种再利用在经济上可行、环境上可持续。我们仅使用二手组件从零搭建了一个128-GPU DumpsterCluster,并运行了一年。以当前市场价格(DumpsterCluster约2.2万美元,而8-GPU B200系统约60万美元),经济优势显著。通过流水线并行优化,我们基于V100的DumpsterCluster实现了与LLaMA-70B相媲美的吞吐量,验证了生产可行性。 然而,部署揭示了关键的环境依赖。旧GPU每token能耗显著更高,使得总拥有成本仅在电价低廉地区具备优势。在电网平均碳强度下,二手系统相比当前一代硬件,8B模型每token总碳排放量约为4倍,70B模型则超过40倍。这些发现表明,GPU“来世”并非普遍可持续——硬件再利用必须与低碳能源战略结合。当部署在能源经济性有利且电力清洁的地区,二手GPU为扩展AI算力提供了一条可行路径,同时提升 affordability、能源安全与环境责任。
论文精读
TL;DR 用 128 块二手 V100 GPU 搭建 $22K 集群,经流水线并行优化后,以有竞争力吞吐量服务 LLaMA-70B,验证旧硬件在低成本清洁电力条件下可经济环保复用。
问题
问题背景
随着 AI 数据中心大规模退役功能完好的 GPU,二手加速器市场迅速扩大,领域开始关注如何以极低成本扩展 LLM 推理容量。
现有方法局限
主流方案依赖新一代旗舰 GPU(如 B200/H100),但初次采购成本急剧上升,且供应链受限。旧 GPU(如 V100)虽价格低廉,但普遍被贴上“性能过时、能效低下”的标签,缺乏面向低带宽、低算力集群的系统级优化,导致吞吐量与每瓦性能远低于理论峰值。此外,从零构建异构二手集群面临硬件可靠性、驱动适配与运维开销等工程挑战,少有实际部署案例。
为什么这个问题难 / 重要
- 经济性: 二手集群硬件成本可低至新系统的 1/27,但总拥有成本(TCO)高度依赖电价;高电价地区难以平衡能效劣势。
- 环境可持续性: 旧 GPU 每 token 的碳足迹可能比新硬件高 4 到 40 倍(取决于模型规模与电网碳强度),需要与低碳能源耦合才能实现真正减排。
- 工程复杂度: 需要对 pipeline parallelism、通信调度与负载均衡进行重新设计,以突破 PCIe 带宽和内存容量瓶颈。
- 行业关注度: 云厂商与超大规模数据中心均在探索硬件延寿与算力分级,二手 GPU 能否形成可运营的推理层成为关键未知数。
行业类比
这类似于在端侧用 INT8 量化 让模型跑在低精度硬件上——以精度换能效,而二手 GPU 集群是“硬件级量化”,需要同样严格的性能 / 成本 / 碳效权衡。
核心洞察
- - 二手硬件的经济可行性与环境可持续性需要解耦评估。与通常认为 repurposing 即绿色的直觉相反,本研究通过真实集群和全生命周期碳核算显示,V100 在电网平均碳强度下每 token 碳排放可达新硬件 4 倍(8B)至 40 倍(70B),因为老旧 GPU 能效低。独特之处在于把区域电力碳强度作为首要变量纳入 TCO 和碳账本,而非只看硬件采购成本。工程启示:部署二手推理集群前必须先用当地电网数据做边际碳排预测,并优先选址低碳能源区域。
- - 通过 pipeline-parallel 优化,60 美元级 V100 集群可承载 LLaMA-70B 推理,挑战了“大模型服务必须新旗舰卡”的假设。与以往用二手卡仅做小模型或非生产负载不同,本研究在 128 卡 V100 上实现了 competitive throughput,关键在针对 decode 阶段做流水线切分和通信调度。这为预算敏感团队提供 scaling-out 替代 scaling-up 的可行性证据,但需注意吞吐达标并不意味着绝对成本最低,因为还需算电力开销。工程启示:老旧卡集群适合吞吐优先、对延迟不敏感的场景,并需定制推理引擎而非直接套用新卡方案。
方法
输入
- 二手硬件池:128 块 NVIDIA V100 GPU、配套 CPU/主板/电源/网络设备,总成本约
$22K;部件为二手市场退役产品,存在故障率与性能退化。 - 目标负载:
LLaMA-70B等大模型推理,属于显存密集、通信密集场景。
关键模块
- 集群搭建:从零组装硬件,完成供电、散热、节点间互联与故障备件管理;部署基础软件栈,支持分布式推理。
- 流水线并行优化:针对 V100 显存和卡间带宽限制,沿层分片
LLaMA-70B;通过 micro-batch 调度、通信/计算重叠、激活复用等策略降低 pipeline bubble,提升有效吞吐。 - 成本与碳足迹评估:记录真实功耗与 uptime,结合本地电价和电网碳强度,计算每 token 的 TCO 与碳排放。
输出
- 验证二手 V100 集群能够稳定服务
LLaMA-70B,吞吐接近现代单体 GPU 系统的可用水平。 - 得到经济性与碳强度分区域对比:二手集群在低电价/低碳电力下可行,在高碳电网上 per-token 碳排放显著上升。
差异点
与仅做模拟或只关注单卡成本的工作不同,本文以运行一年的真实集群数据,同时把能源碳强度纳入可行性边界。
实验
实验设计
论文构建了由128 块二手 V100 组成的集群(成本约 $22K),通过流水线并行优化服务 LLaMA-70B 推理,并与当前一代 B200 系统(8 GPU 成本约 $600K)对比。评估维度包括吞吐量、总拥有成本(TCO)以及碳排放强度。
关键发现
- 经济性:二手集群硬件成本显著低于 B200 系统,且通过流水线并行可获得有竞争力的 LLaMA-70B 吞吐量,证明生产可行性。
- 碳足迹:在电网平均碳强度下,二手系统每 token 碳排放约为当前硬件的 4 倍(8B 模型) 至 40 倍以上(70B 模型),显示出高能耗导致的环境劣势。
- 条件约束:二手 GPU 的 TCO 优势仅在低电价地区成立;可持续发展必须与低碳能源耦合。
与基线对比解读
与 B200 为代表的现代加速器相比,二手 V100 的能效比明显落后,导致单位 token 能耗与碳排放高。然而在资本支出(CapEx)受限、电力成本低且电网清洁的场景中,二手集群能提供可接受的服务质量与大幅降低的硬件投入。该工作量化了“GPU afterlife”的边界条件,为 AI 基础设施规划提供了数据支撑:不能单纯追求成本,需综合评估电力价格与碳强度。
行业影响
落地场景
二手 GPU 集群(DumpsterCluster)主要适用于对推理延迟不敏感、对总拥有成本敏感的批量或准实时场景。例如:
- 电商平台的商品描述生成、评论摘要、客服自动回复离线批量处理;
- 内容平台的视频字幕生成、长文摘要、知识库问答的批量预处理;
- 企业内部的文档分析、RAG 索引构建、非关键路径的模型评估。
由于 V100 等旧卡在 token/能耗 上明显劣于新硬件,适合承载高吞吐、低 SLA 要求的任务。
商业价值
核心优势是硬件成本极低:128 GPU V100 集群成本仅 $22K,而 8 GPU B200 系统约 $600K。但运营成本受电价与碳强度强烈影响。在低廉且清洁的电力区域,TCO 可显著降低;否则可能因碳排放过高而失去环境优势,甚至受政策制约。因此商业价值呈现条件型降本,而非普适性节省。
与现有产品/工作流集成
- 推理框架层:需对 pipeline parallel 进行定制优化,可参考论文的
pipeline-parallel optimizations,在 vLLM / TensorRT-LLM 等框架上针对旧 GPU 做适配。 - 调度层面:将二手集群作为弹性容量池,通过 Kubernetes 或自定义调度器分配离线批处理作业,与在线 A100/H100 集群形成冷热分层。
- 能源感知部署:结合实时碳强度数据(如 Electricity Maps API)动态调度工作负载至低碳时段,体现环境责任。
原论文指出:二手硬件并非普遍可持续,必须与低碳能源战略绑定。该结论对行业采用二手 GPU 提供了明确边界条件。
局限
- 论文在 **Discussion and Limitations** 中明确承认,二手 GPU 集群的经济与环境可行性高度依赖所在地区的**电价和电网碳强度**。在平均碳强度下,二手系统的每 token 碳排放可比新硬件高 4 至 40 倍以上,导致其普适性受限。然而论文未对不同电价、碳强度场景下的总拥有成本(TCO)与碳回报期进行敏感性分析或定量建模,仅停留在定性讨论;也未考虑碳税、绿电溢价等政策变量的影响,使结论在区域推广时存在较大不确定性。
- 实验设计存在一定局限性:硬件仅采用 **NVIDIA V100** 单一型号,集群规模固定为 128 卡,未探索不同代际(如 P100、T4 等)或混合型号对性能、能耗的影响。工作负载主要针对 **LLaMA-70B 和 8B** 的 decode-heavy 与 ShareGPT 推理场景,未涉及训练、微调、低延迟在线服务等常见 AI 负载;且 pipeline-parallel 优化高度依赖模型结构和 batch size,缺乏在其他并行策略(如张量并行、专家并行)或更大集群规模下的对比验证,限制了结论向更广泛生产环境的迁移。
- 与可持续计算领域的系统建模研究相比,本文更侧重实际部署与测量,但缺少完整的**生命周期评估(LCA)**——只估算了运行碳和部分隐含碳(逻辑芯片、VRAM、外设),未纳入二手设备翻新、运输、报废回收等环节的碳成本。同时,论文未与替代方案(如在新型硬件上运行压缩后的小模型、使用云端弹性推理、或采用其他旧硬件利用框架)进行公平的成本-碳效对比,因此难以判断 **DumpsterCluster** 相比“直接购买少量新卡”或“租用云 GPU”在综合效益上是否真正占优。