Plausible but Not Valid: LLMs 作为合成调查受访者的心理测量学审计
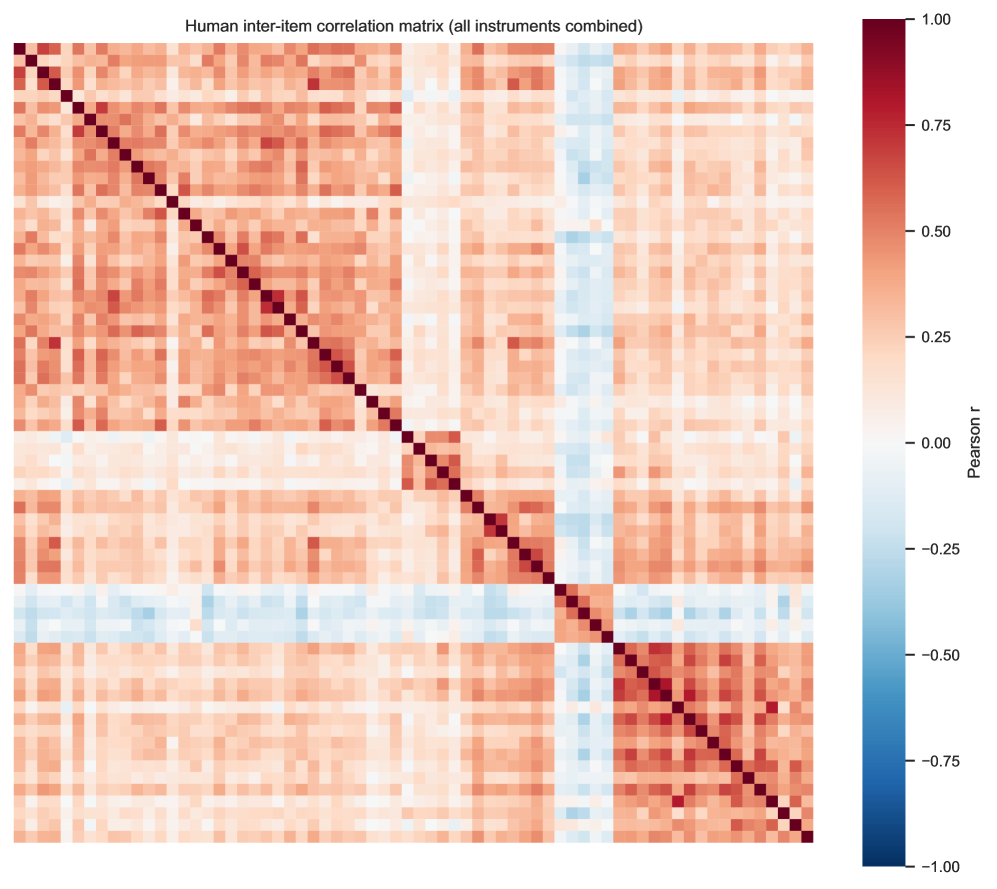
大语言模型(LLMs)正越来越多地被用作合成调查受访者,但现有评估仅关注答案在个体层面是否看似合理。我们主张正确的问题应是心理测量学层面的:LLMs 是否保留了真实人类调查数据的联合分布、潜在结构、信度、中介路径和人口学效应? 我们引入了一个立陶宛组织心理学数据集(n=263 名员工;包含 Dunham 变革态度量表、UWES-17、Koopmans IWPQ;68 个条目、12 个子量表),并对 37 个模型构成的阵容进行条件化,涵盖 OpenAI、Anthropic、Google 及十二个开放权重系列,采用五级人格披露阶梯、呈现与推理努力消融、反事实人口学交换(性别、角色、教育)、跨语言检查以及逐字回忆记忆探针。由此产生的 心理测量相似度得分(PSS) 以五个非 LLM 统计基线和一个留出的人类-人类上限为锚点,并配有受访者自助置信区间和用于 Tucker's phi 的条目排列零分布。 实验发现:LLMs 能复现人类心理测量关系的定性方向,但 高斯 copula 基线 在样本驱动的 PSS 分量上击败了所有 LLM;LLM“群体”彼此之间的相似度(平均 inter-LLM PSS 0.73)高于与人类的相似度;记忆化并非排行榜的主要驱动力(recall-PSS 秩相关 0.00)。反事实交换显示教育驱动效应(平均 |d|=0.56)远超性别(0.12)和角色(0.18);UWES 上的 Tucker's phi 在 37 个模型中有 8 个落入排列零分布内。下游方面,每个 LLM 都表现出强烈的默许偏差(+0.84 SD),合成训练的回归模型对留出人类数据的预测效度下降(平均 R^2 -0.18 vs 0.28),并且模型在 10 条安慰剂中介路径中的 3 条上虚构了间接效应。 结论:LLM 样本不能作为人类调查数据的直接替代品。
论文精读
TL;DR 对 37 个 LLM 进行心理测量学审计:LLM 虽能复现趋势方向,但联合分布、信度、中介路径均与人类数据不符,甚至被 Gaussian copula 基线超越,不能直接替代真实受访者。
问题
当前,使用 LLM 作为合成问卷受访者(synthetic survey respondents)已成为 AI 与社会计算交叉领域的热点。研究者希望通过 LLM 快速生成大规模、低成本的人类反馈数据,用于组织心理学、用户研究和政策模拟。
现有方法的局限 现有评估大多只检查单个回答是否“看起来合理”,忽略了心理测量学的核心要求:
- 没有考察 LLM 样本是否保持真实人类数据的联合分布 和 潜变量结构;
- 缺乏对信度、聚合效度、区分效度 和 中介路径的系统检验;
- 没有控制人口统计效应(如性别、角色、教育水平)对回答的影响;
- 先前的对比研究通常规模小、设定零散,未与统计基线或真人天花板进行一致锚定。 因此,即使每个回答在个体水平上 plausible,合成样本也可能在群体统计上严重失真。
为什么这个问题难且重要 真实问卷数据具有高维协方差、潜变量、测量不变性和中介效应等复杂结构,LLM 很难同时复现这些属性。如果合成受访者数据被用于下游分析(如回归预测、因果推断),其偏差会被放大,产生误导性结论。业界对低成本调研和合成数据管道关注度很高,但缺乏统一的量化基准来判断 LLM 样本是否“统计可替代”真人样本。
行业类比 就像用 LLM 合成训练数据微调模型,若合成数据只注重单条样本的语义合理性而忽略分布层面的统计特征,微调后的模型在真实数据上性能会大幅退化甚至学会虚假相关。
核心洞察
- 重新定义“像人”的标准:论文将合成调查评估从个体答案 plausible 提升到心理测量层面(联合分布、Tucker's phi、信度、中介路径),并锚定五个统计基线和人类天花板。最反直觉的是 Gaussian copula 这个简单参数化模型在样本驱动的 PSS 组件上击败所有 LLM,说明 LLM 虽然能复现方向性趋势,但在保留真实数据结构上还不如经典统计生成器。
- 记忆不是主导因素:通过逐字回忆探针与 PSS 排名相关仅 0.00,论文排除了“LLM 只是背诵训练数据”的简单解释。这表明 LLM 的偏差来自训练数据中人群表征的泛化和刻板印象放大,而非特定样本记忆。这种因果区分比同类工作更清晰,因为多数研究只测重复率,未将记忆强度与下游心理测量忠实度做相关性检验。
- 合成样本的级联污染:下游分析显示 LLM 回答存在 +0.84 SD 默许偏倚,用合成数据训练的回归器在真人样本上 R^2 均值 -0.18(真人训练为 0.28),且 10 条 placebo 中介路径中3条被伪造。这说明即使个体答案看似合理,只要联合分布和响应风格偏了,合成数据就会反噬下游模型。与只关注直接问答质量的评估不同,本文量化了“看似合理但不有效”的代价。
方法
输入:使用立陶宛组织心理学调查数据(n=263),包含真实员工人口学档案和 68 题、12 个分量表(Dunham 态度改变、UWES-17、Koopmans IWPQ)。将题目与受访者画像以五级 persona 披露阶梯(C0 无画像 到 C4 完整画像)注入 37 个 LLM(OpenAI、Anthropic、Google 及 12 个开源家族)。
关键模块:
- 生成与消融:设定采样温度、推理 effort 最小化,重复生成;支持不同展示模式(量表题 vs 文本)与跨语言检查;进行反事实人口学交换(性别、角色、教育)和逐字回忆记忆探测。
- 评估框架:计算 Psychometric Similarity Score (PSS),覆盖六个维度:联合分布、潜结构、信度、中介路径、人口学效应等。与五个非 LLM 统计基线(如高斯 copula)和留出的人类对比天花板锚定;用 bootstrap 构建置信区间,对 Tucker's phi 做条目置换零假设检验。
- 下游验证:检验反应风格(默许偏移)、预测效度(合成数据训练回归器在真实人类上 R²)和安慰剂中介路径。
输出:每个模型的 PSS 排行榜、构念级 Tucker's phi 显著性与否、反事实效应量、记忆召回与 PSS 排名相关性、以及下游后果指标,结论为 LLM 样本不可直接替代人类调查数据。
差异点:与仅检查单个回答是否“看似合理”不同,本方法从心理测量学的联合分布与结构效度层面系统审计 LLM 合成受访者,并用严格统计基线和人类天花板做相对校准。
实验
实验设计
在 Lithuanian 组织心理学数据集(n=263,68 题,12 个分量表)上,作者对 37 个 LLM 进行五级 persona 披露阶梯调节,并加入 presentation / reasoning-effort 消融、反事实人口学替换(性别、角色、教育)、跨语言检查与逐字回忆记忆探测。评估指标为样本驱动 PSS 与 construct-level Tucker's phi,并与五种非 LLM 统计基线(含 Gaussian copula)及 held-out human ceiling 对比,使用 bootstrap 置信区间和 item-permutation null。
关键发现
LLM 能复现心理测量关系的定性方向,但 Gaussian copula 基线在样本驱动 PSS 分量上击败所有 LLM;LLM 内部平均 PSS 0.73,比与人类更相似;记忆不驱动榜单(rank corr 0.00)。反事实替换显示教育效应(|d|=0.56)远超性别(0.12)和角色(0.18);UWES 的 Tucker's phi 有 8/37 模型落入置换零假设。下游所有 LLM 出现强烈 acquiescence shift(+0.84 SD),合成数据训练回归器在 held-out 人类上 R²=-0.18 对比人类 0.28,10 条 placebo 中介路径中 3 条被虚构间接效应。
基线对比解读
Gaussian copula 仅依赖边缘分布与协方差结构,就超过 complex persona 提示的 LLM,说明 LLM 在联合分布、潜变量结构上仍有明显缺陷。LLM 群体同质化(0.73)揭示其倾向于输出社会期望答案而非真实异质性。Acquiescence shift 与虚构中介进一步表明 LLM 回答的模式性,当前不适合直接替代人类问卷。
行业影响
落地场景
LLM 作为合成受访者的现有应用集中在市场调研、用户体验研究、组织心理学和政策模拟等领域。本论文的审计结果表明,这些场景不可直接以 LLM 样本替代真实人群,但可作为探索性假设生成器:在正式问卷投放前,用 LLM 快速捕捉响应的大致方向、探测量表歧义或生成候选题项。例如,电商平台可在新品概念测试中用 LLM 合成用户对功能偏好的粗粒度排序,但必须辅以真实小样本验证。内容平台可模拟创作者对平台政策变化的情绪反应,用于预警潜在争议点,但不可作为决策依据。
商业价值
直接采纳 LLM 合成调研数据看似能节省数万至数十万美元的问卷执行成本,但本研究发现 LLM 样本在联合分布、信度和中介路径上均偏离人类基准,且高斯 copula 基线在样本驱动指标上优于所有 LLM。这意味着盲目降本可能导致错误的产品决策与品牌风险。更务实的价值定位是:将 LLM 用于调研流程前端(如题项生成、配额设计、异常值预筛)和后端校准(用真实数据训练回归器修正 LLM 的顺从性偏移)。这样既缩短调研周期,又保持最终因果推断的可靠性。
与现有产品/工作流的接口
LLM 合成受访者功能应作为调查平台(如 Qualtrics、SurveyMonkey)或企业级 AI 助手的插件模块,而非独立替代方案。集成路径建议:
- 预调研阶段:用 LLM 生成多样化人格卡片,快速测试问卷的可读性与潜在回答分布。
- 主调研阶段:仍以真实受访者为核心,LLM 仅用于实时监测响应质量或填补少量拒答项。
- 后处理阶段:用论文提出的 Psychometric Similarity Score (PSS) 和 Tucker's phi 作为质量监控指标,对 LLM 生成的任何辅助数据进行否决式校验。
具体用例:全球电商平台在节日大促前的用户满意度预测中,先用 LLM 模拟 1000 个虚拟用户对物流时效的反馈,快速识别高风险触点,再定向投放 200 份真实问卷进行验证。企业服务公司在员工敬业度调查前,用 LLM 模拟不同部门对变革管理的反应,以优化问卷维度,但最终报告严格基于真实员工数据。
局限
- **单一数据集与语言限制**:研究仅基于 Lithuanian 组织心理学数据集(n=263),量表为特定工具(Dunham, UWES-17, Koopmans IWPQ)。单一语言和文化背景限制了跨语言、跨文化泛化性,无法验证 LLM 在其他语言或文化下的心理测量等价性。小样本(263 人)导致人类基准统计功效有限,PSS 估计可能不稳定。此外,数据可能被部分 LLM 训练集包含(instrument leakage),影响真实性评估。
- **自我报告与模型设置限制**:所有测量基于自我报告问卷,缺乏客观行为指标,易受反应风格(如 acquiescence)干扰。LLM 生成仅设置 minimal reasoning effort,未探索更高推理强度或不同温度、采样策略的影响。LLM 样本量受限(每个 profile 重复次数有限),可能低估模型变异性。模型版本可能随时间漂移,复现性存在挑战。
- **评估框架的潜在弱点**:PSS 聚合六个维度可能掩盖特定模型在某个维度的严重缺陷;Tucker's phi 的 permutation null 检验可能对多重比较未充分校正,导致假阴性。与同类工作相比,该研究未提供可直接用于实际调研的校准方法,仅做出诊断,未提出缓解策略。统计基线 Gaussian copula 仅作为样本驱动组件基准,未完全覆盖个体级分布。