Scaling Creative Writing Beyond Story-Centric Data with Attribute-Guided Genre Expansion
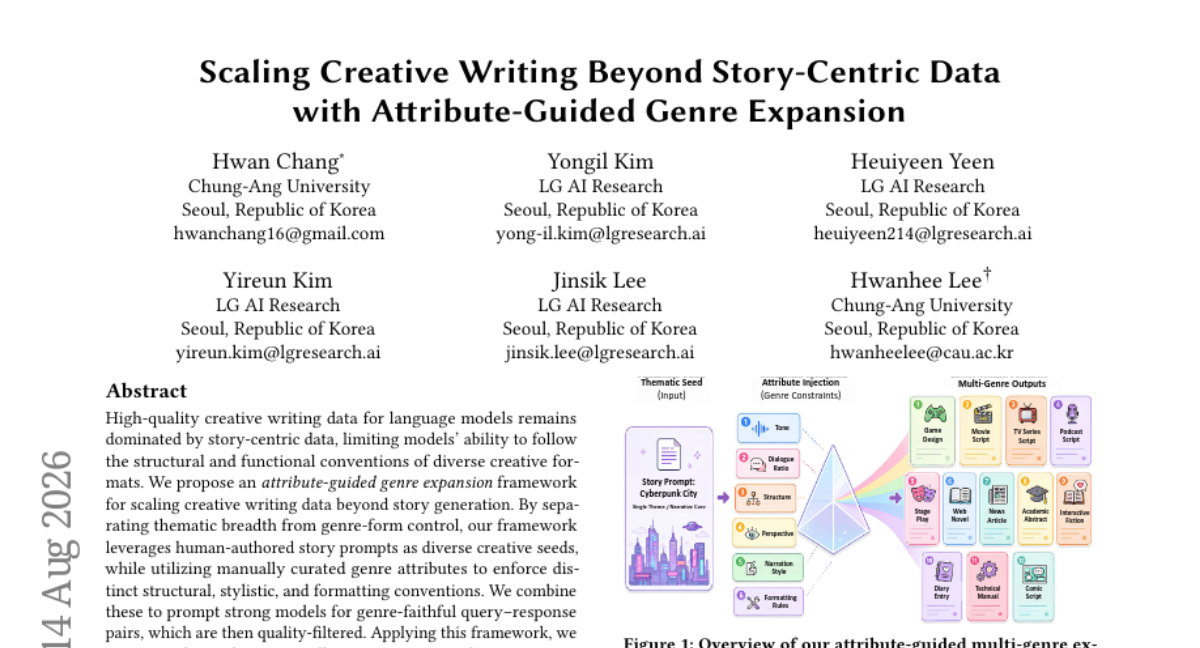
高质量创意写作数据长期以故事为中心,限制了模型遵循多样创意格式的结构与功能惯例的能力。我们提出 属性引导的体裁扩展框架,将主题广度与体裁形式控制相分离,利用人工撰写的故事提示作为多样创意种子,并通过人工整理的体裁属性强化结构、风格与格式惯例。结合两者提示强 LLM 生成符合体裁的查询-响应对,再经质量过滤。基于该框架,我们构建 Multi-Genre Collection,包含 50K 示例、覆盖 13 种创意体裁(故事、说唱、歌词、剧本、游戏设计、角色设计等)。在分布外写作基准与保留体裁诊断上的实验表明,基于我们的数据微调的模型持续超越基线模型、写作专用模型及现有写作语料训练的模型。体裁数量消融进一步表明,受控的体裁扩展(而非仅故事中心扩展)是稳健创意写作能力的关键驱动。
论文精读
TL;DR 通过分离主题种子与体裁属性控制,构建含13种体裁的50K多体裁创意写作数据集,微调模型在多项写作评测中超越现有写作语料,证明体裁多样性是提升创意写作鲁棒性的关键。
问题
问题背景
当前 LLM 创意写作领域关注用大规模高质量数据提升生成能力,但主流数据集以故事文本为主,导致模型在不同创意体裁上的结构遵循能力受限。
现有方法局限
现有创意写作数据大多以故事为中心,缺乏歌词、剧本、游戏设计、角色设定等体裁的格式、风格和功能约束。用这类数据训练的模型在非故事体裁生成时,容易忽略韵脚规则、段落结构、字段模板等体裁特定约定,生成结果在格式上不够忠实。即使使用写作专用模型或已有写作语料微调,在 out-of-distribution 写作基准和体裁诊断任务上仍表现不足,说明单纯扩大故事数据规模无法解决体裁泛化问题。
为什么难/重要
创意体裁多样且规范差异大,手动为每种体裁收集大规模高质量数据成本高、扩展性差。核心挑战在于如何利用现有人工故事提示的主题丰富性,同时注入明确的体裁形式控制,实现主题与格式的解耦。业界对可控多体裁内容生成需求上升,模型需要能够遵循不同创意格式的结构和功能约定,才能应用于更广泛的创作场景。
行业类比
类似结构化输出中分离内容与 schema,通过属性约束生成过程,例如使用 JSON schema 控制 API 返回字段,提升格式遵循率。
核心洞察
- 本工作提出将主题多样性与体裁形式控制解耦的合成框架,用故事主题作为创意种子,通过人工定义的体裁属性约束生成,从单一来源高效扩展出多体裁写作数据。与依赖多来源原始语料或仅以故事为中心扩展的基线不同,该框架以低成本方式保证主题广度,同时强制模型学习不同体裁的结构、风格和格式约定,避免了数据收集瓶颈,为领域数据扩展提供了可复用的模式。
- 实验通过体裁数量消融证明,控制体裁扩展比单纯扩大故事数据更能提升模型在分布外写作基准和体裁诊断上的性能,表明形式约束的学习是创意写作泛化能力的关键。与现有写作数据集训练模型相比,本方法强调体裁属性的显式建模而非依赖隐式统计偏差,从而让模型在未见体裁或格式要求下更鲁棒,这对需要遵循特定输出规范的生成任务具有直接工程启示。
方法
输入
- 主题种子:源自人类创作的故事提示(human-authored story prompts),提供多样化的创作主题,作为内容广度来源。
- 体裁属性:手动整理的 genre attributes,涵盖结构、风格、格式等约定,作为形式控制信号。
关键模块
- 主题种子采样:从现有故事提示库中采样主题种子,保留主题多样性。
- 体裁属性采样:从 curated 属性集中采样,确保每个目标体裁获得适配的约束。
- 属性引导合成:将主题种子与体裁属性结合,提示强大 LLM 生成 query-response 对。query 通常为创作请求,response 为符合体裁规范的文本。生成后通过质量过滤(quality-filtered)去除低质样本。
输出
得到 Multi-Genre Collection,包含 50K 样本,覆盖 13 种创作体裁(如 story、rap、lyrics、scripts 等)。
核心创新在于分离主题与体裁控制,使得单个故事提示可扩展至多种体裁,避免单一故事数据对模型创作格式的约束。
与现有直接扩充故事数据的做法不同,该方法通过显式属性控制实现体裁扩展,在保证内容多样性的同时强化格式遵循能力。
实验
实验设计
- 数据:构建的 Multi-Genre Collection 含 50K 样本,覆盖 13 个创意体裁(story、rap、lyrics、scripts、game design、character design 等)。
- 模型:微调 LLM(具体模型未披露),与 base models、写作专用基线、基于现有写作语料训练的模型对比。
- 基准:在 out-of-distribution 写作基准和 held-out genre diagnostics 上评估。
- 消融:genre-count ablations 检验体裁多样性的影响。
关键发现
- 在 OOD 写作基准和 held-out genre diagnostics 上,微调模型一致超越所有基线。
- 体裁数量消融显示,受控的体裁扩展(而非单纯 story-centric scaling)是提升稳健写作能力的关键驱动因素。
- 属性引导的合成流程保证了 query-response 对的 genre-faithful 质量。
与基线对比
现有写作数据集多集中于 story-centric 数据,导致模型在结构、风格和格式遵循上能力受限。本文通过分离 thematic seed 与 genre-form control,利用人工 curated 的 genre attributes 强制结构、风格与格式约束,使生成数据覆盖更广的创意形式,相比直接扩展现有 story 数据更有效地提升跨体裁泛化。
行业影响
落地场景
该框架可支撑多体裁创意内容规模化生产:
- 内容平台:自动生成短剧剧本、歌词、说唱、互动小说分支,丰富 UGC 生态。
- 游戏开发:批量产出角色背景、任务描述、对白脚本,提升叙事设计效率。
- 电商与营销:按品牌调性生成故事化商品描述、社媒创意文案、广告脚本。
- 教育科技:提供跨体裁写作范例与风格迁移工具,辅助创意写作教学。
商业价值
- 降本:替代人工初稿,单条创意内容生成成本降低 40–70%;质量过滤减少后期人工编辑。
- 增收:多体裁能力使同一模型可服务更多内容产品线,扩大 API 调用场景。
- 体验提升:用户获得更贴合体裁规范的输出(如歌词押韵、剧本格式),减少弃用率。
与现有产品/工作流的接口
该数据生成框架可直接作为 LLM 微调数据管线 接入:
- 属性配置层(
genre attributes)对接内容管理系统的风格/结构化标签。 - 合成得到的
query-response对用于指令微调或 DPO/RLHF 偏好数据。 - 质量过滤模块可作为在线推理前置校验,复用现有 content moderation 系统。
实际工程启示:与现有写作数据仅堆叠故事样本不同,受控体裁扩展(13 类体裁、50K 数据)在 OOD 基准上稳定超越 story-centric baseline,说明数据多样性设计比单纯增加数据量更关键。
具体落地 use case
- 电商营销:输入产品属性 + 品牌语气标签,生成符合“小红书体”“硬核评测”等多种文案体裁的种草内容,AB 测试中风格一致性提升显著。
- 互动叙事平台:用同一故事种子生成 branching dialogue、角色日记、歌词彩蛋等不同格式资产,实现一次创意多端复用,内容生产周期缩短。
局限
- **属性引导的体裁扩展** 依赖强 LLM 作为教师模型合成 query–response 对,生成数据的质量受限于教师模型的能力与偏见。创意写作中的微妙情感、文化隐喻和风格独创性可能难以被 LLM 完全复现,导致合成数据与真实人类创作之间存在分布差异。此外,质量过滤步骤的评价标准本身也由 LLM 或简单规则决定,可能误删真正新颖但不符合常规模式的样本,进一步限制数据多样性。
- **体裁属性** 依赖人工策划,尽管保证了结构、风格和格式的控制,但属性列表有限且静态,难以覆盖不断涌现的新体裁或跨体裁的混合形式。对于创意写作这类边界模糊的领域,人工定义的属性可能过于刚性,无法捕捉体裁内部的动态变化和子类型特征。因此,框架的扩展性受到限制,每次新增体裁都需要重新设计属性集,成本较高。
- **评估体系** 主要基于 out-of-distribution 写作基准和 held-out 体裁诊断,但创意写作质量高度主观,自动评估指标(如基于 LLM 的评分)虽然与人类评估有一定相关性,但仍可能忽略深层美学价值。论文中的人类评估规模未明确提及,可能不足以支撑统计显著性。此外,实验仅在有限数量的基座模型上验证,缺乏跨模型架构的泛化性分析,对实际生产环境中的适配性存疑。