基于概念的任意位置注视目标估计
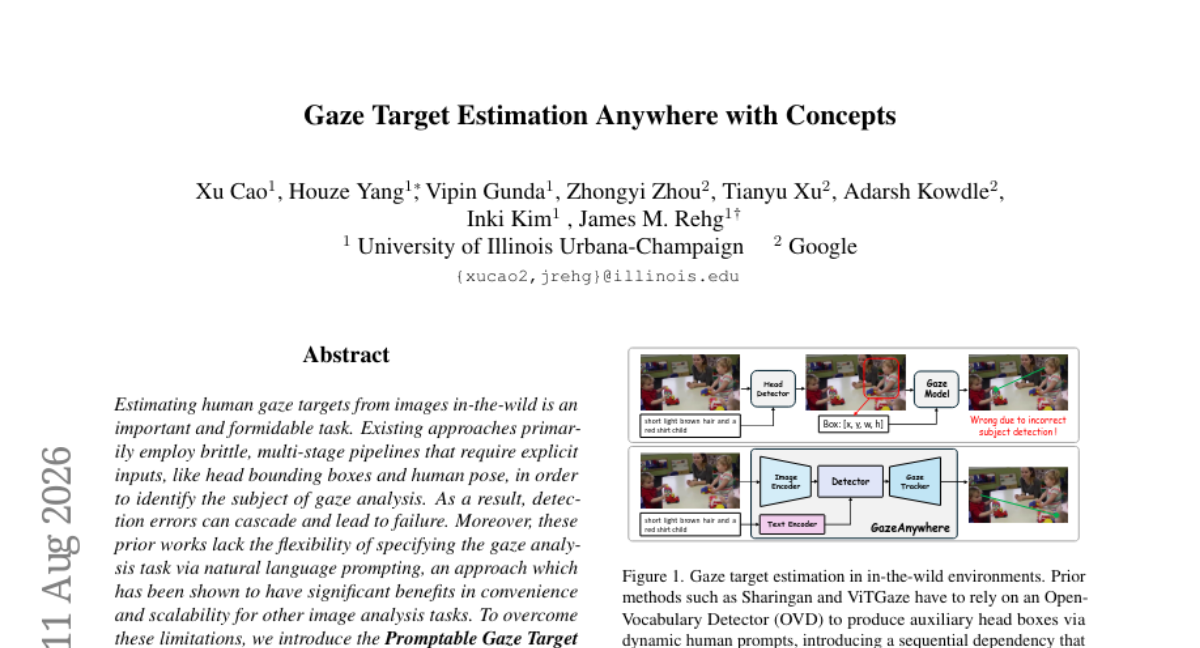
从野外图像中估计人类注视目标是一项重要且艰巨的任务。现有方法主要采用脆弱的多阶段流水线,需要显式输入(如头部边界框和人体姿态)来识别注视分析主体,导致检测错误级联并引发失败。此外,这些先前工作缺乏通过自然语言提示指定注视分析任务的灵活性,而这种方法已被证明在便利性和可扩展性方面对其他图像分析任务有显著优势。 为克服这些局限,我们提出了提示性注视目标估计(PGE)任务,这是一种新的端到端、概念驱动式注视分析范式。PGE 根据灵活的用户文本或视觉提示(例如"红衬衫的男孩"或"点 [0.52, 0.48] 处的人")来调节注视预测,以识别特定分析主体。该方法将主体定位与注视估计集于一体,消除了对中间分析阶段的刚性依赖。我们开发了一个可扩展的数据引擎,生成Gaze-Co(概念注视估计)数据集和基准,包含 12 万对高质量、带提示标注的图像。 我们提出了GazeAnywhere,这是首个为 PGE 设计的模型。GazeAnywhere 使用基于 Transformer 的检测器融合冻结编码器的特征,同时解决主体定位、帧内/外存在性以及注视目标热图估计。GazeAnywhere 在多个 PGE 基准上达到最先进性能,即使面对困难的跨域真实临床数据集,也为此新问题设定了强基线。
论文精读
TL;DR 引入 Promptable Gaze Target Estimation (PGE) 任务与 GazeAnywhere 模型,用文本/视觉提示端到端指定主体并预测注视目标,消除多阶段级联错误,在多个基准达到 SOTA,并开源大规模提示标注数据集 Gaze-Co。
问题
问题背景
视线目标估计(Gaze Target Estimation)旨在从单张图像中预测人正在注视的目标位置,是视觉理解、人机交互和增强现实中的关键任务。当前领域主要关注在 in-the-wild 场景下快速、鲁棒地定位视线目标,并支持对任意指定个体进行视线分析。
现有方法局限
传统方法大多采用多阶段流水线:先检测头部边界框或人体姿态,再基于裁剪区域进行视线估计。这种设计存在明显局限:
- 误差级联:前置检测模块的错误会直接传播到后续视线估计,导致整体性能脆弱。
- 输入僵硬:需要显式提供头部框、人体关键点等中间表示,无法通过自然语言或视觉提示灵活指定分析对象。
- 扩展性差:难以迁移到无边界框标注的真实场景,也无法像其他视觉任务那样利用 prompting 范式提升易用性与规模化能力。
为什么这个问题难且重要
视线目标估计的难点在于:
- 跨个体泛化:不同人的头部姿态、眼睛外观差异极大,且遮挡、光照、分辨率变化进一步加剧不确定性。
- 场景复杂性:目标可能位于画面内外、被遮挡或属于开放词汇类别,单一模型需同时处理目标定位与视线方向回归。
- 实时性要求:在 AR/VR 等交互场景中,系统需在移动端低延迟运行,传统多阶段流水线难以满足资源约束。
业界对 promptable vision 的关注持续升温,将视线估计纳入统一提示范式有助于简化部署、降低标注成本并提升模型复用性,是走向通用视觉理解的重要一步。
行业类比
类似开放词汇目标检测(如 GroundingDINO、OWLv2)用文本提示替代固定类别,本工作将“指定谁”的提示机制引入视线估计,让视线分析从定制化流水线转向通用可提示服务。
核心洞察
- **PGE** 将 gaze target estimation 从多阶段、依赖显式人体结构输入(head bbox、pose)的流水线,重塑为基于用户文本或视觉提示的端到端条件预测任务。与 prior 方法相比,PGE 无需先检测主体再估计视线,避免检测错误级联失败;prompt 充当 soft subject selector,支持自然语言交互,显著提升 in-the-wild 场景下的灵活性与可扩展性,为 AR agent 等应用提供了更简洁的调用范式。
- **GazeAnywhere** 通过 transformer-based detector 融合 frozen image/text encoders,联合输出 subject localization、in/out-of-frame presence 和 gaze target heatmap,避免了重型 backbone 的微调。相比 prior 的两阶段组合(如 GroundingDINO + ViTGaze),它在单一模型中端到端优化多任务,减少推理链路误差累积,同时冻结编码器降低训练与部署成本,在资源受限的 AR 设备上有实际工程优势。
- **Gaze-Co** 的 scalable data engine 生成 120K 个 prompt-annotated image pairs,解决了 PGE 监督数据稀缺的瓶颈。与 prior gaze 数据集仅标注 head bbox 和 gaze target 不同,Gaze-Co 为每张图配备 flexible text/visual prompt,支持训练时学习 prompt-conditioned subject selection;该引擎可扩展至更大规模,并在 difficult out-of-domain 临床数据集上验证了泛化性,凸显高质量自动标注数据对 gaze estimation 的关键作用。
方法
输入与提示
GazeAnywhere 接收一幅图像与一条自由形式的提示。提示可以是自然语言(如 "the boy in the red shirt")或视觉提示(如 "person in point [0.52, 0.48]"),用于指定需要进行注视分析的主体。
核心模块
- 图像编码器:冻结的视觉 backbone(如 DINOv2 或 CLIP 视觉塔)提取图像特征,不参与梯度更新,减少训练成本。
- 文本编码器:同样冻结的文本 encoder 将语言提示编码为文本特征。
- 投影层:将视觉和文本特征分别投影到共享维度,便于跨模态融合。
- 任务特定嵌入:一组可学习的 query embeddings,分别对应主体定位、frame 内/外存在性判断、注视热图估计三个子任务。
- Detector Transformer:采用类似 DETR 的 transformer 结构,以任务 query 为输入,对多模态特征进行交叉注意力,同时输出所有子任务的预测。
- Decoders:各任务专属的轻量解码头,分别产出主体边界框/点坐标、存在性分类 logits、以及注视目标热图。
输出与训练目标
模型直接输出三个结果:
- 主体定位:边界框或点坐标,指示被提示选中的主体。
- 存在性分类:判断主体是否出现在画面内,避免对 frame 外主体预测无意义的热图。
- 注视热图:概率热图,表示主体正在注视的位置(若主体在 frame 内)。
训练时使用多任务联合损失:定位损失(如 L1 + GIoU)、存在性二分类交叉熵、热图回归损失(如 MSE 或 focal loss)。推理时无需任何中间阶段,端到端输出。
与同类方法差异
传统方法依赖多阶段流水线(先检测头部框、再提取姿态、最后回归注视),级联误差严重且无法用自然语言指定主体;GazeAnywhere 通过 prompt 将主体定位与注视估计合并为单一 transformer 前向过程,消除了对显式中间输入的刚性依赖。
实验
实验设计
论文提出 PGE 任务,构建 Gaze-Co 数据集(120K 图像对,带 prompt 标注),并划分 concept-based in-domain 与 out-of-domain 测试集。基线包括 OVD 检测器(GroundingDINO-B、LLMDet-L、OWLv2-L)与 gaze 模型(ViTGaze、Sharingan、Gaze-LLE)的组合。实验覆盖主体定位、帧内/外判断、凝视热力图三项子任务。
关键发现
GazeAnywhere 在多个 PGE 基准上达到 SOTA,表明冻结图像/文本编码器 + 轻量 detector transformer 的端到端设计,能同时处理多任务,避免多阶段 pipeline 的误差级联。在真实临床 out-of-domain 数据上的表现尤其值得关注,说明自然语言 prompt 可迁移到分布外场景。消融实验显示冻结编码器类型、detector 维度与 transformer 层数会影响精度-效率 trade-off,具体数值未在摘要中提供。
基线对比深度解读
OVD + gaze 模型组合虽能分解任务,但无法端到端联合优化,且推理链路过长。GazeAnywhere 用单个 transformer 检测器融合多模态特征,减少组件间错误传播,工程上更易部署。对实际工程的启示:冻结预训练编码器,只训练轻量检测头,能快速适配新的视觉-语言任务,降低数据标注与训练成本。后续可探索更高效的 prompt 设计,以及 AR 眼镜等实时应用场景。
行业影响
落地场景
Promptable Gaze Target Estimation (PGE) 与 GazeAnywhere 可直接用于:
- AR / VR 设备:通过文本或视觉提示指定目标,实时输出其注视热图,支撑虚实融合协作与注意力对齐。
- 智能监控与安全:用自然语言查询“穿蓝色外套的行人注视哪里”,无需多阶段 head bbox 与 pose 检测,减少级联误差。
- 内容与广告分析:视频平台用提示获取观众对特定区域的注视热图,优化广告位或交互分支。
- 医疗辅助评估:临床眼动测试中指定“坐在轮椅上的老人”,自动输出注视目标,替代人工标注。
商业价值
传统 gaze target estimation 依赖显式 head bbox 与 human pose,检测错误会逐步放大,且无法灵活按需查询。PGE 将主体定位与注视估计合并为单一端到端模型:
- 降本:单模型替代多组件流水线,降低推理与维护成本;开源 GazeAnywhere 可直接试用。
- 体验提升:自然语言 / 视觉提示让非技术用户也能发起注视分析,交互门槛大幅降低。
- 新收入路径:可提示的注视分析可封装为 API,按查询计费,用于广告监测、直播互动等场景。
与现有产品/工作流的接口
GazeAnywhere 基于 transformer 检测器,融合 frozen encoders 特征,易于集成:
- 输入侧:接受文本 / 视觉 prompt,与 MLLM 或开放词汇检测器(GroundingDINO、OWLv2)天然衔接。
- 输出侧:同时给出 subject localization、in/out-of-frame presence 和 gaze heatmap,可直接供给下游决策或渲染模块。
- 工程上可作为独立微服务,利用 frozen encoder 缓存图像与文本特征,减少重复计算。
具体落地 use case:
- 电商直播复盘:运营输入 prompt “主播注视手机评论区频率”,获得注视热图与服务时间轴,量化互动有效性,替代人工回看。
- 自动驾驶舱内 DMS:用 prompt “驾驶员是否注视前方道路”直接输出 heatmap 与 out-of-frame 判定,比传统分步模型更鲁棒,且文本切换监控目标(如“副驾是否看后视镜”)无需重新训练。
局限
- **PGE 任务目前缺少统一的公共基准**,Gaze-Co 数据集虽达 120K 且包含真实临床 OOD 测试,但其概念标注主要依赖数据引擎自动生成,标注质量受限于上游检测与描述模型,可能引入视觉概念与语言描述的偏差,对多人遮挡、歧义指代等复杂场景覆盖不足。
- **GazeAnywhere 采用冻结的图像 / 文本编码器**,虽降低训练成本并保留预训练知识,但限制了跨模态特征在注视估计任务上的联合适配,对需要细粒度视线几何的特征(如眼球朝向、头部姿态)捕捉可能不足,未来可探索部分解冻或轻量适配。
- **与直接以自然语言输出注视目标的 MLLM 相比**,GazeAnywhere 仍输出热力图等中间表示,需额外后处理才能转化为可执行动作,在 AR / Agent 等实时交互场景中可能引入延迟;同时 PGE 目前主要支持单人提示,对多主体同时注视分析、群体交互场景的支持尚不明确。