AutoWorldModel-Bench: 面向自动化世界模型研究的以状态为中心的基准
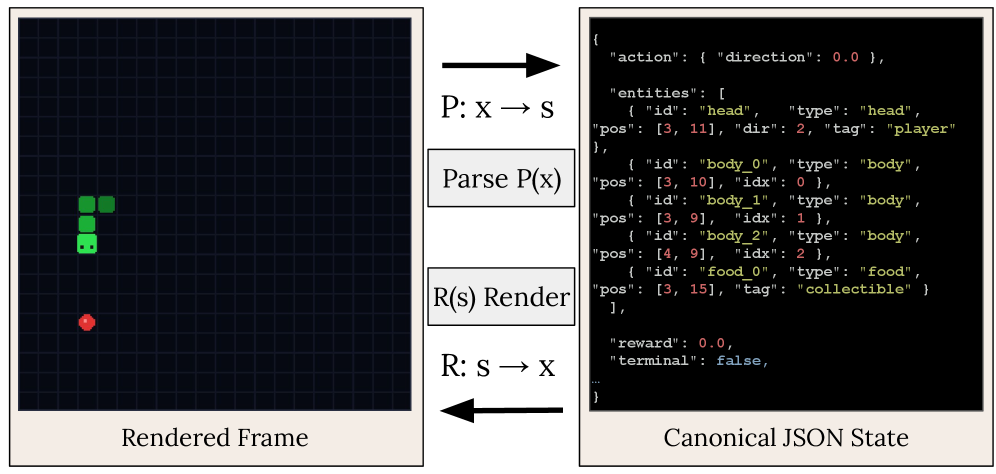
世界建模 是一个尚未定型的领域:架构、训练目标和状态表示以复杂方式交互,没有单一配方在所有环境中占主导。这使得它成为 AI 编码代理作为自主研究者的理想试验台——在这一设定下,改进方向并非预先指定,不同于当前代理基准中占主导的“按规格工程”任务。 我们引入 AutoWorldModel-Bench,一个闭环基准,前沿编码代理在固定计算预算下自主改进提供的世界模型起始代码。基准覆盖八个游戏环境,采用统一的结构化状态表示——从每个游戏中提取的 ground-truth 实体状态并通过共享张量格式输入——以此隔离动力学建模与感知,并实现分钟级迭代。 在 64 次会话中,Codex-5.4 与 Claude Opus 4.6 在 63 次中改进了起始代码;其中 91% 的获胜编辑属于非平凡的研究式修改——新目标、表示、回滚流程或架构改动——而非超参数调整。该基准为评估前沿编码代理的开放式研究能力提供了平台。
论文精读
TL;DR AutoWorldModel-Bench 是一个封闭循环基准,让前沿编码代理在固定算力下自主改进世界模型起始模型。64 次会话中 63 次改进成功,91% 的胜出编辑为研究级修改,证明代理能做出实质性研究创新。
问题
问题背景
世界建模是智能体学习的核心,涉及环境动态的预测与抽象,当前研究关注如何自动设计更优的动力学模型,以减少人工调参和试错成本。
现有方法局限
现有 AI 编码代理基准(如 SWE-bench)主要评估工程到规范任务,改进方向预先指定,无法反映开放式研究中的自主探索能力。世界模型设计涉及架构、训练目标、状态表示等多因素交互,传统手工搜索耗时且易陷入局部最优,且不同环境需不同适配,缺乏统一接口导致快速迭代困难,限制了对代理研究能力的系统评估。
为什么这个问题难/重要
世界建模尚无统一配方,设计选择直接影响下游任务的样本效率和泛化性能。开放研究任务没有明确正确答案,代理需自主提出假设、设计实验、分析结果,这对长期规划、代码理解与创新能力提出更高要求。业界对自主 AI 研究者期望高,自动化此类研究可大幅加速模型迭代,但现有基准无法衡量这种能力,故 AutoWorldModel-Bench 填补空白,其结构化状态隔离感知与动力学,使得迭代可在分钟级完成,适合代理快速验证想法。
行业类比
类似于用 AutoML 搜索神经网络架构,但世界模型搜索空间更复杂,且必须在多个动态环境中闭环验证,更贴近真实研究场景。
核心洞察
- - **状态中心解耦**:AutoWorldModel-Bench 用统一的 structured-state 表示(ground-truth entity state 共享 tensor)替代原始像素输入,将感知与动力学建模彻底分离。这使代理只需关注模型架构、训练目标和 rollout 策略,每次实验分钟级迭代,极大降低探索成本。与现有以像素为输入的 agent 环境相比,避免了感知噪声对动力学评估的干扰,让“研究改进”的信号更纯粹。
- - **开放研究而非工程到规格**:基准以“非平凡研究修改”作为胜出编辑的判定——91% 的改进来自新目标、表示、rollout 或架构变化,而非超参数调整。这为编码代理提供了不预设改进方向的评估场景,区别于目前以 spec 完成度为指标的 agent benchmark。它度量的是代理生成研究假设并验证的能力,更接近一个真正的自动研究员。
- - **长程 rollout 收益集中**:实验显示改进收益主要在长程 rollout 而非单步预测上。这表明世界模型研究的关键瓶颈是误差累积与长期一致性,单步损失无法反映实际性能。因此基准评测协议应更重视 rollout 质量,而非传统的 next-step prediction loss。对工程实践而言,开发世界模型时应优先优化轨迹级指标,并设计针对长期一致性的正则或架构。
方法
输入与任务定义
AutoWorldModel-Bench 接收一个 世界模型 starter(如 Dreamer 的 RSSM、AR-Transformer、D3PM、MaskGIT 等),在 8 个游戏环境中运行。每个环境提供 ground-truth 实体状态,通过统一的 结构化状态表示 抽取为共享张量格式,从而隔离感知任务,只保留动力学建模。代理(如 Codex-5.4 / Claude Opus 4.6)在固定计算预算内,对 starter 进行任意修改。
关键模块
- 状态与张量表示:从游戏引擎提取实体级状态(位置、速度、交互等),编码为跨游戏一致的
frame envelope和data tensor,使模型无需处理原始像素。 - 数据收集:使用 奖励塑形 的强化学习策略产生离线轨迹,覆盖不同 Game 的实体和动作细节;每环境包含多组 scenario-based 测试套件(如 Pong 15 组 460 集)。
- 世界模型评估协议:将测试拆分为不同预测 horizon(例如 one-step、long-horizon rollout),计算 scenario score,重点衡量长程 rollout 的动力学一致性。
- 代理 Harness:提供任务指令、会话持久化(native vs. externally-managed)和状态转换契约,代理可执行训练、修改架构/目标/表示,并以分钟级完成单次迭代。
输出与分类
每次会话输出改进后的世界模型及测试分数。系统将获胜编辑归类为 超参数调整 或 非平凡研究型修改(新目标、表示、rollout 过程、架构变化)。
跟同类方法的差异点:AutoWorldModel-Bench 不评估工程到规格(engineering-to-spec)能力,而是衡量编码代理在开放研究问题上的自主改进能力,且通过结构化状态完全移除感知因素。
实验
实验设计
AutoWorldModel-Bench 采用闭环评估,让 Codex-5.4 与 Claude Opus 4.6 在固定计算预算下自主改进 starter world model。基准覆盖 8 个游戏环境(Pong、Asteroids、Breakout、Snake、Platformer、Frogger、Kong、Racer),使用统一 结构化状态表示(从游戏中提取 ground-truth entity state,共享 tensor 格式),将动力学建模与感知解耦,单次迭代可在分钟级完成。共运行 64 个 session。
关键发现
- 在 63/64 session 中,agent 成功改进 starter,改进率约 98.4%。
- 91% 的获胜编辑是非平凡研究型修改,例如新目标函数、状态表示变化、rollout 过程调整或架构变更,而非纯超参数搜索。
- 收益主要集中在 long-horizon rollout 预测,而非 one-step 预测。
- 在 64 session 样本量下,两种 agent 无显著性能差异。
与基线对比解读
基线是不同架构的 starter world model(如 Dreamer (RSSM)、AR-Transformer、D3PM、MaskGIT)。Agent 以高概率找到有效改进,表明编码代理具备面向开放研究问题的探索能力;但须注意改进可能过拟合验证集,收益在长程 rollout 上明显,提示评估应侧重多步动力学一致性。该基准与工程规格型任务不同,更接近真实科研迭代,为自动化 world model 研究提供了可重复的试验场。
行业影响
落地场景
- 游戏开发:世界模型用于 NPC 行为预测、物理模拟与环境动态生成,AutoWorldModel-Bench 可让编码代理自动改进游戏中可交互实体的状态转移模型,提升模拟保真度。
- 自动驾驶仿真:车辆、行人、路况的动力学世界模型,代理可自动搜索更优架构与训练目标,加速仿真环境构建。
- 机器人/数字孪生:结构化状态表示隔离感知,适合工业设备预测性维护与操作仿真。
商业价值
- 降本:固定算力预算内自动探索研究式修改(新目标、表示、rollout procedure),减少专家手工调参时间。64 个 session 中 63 个改进 starter,91% 为 non-trivial edit,证明自动化研发的可行性。
- 体验提升:增益集中长程 rollout,改善游戏/仿真长时间行为一致性,减少物理穿模或 NPC 失智等体验问题。
- 增收:更快迭代世界模型可支撑更复杂的实时交互内容,提升用户留存与付费转化。
与现有工作流接口
- 作为 MLOps 研究代理层接入现有训练 pipeline:使用统一
state-transition contract,agent 读取数据、修改代码、提交实验、接收scenario-based test suite回报。 - 替换人工超参搜索:在 starter model 基础上,通过 agent harness 管理 session persistence 与 best-of-k 评估,集成进 CI/CD 评估门禁。
具体用例
- 游戏工作室:用 AutoWorldModel-Bench 驱动编码代理自动改进赛车游戏(Racer)或平台游戏(Platformer)的动力学世界模型,减少物理工程师逐关卡调试,并把结果部署到实时 NPC 行为预测服务。
- 电商/内容平台推荐:借鉴状态中心设计,用编码代理自动迭代用户行为序列的世界模型(状态=商品/内容实体),长程 reward 预测提升推荐策略,但需额外映射感知输入。
局限
- **统计功效与评估偏差**:论文在结果部分明确提示 `best-of-k` 选择可能高估代理能力,且两个代理在 64 个会话样本量下无法区分。该基准的会话间随机性、平台非确定性和起始模型波动较大,固定计算预算下的多次重启会放大方差,导致结论缺乏稳健的显著性检验。若要作为通用评测基准,需要更大规模会话数、更强随机种子控制以及更严格的多重比较校正,否则难以支撑代理间的可靠排序。
- **状态表示剥离感知的局限**:`AutoWorldModel-Bench` 使用每游戏的 ground-truth 实体状态作为统一张量输入,有意隔离动力学建模与感知。但真实世界模型的核心困难之一是从像素或原始传感器信号中学习紧凑状态,该基准完全绕开了这一环节,因此不能反映端到端 world model 研究的实际瓶颈。同时,每个环境需人工定制状态提取器和动作映射,扩展至新的复杂环境或连续控制场景的成本较高,限制了其作为长期自动化研究床的覆盖面。
- **环境多样性不足**:基准仅包含 8 个 2D 街机类游戏,动作空间离散、状态维度较低,且动态模式相对简单(如弹球、贪吃蛇)。缺少连续控制、3D 导航、机器人操作或长时程记忆依赖的环境,难以检验代理在更开放、更贴近真实世界建模挑战上的研究创新能力。此外,固定计算预算和分钟级实验限制了深度搜索和复杂多步研究策略的探索,可能导致对代理长期自主研究潜力的低估。