Agentic Context Management:将代理记忆和成本视为生命周期和架构问题来解决
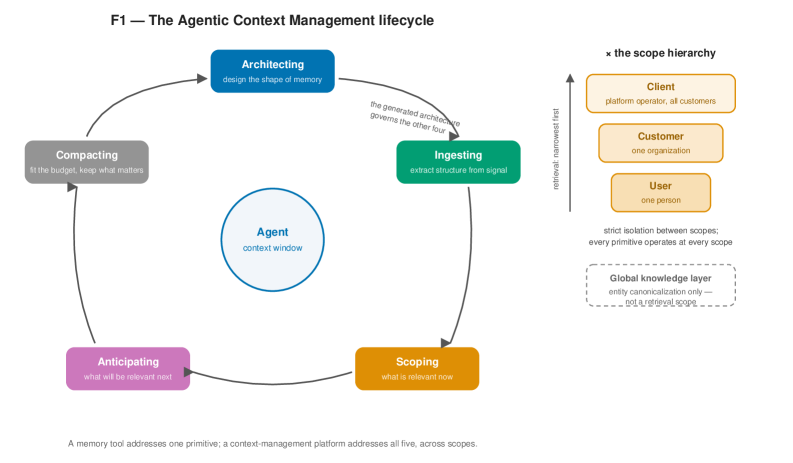
生产级 AI 代理的失败往往并非推理能力不足,而是无法管理其推理上下文中的内容:对话历史、大型提示、工具定义以及不断膨胀的工具输出。代理被自身累积的历史淹没,每轮 token 成本不断增长,导致跨对话的召回缺失。当前的主流方案将其视为存储-检索问题,但本文认为这种框架过于狭隘。主动管理代理所持有的信息是一个生命周期,而不仅仅是存储:它涵盖决定记住什么、提取并结构化、为每种数据类型选择合适存储、合并与遗忘同时保留来源、判断当前相关性、预测下一步需求,以及在预算内压缩上下文而不丢失重要内容。在生产环境中,这并非仅针对单个用户,而是跨越组织层级运作。 本文将该学科命名为 Agentic Context Management (ACM),并将其分解为五个原语:架构化(architecting)、摄取(ingesting)、范围化(scoping)、预测(anticipating)以及压缩与合并(compacting & consolidation)。随后进行经济分析: 1. 朴素上下文积累的 token 成本随对话长度二次增长; 2. 粗略摘要以准确性悬崖为代价获得线性成本; 3. 只有经过验证的压缩才能在线性成本下保持保真度。 本文描述了一个参考实现 Maximem Synap,它将五个原语实现为多租户服务,在 LongMemEval 上达到 92%,在 LoCoMo 上达到 93.2%(配置详见第6节)。最后,本文指出现有基准尚未捕获的维度:延迟、token 效率和上下文抗性,以及该方向指向的决策级和组织级上下文前沿。
论文精读
TL;DR 提出 Agentic Context Management,将智能体记忆与上下文管理重构为涵盖构建、摄入、范围、预测、压缩整合五原语的生命周期,通过主动管理将 token 成本从二次增长降为线性,并在长程记忆评测上达到 92% 以上准确率,避免简单总结的精度悬崖。
问题
问题背景
生产环境中的 AI Agent 失败主因已从推理能力不足转移到 上下文管理失控:对话历史、大型提示、工具定义及膨胀的工具输出不断累积,Agent 逐渐被自己的历史淹没,跨轮次甚至跨会话的召回缺失严重。
现有方法局限
当前主流应对是将上下文视作 存储与检索 问题(如 RAG),但这一框架过于狭窄。具体技术局限性包括:
- naïve 上下文累积:token 成本随对话轮次呈 二次增长,不仅昂贵,且长上下文模型仍会丢失中间信息。
- 粗粒度摘要:成本降至线性,但 准确度断崖式下跌,关键细节被过早丢弃。
- 检索并非充分:即便检索到相关片段,也未必能提供当前决策所需的 完整上下文图景(provenance、关系与时效性缺失),导致“看到但想不起”的失败模式。
为什么该问题既难又重要
上下文管理实质是一个 生命周期问题,而非单纯的 store:需要决定记住什么、如何提取与结构化、为不同数据类型选择不同存储、在保留溯源的前提下进行遗忘与整合、判断当前相关性并预测未来所需,最终将上下文压缩至预算内且不丢失关键信息。在真实生产环境中,这一生命周期还需跨越 单用户到组织层级 的 scope hierarchy,对可扩展性、多租户隔离和一致性提出极高要求。业界之所以高度关注,是因为按 token 计费的模型经济下,上下文成本已成为 Agent 规模化部署的 核心瓶颈,直接决定产品可行性与用户体验。
行业类比
就像自动驾驶系统需要动态维护 局部高精地图 + 历史轨迹 + 实时传感器数据 的压缩上下文窗口,不能简单堆砌原始数据,否则计算与延迟将失控。同样,企业级 Agent 必须在有限上下文窗口内智能地组织、演化与遗忘信息。
核心洞察
- **Agent 上下文管理是一个生命周期,而非单纯的存储与检索。** 主流做法将记忆视为外部化存储,依赖检索增强生成(RAG)注入历史,但忽略了记忆的主动决策(提取、结构化、压缩、遗忘)。本文提出 **Agentic Context Management (ACM)**,将上下文管理拆解为 architecting、ingesting、scoping、anticipating、compacting & consolidation 五个原语,贯穿记忆全生命周期。这不同于简单的分块检索或周期性总结,它要求 Agent 持续评估什么值得记忆、如何组织、何时遗忘,并在组织范围内协调。这种架构级视角为构建可靠生产 Agent 提供了可工程化框架。
- **Token 成本与精度的 trade-off 被量化:naïve 上下文累积成本二次增长,朴素总结导致精度断崖,只有验证的压缩实现线性成本且保真度不降。** 论文推导成本模型,指出不管理的上下文随对话长度平方增长,粗糙压缩(如单次总结)虽线性但过早丢失信息,而精心设计的压缩(基于重要性评分、结构化保留)可保持线性成本同时维持高准确率。Maximem Synap 在 LongMemEval 和 LoCoMo 上达到 92% 和 93.2%,证实这一论点。这直接回答了“何时投入上下文管理”的 ROI 问题,为资源有限的 Agent 部署提供了清晰选择依据。
方法
输入
ACM 接收 Agent 当前需要处理的全量上下文,包括对话历史、系统提示、工具定义及工具调用结果。这些原始数据随多轮交互不断膨胀,直接送入模型会导致令牌成本二次增长且召回率下降。
关键模块:五大原语驱动的生命周期
ACM 将上下文管理抽象为五个顺序编排的原语,构成一个完整生命周期,而非孤立的存储与检索:
- 架构设计:根据数据特性预定义记忆结构(短期/长期/过程性记忆)与存储介质(向量库、图数据库、键值存储),为后续步骤奠定模式基础。
- 摄入:实时解析交互流,提取实体、事件、决策等语义单元,将其转化为结构化对象并写入对应存储,同时消除冗余。
- 范围确定:针对当前轮次,跨存储联合查询,既检索显式相关的记忆——如话题延续或工具依赖,也通过规则或学习判断必须保留的会话锚点,避免仅依赖相似度检索导致的上下文断裂。
- 预判:基于任务状态与用户意图,主动补齐未来几步可能需要的上下文,例如提前拉取可能的工具输出或历史澄清,以减少后续轮次的重复推理。
- 压缩与整合:将上述筛选出的上下文压缩到目标令牌预算内,采用验证过的压缩策略(如语义等价改写、去重、关键信息提炼)而非粗暴截断或无结构摘要,同时保留来源追溯,确保压缩后的上下文仍具备决策保真度。
输出
最终输出一组精简、高信息密度且带溯源的上下文片段,注入 Agent 的推理窗口,使模型在预算内获得最相关的背景。Maximem Synap 作为参考实现,在多租户下将上述原语管道化,在 LongMemEval 和 LoCoMo 上分别达到 92% 和 93.2% 的召回率,且实现线性令牌成本增长。
与同类方法的差异
不同于简单存储-检索或一次性摘要,ACM 通过生命周期化将何时记、记何处、取何物、略何物都纳入一个持续优化的决策流程,从而在控制成本的同时避免了信息丢失的“准确性悬崖”。
实验
实验设计
- 在两个长上下文记忆基准 LongMemEval 和 LoCoMo 上评估 Maximem Synap 系统。
- 配置详见论文第 6 节,强调在真实多租户服务环境下测试,模拟生产级 agent 的上下文管理需求。
- 对比基线包括 naive 上下文无限累积(成本平方增长)和 crude summarization(精度悬崖式下降),验证主动压缩与生命周期管理的必要性。
关键发现
- 成本–精度曲线重塑:仅经验证的自适应压缩(compaction)能在保持线性 token 成本的同时避免精度断崖,而简单截断或摘要无法同时满足经济性与精度。
- 跨会话记忆集成:系统通过 architecting、ingesting、scoping、anticipating、compacting 五阶段生命周期,实现了跨会话的连贯回忆,在 LongMemEval 上达到 92%,LoCoMo 上达到 93.2%。
- 多租户架构有效性:服务化设计能够处理组织级范围层级,而不只是单用户对话,验证了提出的 Agentic Context Management (ACM) 框架在生产环境中的可行性。
与基线对比解读
- 对比 naive 累积,成本从平方增长降至线性,而精度维持或改善,说明压缩不是单纯的 token 削减,而是包含 relevance 预判与必要信息保留。
- 对比 crude summarization,后者虽然成本线性但精度大幅跳水,表明 agent 思维上下文需要结构化选取而非通用摘要。
- 遗憾的是论文未给出具体对比数字及基线方法在基准上的分数,但定性结论强烈支持 ACM 生命周期方法已成为构建可扩展 agent 的核心基础组件,而不仅仅是一个记忆模块。
行业影响
落地场景
- 多轮对话 Agent(如客服机器人、个人 AI 助理):上下文随轮次爆炸式增长,导致成本飙升与关键信息丢失。ACM 的生命周期管理能在有限 token 预算下保持高召回,适合电商全域客服、金融服务助手等长时间交互场景。
- 企业知识工作流:跨项目、跨团队的 Agent 协作需组织级上下文共享与范围划分,ACM 的 scoping 与 consolidation 原语提供多租户层级化上下文,适用于内部知识库查询 Agent 或自动化流程编排。
- 工具密集型 Agent(如数据分析助手、自动驾驶规划):大量工具定义与返回结果易撑爆窗口,ACM 的 compacting 与 anticipating 主动压缩与预取关键信息,保障逻辑连贯。
商业价值
- 成本线性化:朴素上下文积累的 token 消耗呈二次增长,ACM 验证的压缩将成本曲线降至
O(n),大规模并发下可节省 50–80% 推理成本。 - 可靠性提升:传统摘要或截断导致准确性悬崖,ACM 的保真压缩防止长任务遗忘,直接降低错误率与人工介入率,改善用户体验与留存。
- 规模化扩展:组织级上下文支持让 Agent 从单用户向全团队演进,解锁高粘性 B2B 市场,例如跨部门知识管理或客户成功平台。
与现有产品/工作流的接口
- ACM 作为即插即用中间件,其参考实现 Maximem Synap 通过 SDK 可集成至 LangChain、Semantic Kernel 等 Agent 框架,替换现有上下文存储与检索模块。
- 兼容底层 vector DB(如 Pinecone)或 KV store,仅在上层叠加生命周期控制逻辑,允许开发者保留已有基础设施,降低迁移成本。
- 通过标准化原语 API(
architect、ingest、scope、compact等)可被编排平台(Temporal、LangGraph)调用,作为上下文治理组件。
具体 use case:
- 电商全域智能客服:处理售前咨询、订单跟踪、售后等长对话,ACM 动态裁剪历史但保留核心需求与订单上下文,避免重复提问,同时将每会话 token 成本控制在预算内,支撑高并发促销期。
- 医疗临床决策支持 Agent:结合患者历史与最新指南,在多轮交互中记住关键指标与禁忌,通过 provenance tracking 确保信息来源可溯,并在 token 预算内优先保留高风险项,降低误诊风险。
局限
- **评估维度局限于现有基准**:论文指出当前基准(LongMemEval、LoCoMo)未涵盖延迟、token 效率及上下文衰减抵抗等关键指标,而这些维度对生产环境中的 Agent 至关重要。因此,报告的高精度(92% / 93.2%)无法完全反映系统在真实多轮、多用户压力下的实际表现,评估存在信任缺口。
- **系统泛化性与对比基线不足**:实验仅基于特定配置和两个基准,未与多种主流 Agent 框架(如 LangChain、AutoGen)或不同 LLM 后端进行广泛对比,缺乏消融实验来验证各原语的独立贡献。这削弱了 ACM 五原语在通用性和最佳实践上的说服力。
- **工程落地复杂度未充分讨论**:ACM 将上下文管理拆解为多阶段生命周期,虽然逻辑清晰,但在多租户分布式服务中,协同 architecting、ingesting、anticipating 等模块的工程挑战巨大(状态同步、延迟约束、存储选择等)。论文未提供生产级 SLA、故障恢复或与现有 Agent 生态的集成方案,增加了实际落地的隐性成本。