多模态说话人验证对说话人匿名化的威胁
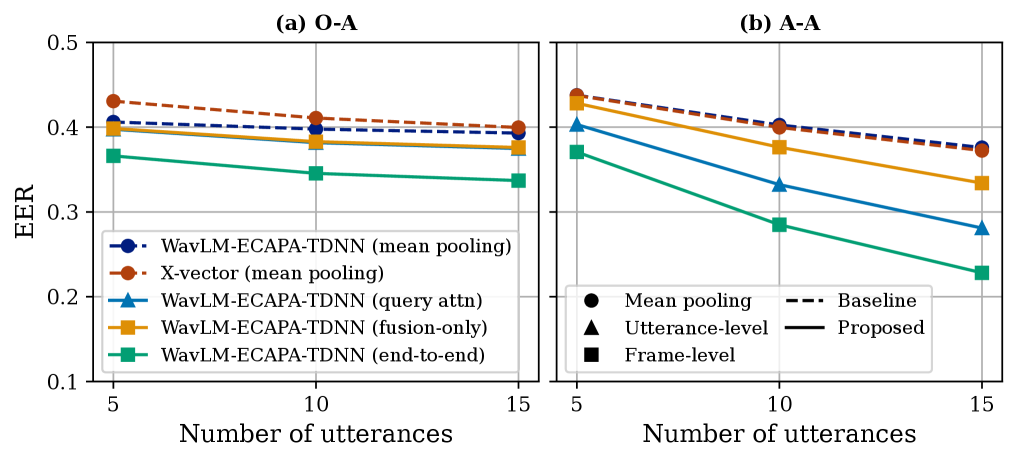
大多数自动说话人验证(ASV)系统基于单条话语运行,但真实交互通常包含多条话语。随着语音累积,声学、韵律和语言线索提供了越来越丰富的说话人信息,这可能会挑战主要针对声音特征的说话人匿名化方法。 我们研究多话语、多模态设置下的ASV,并考察跨匿名语音聚合信息对隐私的影响。首先,仅对多条匿名话语进行音频聚合,观察到随着语音增加性能持续提升。然后引入韵律和语言信息,多模态系统优于单模态方法。最后比较聚合策略,发现帧级聚合获得最低等错误率(EER)。 即使仅有五条匿名话语,结合音频和文本相比纯音频聚合使EER降低超过15%,证明匿名化后仍有大量说话人判别信息可被利用。
论文精读
TL;DR 通过聚合多匿名化话语的音频、文本与韵律信息,多模态说话人验证显著削弱匿名化效果,仅五句话即可将 EER 降低超 15%,暴露现有匿名化方法的脆弱性。
问题
说话人匿名化 长期聚焦于从单话语中抹除声学身份特征,但真实交互中用户会连续说话,声学、韵律、语言等多维信息持续累积。现有匿名化方法多数仅改造声道特性(如 x-vector 扰动),却忽视了多话语聚合带来的信息增益。攻击者可通过聚集多个匿名化话语提取韵律习惯(语速、停顿模式)与语言文本特征(用词偏好、语法结构),这些维度难以被声学匿名化有效遮掩。此外,帧级跨模态融合架构(如 RJCA)能以极低等错误率(EER)识别匿名化说话人,暴露了当前匿名化评测只考虑单话语、单模态的局限。该问题之所以棘手,是因为人类言语中的身份信号高度冗余且跨模态互补,仅处理声道维度如同只加密通信信道却忽略内容和元数据。业界对隐私保护要求日严,若匿名化方案在真实多话语场景下被攻破,将导致严重合规风险。类比自动驾驶的多传感器融合安全漏洞:仅加固激光雷达点云匿名化,攻击者仍可联合摄像头和轨迹数据还原身份。该研究提醒,匿名化必须覆盖所有潜在信息流,且需在多模态多话语条件下进行压力测试。
核心洞察
- 多话语聚合(multi-utterance aggregation)显著放大说话人验证性能,对声学匿名化构成严重威胁。现有声学匿名化系统通常仅针对单条语音的声学特征进行变换,但真实对话中说话人产出连续多句语音,携带累积的声学、韵律和语言线索。本研究证明,即使每条语音各自匿名化,通过跨话语聚合(尤其是帧级融合)仍可大幅降低 EER,且话语越多增益越明显。这揭示出传统单话语评估范式低估了隐私泄漏风险,匿名化方法的鲁棒性必须经受多话语场景的考验。
- 多模态信息融合(特别是文本转写)可有效绕过声学匿名化。即使声学特征被改动,说话人的措辞习惯、表达风格等语言指纹仍原样保留。将 ASR 转写文本与匿名化语音联合建模,相比纯音频聚合额外带来超过 15% 的相对 EER 下降。这说明仅聚焦声学的匿名化是不充分的,未来的隐私保护方案必须同时压制语言模态的辨别性信息,例如对转写文本进行风格迁移或词汇抽象化。
方法
方法输入为多个匿名化语音片段(utterances),可额外获取从语音中自动识别的文本转录(通过 Whisper 等),以及帧级韵律特征(如基频 F0、能量等)。整体流程分为特征提取、多层级聚合与说话人嵌入生成三部分。
音频特征使用预训练的 WavLM 提取帧级表示;文本特征由 Whisper 编码器产生 token 级嵌入;韵律特征则通过统计函数(均值、方差等)与音频帧对齐。
聚合策略分为两种粒度:
- Utterance-level Aggregation:先对每条 utterance 独立生成固定维度的说话人表征,再跨 utterance 进行加权平均或注意力池化。可在该阶段融合文本(如通过 Audio Query Attention 让音频特征查询文本信息)或融合韵律(将韵律向量与音频统计量拼接)。
- Frame-level Aggregation:直接拼接所有 utterance 的帧序列,再进行全局池化,或采用更复杂的跨模态融合。例如 Frame-level Audio-Text Fusion 将声学帧与对应文本 token 对齐,用交叉注意力建模时序依赖;Recursive Joint Cross-Attention (RJCA) 则递归地在音频与文本之间迭代更新表征,逐步提炼多模态说话人信息。最终生成统一的说话人嵌入。
训练采用端到端或两阶段方式:两阶段先分别训练音频、文本分支,再联合微调;也探索了在训练中提供不同程度的匿名化标签信息(lazy-informed / semi-informed)。与同类工作的差异在于:本文首次系统评估了多 utterance 与多模态聚合对匿名化说话人验证的影响,揭示了即使少量匿名语音,结合文本或韵律信息仍能大幅降低 EER,构成对现有匿名化方案的显著威胁。
实验
实验设计
实验构建了一个多话语 (multi-utterance)、多模态 的说话人验证场景,评估匿名化语音的隐私泄露风险。基系统基于 VoicePrivacy Challenge 基准,使用经匿名化处理的语音数据。
- 输入模态: 仅音频、音频+韵律、音频+文本、三者全融合。
- 聚合策略: 比较了 话语级聚合 (utterance-level) 与 帧级聚合 (frame-level),包括多种跨模态注意力融合方法(如 RJCA、WavLM-Whisper 交叉注意力)。
- 评估指标: 等错误率 (EER),测试不同数量匿名句(最多 5 句)下的识别性能。
训练采用两阶段策略,先端到端预训练,再结合说话人标签微调。
关键发现
- 声学匿名不足以消除说话人可分性: 即使全部话语经过匿名化,聚合多个话语(仅音频)就能持续降低 EER,表明模型仍能捕捉累积的声学残余。
- 多模态显著增强攻击: 融合文本转录后,仅 5 句匿名话语即可将 EER 相对音频仅聚合降低超过 15%,揭示匿名语音中语言内容与韵律携带大量说话人线索。
- 帧级聚合优于话语级: 帧级跨模态融合(例如
frame concatenation+ 文本交叉注意力)取得最低 EER,因为保留了更细粒度的时间对齐信息。
与基线的深度对比
传统说话人匿名化评估(如 VoicePrivacy Challenge)通常基于单句、仅声学的验证,忽略了真实场景下多句累积和多模态信息的威胁。本实验明确了:
- 现有的匿名化方案主要变换频谱/声道特征,对韵律模式 (prosody) 和说话风格/用词习惯几乎不设防,这导致多模态系统能轻易绕过声学层面的掩蔽。
- 与单句仅音频的基线相比,增加话语数量并融入文本,攻击成功率大幅提高,说明隐私保护评测需要升级到多话语、多模态测试条件,否则会严重低估反匿名化风险。
- 这一发现对隐私保护语音技术设计者提出警示:匿名必须覆盖声学、韵律及语言维度,且需要对抗多句聚合的攻击能力。
行业影响
落地场景
本工作揭示多模态说话人验证 (multimodal ASV) 能从匿名化语音中聚合声学、韵律、文本线索,大幅降低 EER。这一发现可直接赋能以下产品:
- 安全认证系统:金融机构的远程开户、电话银行声纹验证,可以利用多模态聚合增强对匿名化攻击的检测能力,弥补传统单句 ASV 的漏洞。
- 语音交互平台:智能音箱、车载助手在持续多轮对话中,即使对方使用匿名化工具,仍能可靠区分用户以提供个性化服务(需符合隐私法规)。
- 内容审核与取证:在直播、播客等平台,针对恶意使用匿名化语音的违规行为,多模态 ASV 可作为反匿名化取证工具。
商业价值
- 降低欺诈风险:金融、保险行业每年因语音合成与匿名化欺诈损失巨大。多模态聚合验证可将等错误率 (EER) 额外降低 15% 以上,直接减少因身份冒用导致的资金损失。
- 提升合规效率:对需要强身份认证 (KYC) 的远程业务,更鲁棒的说话人验证能减少人工复核成本,同时满足 GDPR 等法规对隐私保护的要求(需平衡隐私攻防)。
- 推动匿名化技术迭代:该研究暴露了现有匿名化方案的脆弱性,促使厂商研发新一代抗多模态聚合的匿名化算法,催生更安全的语音隐私产品。
与现有工作流的接口
现有 ASV 管道多为单句声学嵌入。集成该方案可采用轻量级扩展:
- 前端特征提取:复用现有 ASR (如 Whisper) 和韵律分析模块,抽取文本与韵律特征,无需改变原始语音处理流水线。
- 聚合层封装:将本文的帧级聚合 (frame-level aggregation) 或递归联合交叉注意力 (RJCA) 封装为微服务,接收多段匿名化语音,输出统一说话人分数。
- 后处理融合:与现有匿名化检测或活体检测模块串联,构成隐私安全评估套件,按商业需求动态调整阈值。
具体落地用例
- 全球支付平台的声纹反欺诈:攻击者使用匿名化工具伪装成受害者通过电话客服进行大额转账。系统收集连续 5 句对话,结合音频与转写文本执行多模态聚合,可在大幅降低误拒的同时拦截匿名化欺诈,EER 较单模态降低 >15%,显著减少资金损失。
- 跨国在线教育远程监考:考生可能用匿名化语音请人代答。平台通过多麦克风采集考生多轮答题音频,利用帧级音频-文本融合验证身份,确保考试公平,且无需额外硬件投入。
局限
- 实验主要基于 VoicePrivacy Challenge 的匿名化基线(如 McAdams 系数、循环一致等),未在不同匿名化技术间进行鲁棒性测试,结论可能不完全适用于其他匿名方案或更强的对抗场景。匿名化技术本身在演进,当前威胁评估的泛化性有待进一步验证。
- 攻击模型假设敌手能获取同一说话者多个匿名化话语及对应转录或韵律特征,但在真实应用中,此类多模态多话语数据的可获取性往往受限。实验未考虑数据获取成本与模态缺失情况,威胁评估在实际条件下可能被高估。
- 提出的融合与聚合策略(查询注意力、跨注意力等)均在较浅层的表示上进行,没有利用更先进的深度融合架构(如基于 Transformer 的联合编码),性能上限可能未充分挖掘。同时未探讨计算效率与实时性,对实际部署攻击系统的参考价值减弱。