Interactive Training 2: 用于实时模型训练的可审计控制平面
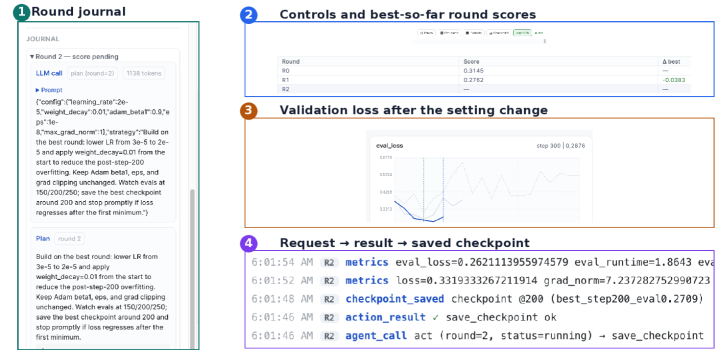
实验追踪器可以显示训练进度,但更改正在运行的训练任务通常仍需编写特定的训练器代码。我们提出 Interactive Training 2,一个开源控制平面,通过共享协议引导训练过程。训练应用声明它们暴露的设置和操作,人类和自动化控制器通过同一接口提交请求,训练循环在安全控制点验证并应用这些请求。定制的 Aim 工作空间 将实时指标和控件与请求及结果的按时间顺序记录相结合。我们在五个 NLP 和强化学习工作流上演示了该系统。发布的代码和追踪为可审计的人机引导训练提供了可复用的基础。
论文精读
TL;DR Interactive Training 2:一个开源控制平面,支持人与智能体通过统一协议实时操控训练过程,所有操作均可审计且无需编写定制回调代码。
问题
问题背景
在模型训练过程中,研究人员并非全程被动旁观——他们需要根据实时的损失曲线与评估指标,动态调整学习率、数据配比、停止时机等关键决策。当前领域关注如何将这种交互式训练从临时脚本提升为可复用的工程实践。
现有方法局限
主流的实验跟踪工具(如 Weights & Biases、MLflow)仅提供只读监控,展示指标变化,却缺乏通用的写入操控能力。研究人员若想改变训练中的超参数或触发动作,仍需编写与特定训练器紧耦合的回调(callbacks)或分支逻辑。这带来三个具体瓶颈:
- 复用性差:操控代码与单个实验绑定,无法在不同模型或框架间移植。
- 安全性缺失:随意在训练循环中插入修改可能引发状态不一致,缺乏验证与安全点机制。
- 可审计性空白:没有系统记录“谁在何时做了什么改变,产生了什么效果”,导致干预过程无法回溯或复现。
问题重要性
上述局限使得人机协同的实时训练调优难以规模化。当训练任务从单次实验扩展到多工作流、多 agent 协同(如 LLM agent 自动决策)时,缺乏统一的控制平面会急剧增加工程复杂度。同时,业界对训练过程的审计与合规要求日益增强,需要将每一次操控请求与结果作为审计日志持久化。技术上,挑战在于设计一个安全、异步、可验证的协议,既不对训练循环的性能造成明显侵入,又能在正确的时间点原子性地应用更改。
行业类比
就像 Kubernetes 通过声明式 API 与控制器模式统一了服务编排,交互式训练也需要一个类似的控制平面,让人类与自动化 agent 通过同一接口操控实时训练,并留下完整审计轨迹。
核心洞察
- **统一操控协议** 现有实验跟踪器(如 TensorBoard、Aim)仅提供监控,改变实时训练通常需编写特定于训练器的回调代码。Interactive Training 2 引入声明式控制平面:训练代码暴露可调设置与操作,外部请求通过共享协议提交,训练循环在安全控制点验证应用。解耦使人工与自动控制器使用同一接口且不侵入训练逻辑,为跨框架、可复现的交互式训练提供了通用基础设施。
- **审计日志与决策追溯** 系统将控制请求、执行结果与实时指标组合为完整时序记录,形成可审计的实验日志。这超越了传统 tracker 仅记录指标的做法,允许事后分析每次干预的影响并追溯决策上下文。对于理解复杂训练动态、调试干预副作用及合规性要求,完整的可追溯性提供了关键支撑,使训练过程从黑箱变为可审查、可解释的决策流。
方法
Interactive Training 2 引入了一个 可审计的控制平面 (auditable control plane),将训练过程从被动观察升级为可主动操控的闭环系统。其核心方法遵循 “声明-请求-验证-执行-记录” 的流水线:
输入:统一的变更请求
- 人类或自动化控制器(例如可选集成的 LLM Agent)通过 HTTP 接口 或 Aim 工作区 提交请求,格式为
request = (setting, new_value)或request = (action, payload)。 - 所有请求共享同一个协议,无需针对不同训练框架或任务编写特殊代码。
关键模块:安全注入与决策闭环
- 训练侧注册 (Declare):训练应用代码通过装饰器或补丁声明哪些超参数(如
learning_rate、batch_size)和动作(如save_checkpoint、stop)可供外部操控。 - 控制点验证 (Validate at safe points):训练循环在安全位置(例如
epoch结束或step间隙)主动拉取积压的请求,验证其合法性(值域、时机),防止不稳定的中途打断。 - 三种集成方式:为了兼容不同代码结构,提供
- Trainer 封装:适合基于
Trainer类的脚本; - Optimizer 补丁:透明拦截优化器更新;
- 直接集成:在自定义训练循环中手动插入
control_point()。
- Trainer 封装:适合基于
- 日志与追溯 (Journal):每个请求及其执行结果(成功/失败/延迟)被自动记录为一条不可变日志,与实时指标一起显示在定制化的 Aim 工作区,形成 从决策到效果的完整审计链。
输出:被干预的训练轨迹与审计记录
- 训练状态根据请求实时改变,例如动态调整学习率衰减策略或提前停止。
- 所有操控历史以 按时间顺序排列的记录 (chronological record) 形式长期存储,可复现、可复盘。
与 TensorBoard、WandB 等仅提供指标可视化但无写入能力的实验跟踪器不同,Interactive Training 2 通过统一的 双向控制协议 实现了“人在环路 (human-in-the-loop)”与“代理在环路 (agent-in-the-loop)”的标准化,并将操控过程本身变为可审计的一等公民。
实验
实验设计概述
论文通过 五个 NLP 与强化学习(RL) 工作流验证 Interactive Training 2 控制平面的实用性。实验并非聚焦于单一基准的性能提升,而是展示系统在不同训练场景下的操控灵活性、审计完整性以及统一接口的适用性。操控类型涵盖动态调整学习率、修改数据配比、触发检查点保存、提前中止不稳定运行等常见干预操作。每个训练应用通过声明式接口暴露可调设置和可用动作,人类操作者或自动化代理(可选 LLM agent)在相同 HTTP 接口上提交请求,训练循环在安全控制点验证并应用这些变更,同时 Aim 工作区记录完整的请求-结果时序日志。
关键发现
- 操控闭环与审计追踪:系统将原始的实验跟踪器从“只读”升级为“读写”工具,将每一次干预的发起者、时间、状态变化和结果写入 journal,形成可追溯的编排记录。
- 安全性与通用性:通过安全控制点(如 epoch 或 step 边界)施加变更,避免直接修改训练中间状态导致不一致;训练代码只需声明控件,无需编写特定回调,降低了接入成本。
- 人机协同训练:LLM agent 可与人类共享同一操控平面,初步展示了自动化 agent 根据实时指标决策的可能性。
与同类工作的差异解读
现有实验跟踪器(如 MLflow、W&B)主要解决观察问题,但缺乏标准化的动作通道,研究者通常需针对每个训练器编写定制回调。Interactive Training 2 借鉴控制平面思想,将操控逻辑从训练代码中解耦,通过统一协议实现跨项目的复用。这类似于 Kubernetes 将基础设施管理抽象为声明式 API,使得高级自动化成为可能。此外,其审计优先的设计为自适应性训练(如自动课程学习、动态超参调节)提供了工程基础,相比 ad-hoc 的实现,更便于复现和分享操控策略。
行业影响
落地场景
- 大规模模型训练:在 LLM 或扩散模型训练中,人类或自动化代理可动态调整学习率、批次大小,触发检查点保存或早停,无需中断训练或编写专用回调。适用于云 GPU 训练平台和内部训练集群。
- 在线学习与强化学习:在实时数据流或环境交互中,根据指标变化调整探索系数、部署新策略,并记录每次决策。
- 合规审计场景:金融、医疗等行业的模型训练需完整记录人为干预的决策依据与结果,满足监管追溯要求。
商业价值
- 降本:通过早停和动态调整减少无效计算,节省 GPU 小时成本。例如 LLM 预训练中检测到 loss spike 后立即降低学习率,避免更多步数浪费。
- 提效:统一接口消除为每个实验编写专用回调系统的工程开销;LLM agent 可承担夜间值守,减少人力介入,加速实验迭代。
- 合规与可审计性:完整记录所有操控请求与效果,提供不可篡改的训练日志,降低合规风险。
与现有产品/工作流的接口
- 实验跟踪工具扩展:可作为 Aim、MLflow、WandB 的集成,在仪表盘中增加控制面板,实现“观察-行动”闭环。
- CI/CD 管线:通过 HTTP 接口与外部自动化流程(定时任务、监控告警)对接,触发训练调整。
- 低侵入集成:训练代码仅需通过装饰器或注册函数声明暴露的
settings和actions,易于迁移现有项目。
具体落地 Use Case
- 电商推荐模型在线更新:实时流式训练中,模型性能随用户行为漂移。当监控系统检测到 CTR 下滑时,自动控制器通过 Interactive Training 2 接口调整学习率或回滚检查点,操作记录至审计日志供复盘。
- LLM 微调(RLHF)中的自动化干预:LLM agent 观测奖励曲线和 KL 散度,发现 reward hacking 时自动发送请求调整 KL 惩罚系数或停止训练,所有决策被记录以保证透明性。
局限
- **实验覆盖领域较窄**:论文仅在五个 NLP 和强化学习工作流上验证了 Interactive Training 2 的有效性,未涉及计算机视觉、多模态或大规模分布式训练场景。虽然协议设计声称通用,但实际控制点(如学习率调整、数据重平衡)在这些领域的适用性和安全性(如梯度通信时的阻塞)尚未得到验证,无法保证系统的跨领域鲁棒性。
- **集成侵入性较高**:为使用控制平面,训练代码必须显式注册设置和动作,并通过 `Trainer` 补丁或直接集成的方式接入控制循环。对于已有复杂回调逻辑的大型训练框架(如 Megatron、DeepSpeed),这种修改可能破坏现有工程结构,增加迁移成本,且未提供自动化迁移工具,可能阻碍广泛采用。
- **与实验追踪器的耦合性**:系统深度依赖 Aim 实验追踪器来展示实时指标和控制界面,虽然提供了定制工作区,但未定义与 TensorBoard、WandB 等其他流行追踪器的标准接口。用户若已建立基于其他追踪器的 CI/CD 流水线,部分功能(如审计记录的可视化)无法直接复用,面临工具链碎片化风险。