CADENCE: 通过覆盖自适应在线策略蒸馏缩小推理差距
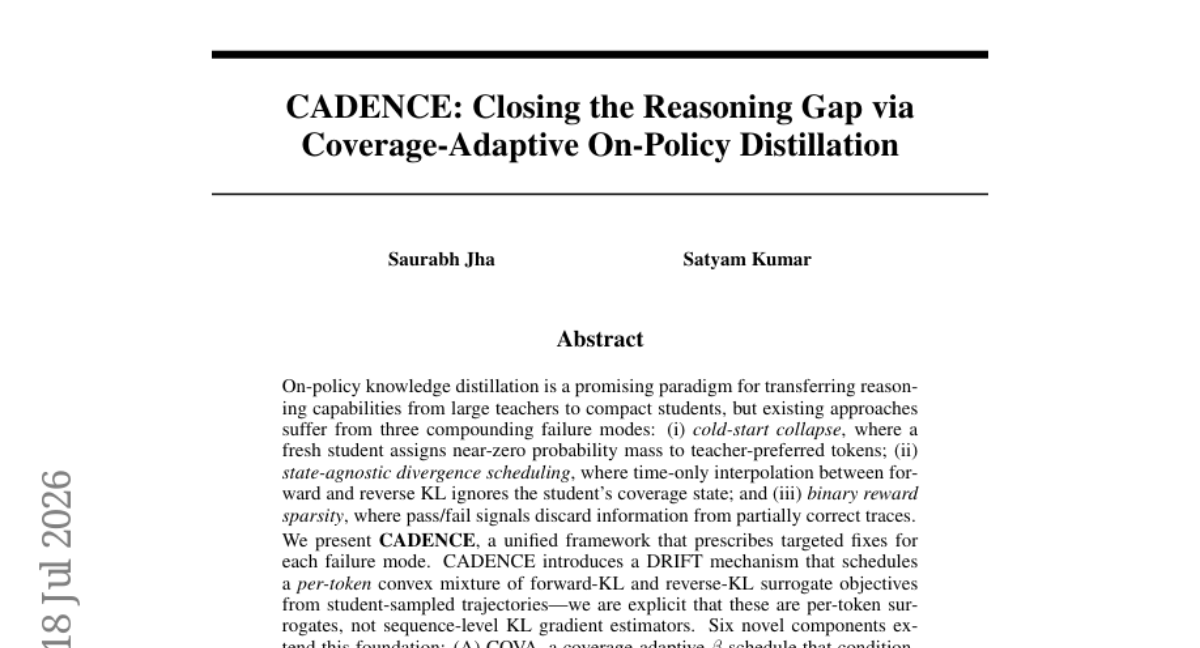
现有在线策略知识蒸馏从大教师模型向紧凑学生模型迁移推理能力时,常遭遇三种级联失效模式: 1. 冷启动崩溃:全新学生模型对教师偏好token赋予接近零概率; 2. 状态无关的散度调度:仅依赖时间步的前向/反向KL插值忽略学生的覆盖状态; 3. 二元奖励稀疏性:pass/fail信号丢弃部分正确轨迹中的信息。 CADENCE 提出统一框架,针对每种失效给出修复。其 DRIFT 机制在学生采样轨迹上调度逐token的前向KL与反向KL替代目标的凸混合(逐token替代,而非序列级KL梯度估计)。框架包含六个扩展组件: - COVA:覆盖自适应的β调度,加速前向到反向的转换; - FTB:分叉token提升,通过全局归一化熵参考对高熵位置集中梯度; - CCD:密集奖励,为不正确但接近的轨迹添加数值邻近部分信用; - LAP:偏好简洁正确轨迹的强化; - EMR:熵匹配校准正则化器; - BSD:引导式自蒸馏阶段。 在 GSM8K 和 MATH-500 上(校正后512 token协议,5种子,报告标准差),CADENCE 将 0.5B 学生从 1.5B 教师蒸馏至 69.8±0.5% GSM8K pass@1(预训练基础 48.7%,教师差距闭包 63.2%);使用 3B 教师达 72.1±0.4%(闭包 76.2%),比最强匹配计算量的标签使用基线(DRIFT+二元奖励)高出 +4.4±0.7 个点。所有实验在单台 Apple Mac Studio(M系列,64GB统一内存)上运行,表明原则性蒸馏无需数据中心规模硬件即可达到强推理质量。
论文精读
TL;DR CADENCE 通过覆盖率自适应的在线策略蒸馏,以 DRIFT 机制和六个创新组件直接修复冷启动崩塌、散度调度失误与奖励稀疏三大失败模式,在小模型推理蒸馏中显著缩小差距。
问题
问题背景
On-policy 知识蒸馏正成为将大语言模型的推理能力迁移至小模型的关键范式,它通过让学生模型从自身采样轨迹中模仿教师分布,提升小模型的数学推理、代码生成等能力。
现有方法局限
然而,现有方法受困于三个复合失败模式:
- 冷启动崩溃:初始学生模型对教师偏好的 token 分配近乎零概率,导致反向 KL 散度梯度消失,训练几乎停滞。
- 状态无关的散度调度:仅依据训练步数在 forward-KL 与 reverse-KL 间插值,忽略学生实际覆盖状态,在尚未覆盖时过早切换到 reverse-KL 会加剧崩溃。
- 二元奖励稀疏:仅依据最终答案的正确/错误给出反馈,丢弃了部分正确推理轨迹中的信息,使梯度信号极度稀疏。
为什么此问题难且重要
这三个挑战彼此纠缠:冷启动使梯度从第一步就消失,静态调度无法适应,二元奖励又无法提供中间指导。要打破僵局,需要同时设计(1)自我调节的散度选择策略,(2)针对高信息量 token 的梯度聚焦,(3)连续奖励设计以利用部分正确轨迹。在部署层面,业界急需能在消费级硬件上产出强推理效果的小模型,而现有蒸馏方法要么依赖巨大计算资源要么效果不佳,因此高效、鲁棒的 on-policy 蒸馏具有重要实用价值。
行业类比
类似强化学习中将稀疏奖励重塑为稠密奖励以加速策略学习,推理蒸馏需要利用部分正确轨迹的结构为小模型提供更丰富的学习信号。
核心洞察
- **逐 token 的前向/反向 KL 代理混合**:CADENCE 的 DRIFT 机制在每个 token 上计算 forward-KL 与 reverse-KL 的凸组合作为代理损失,而非依赖序列级 KL 梯度估计或轨迹级奖励。这直接避免了传统 on-policy 蒸馏中因冷启动导致的学生概率崩塌,以及 RL 方法(如 GRPO、DPO)中因稀疏二进制奖励带来的高方差。工程上,逐 token 的细粒度信号使训练更稳定,无需数据中心级硬件即可在单机完成从 1.5B 教师到 0.5B 学生的推理蒸馏,为资源受限场景提供了高效方案。
- **覆盖自适应调度与分叉 token 增强**:CADENCE 的 COVA 组件根据学生模型对教师分布的覆盖度动态推进 forward→reverse KL 混合,比固定时间表更快跳出模仿阶段。FTB 则利用全局归一化熵识别出推理路径中的高不确定性“分叉 token”,并集中梯度以提升关键决策点的学习效率。这种动态、token 级自适应策略解决了现有方法中状态无关(state-agnostic)的调度问题,与均匀 token 权重或仅基于时间衰减的方案相比,能显著缩短有效探索所需步数,在数学推理任务上展现出更高的样本效率与蒸馏增益。
方法
输入与问题定位
CADENCE 面向大语言模型推理能力蒸馏,输入为教师模型(1.5B/3B)与学生模型(0.5B),以及数学推理任务(如 GSM8K、MATH-500)。现有在线蒸馏方法存在三个并发失败模式:(i) 冷启动崩溃——学生初期对教师偏好 token 分配概率近乎为零;(ii) 状态无关散度调度——仅按训练步数线性插值前向/反向 KL,忽略学生实际覆盖状态;(iii) 二元奖励稀疏——仅依据最终答案对错给予信号,丢弃部分正确轨迹的信息。
核心模块:DRIFT 与六大创新组件
CADENCE 以 DRIFT 机制为骨架:在每个 token 上构造前向 KL 与反向 KL 的凸组合代理目标(而非序列级 KL 梯度估计),让训练信号直接作用于 token 层面。其混合权重 β 由覆盖自适应调度器 COVA 控制——当学生于某 token 的概率分布与教师重合度低时,β 加速偏向反向 KL(强迫学生覆盖教师分布),反之渐近切换至前向 KL(允许学生自由探索)。
在此基础上,六大组件强化训练:
- FTB (分叉令牌增强):通过全局归一的熵参考,识别高熵的“分叉令牌”(推理路径易发散处),将梯度集中于此,提升关键决策点的学习;
- CCD (密集部分信用):对最终答案错误但中间推理接近正确的轨迹,按数值邻近度赋予连续奖励,缓解奖励稀疏;
- LAP (简洁偏好强化):对正确推理路径额外奖励更短的生成,抑制冗余;
- EMR (熵匹配正则):在分叉令牌上匹配师生模型的输出熵,校准学生的不确定性表达;
- BSD (引导自蒸馏):训练后期以学生自身作为教师进行自蒸馏,进一步巩固性能;
- 所有组件联合后,通过熵裁剪、梯度 clipping 等稳定化机制避免训练崩溃。
输出与差异化
输出为精炼后的 0.5B 学生模型,在 GSM8K 上 pass@1 从基线的 48.7% 提升至 69.8%(1.5B 教师),或 72.1%(3B 教师),仅用单台 Apple Mac Studio 完成训练。
与同类方法差异:CADENCE 首次在 token 级用凸组合代理目标替代序列级 KL 梯度估计,并以覆盖状态动态调度,同时通过密集信用、分叉令牌聚焦和自蒸馏等组合,系统性地克服了数学推理蒸馏中的冷启动与奖励稀疏难题,且不依赖数据中心级硬件。
实验
实验设计
实验在数学推理数据集 GSM8K 和 MATH-500 上进行,将 1.5B 和 3B 参数的教师模型的知识蒸馏到 0.5B 参数的学生模型。训练采用完整的 CADENCE 框架,包括 DRIFT 的逐令牌 KL 混合目标,以及 COVA、FTB、CCD 等六个新颖组件。所有实验使用 on-policy 采样和 512 令牌评估协议,重复 5 个种子并报告标准差。训练仅需单台 Apple Mac Studio(M 系列芯片,64GB 统一内存),无需大规模算力集群。
关键发现
CADENCE 通过三个针对性创新有效缓解了 on-policy 蒸馏的固有缺陷:
- 覆盖自适应调度 (COVA):动态感知学生模型的覆盖状态,条件性地加速从 forward-KL 到 reverse-KL 的转换,避免了传统时间固定调度造成的冷启动崩溃。
- 分叉点增强 (FTB) 与熵匹配正则化 (EMR):将梯度集中在推理路径的高熵决策点,提升了探索效率与稳定性。
- 连续密集奖励 (CCD):利用数值接近度提供部分正确性信号,克服了二元奖励稀疏的问题,使不完美但接近的推理路径也能获得有效梯度。
量化结果:
- 1.5B 教师 → 0.5B 学生:GSM8K pass@1 69.8±0.5%,相比预训练(48.7%)提升 21.1 个百分点,闭合教师差距 63.2%。
- 3B 教师 → 0.5B 学生:GSM8K pass@1 72.1±0.4%,闭合差距 76.2%。
训练过程稳定,诊断指标如 FTA (分叉点准确率) 和 SAG (选择能力差距) 均显示显著改善。
与基线对比深度解读
在同等算力条件下,CADENCE 显著优于使用标签的基线方法 DRIFT+binary reward:在 3B 教师蒸馏 0.5B 学生的任务上带来 +4.4 个百分点的绝对提升。这一提升的核心来源是覆盖自适应调度和密集奖励的协同作用:
- 传统方法采用固定 schedule 在 forward-KL 和 reverse-KL 间插值,无法根据学生当前覆盖情况动态调整,容易过早转向 reverse-KL 导致模式坍塌;COVA 仅在学生具备足够覆盖率时才加速过渡,保证了探索-利用的平衡。
- CCD 的数值部分奖励,相比仅依赖最终答案对错的二元信号,为中间推理步骤提供了更密集的监督信号,显著提升了采样效率和最终准确率。
这些设计使得在消费级硬件上实现了具有竞争力的推理蒸馏效果,为推理能力的低成本迁移提供了实用化框架。
行业影响
落地场景
CADENCE 框架使小模型(0.5B)获得接近大模型(1.5B–3B)的数学推理能力,且全流程可在消费级硬件(Mac Studio)上完成。这直接支撑端侧推理助手、离线代码/数学解释引擎、轻量化教育辅导工具等产品。例如,移动应用内的数学题分步讲解、编程辅助的实时逻辑校验、无网络环境下的金融建模分析等场景均可受益。
商业价值
- 降低算力成本:在单台 Mac Studio 上即可完成蒸馏,免去数据中心高昂的 GPU 集群费用,中小团队也能构建高性能推理模型。
- 扩大产品覆盖:小模型可直接部署在手机、平板甚至浏览器端,无需依赖云端推理,带来低延迟体验并消除 API 调用成本。
- 提升用户黏性:提供更准确、可解释的 AI 辅助(如分步骤解题),能显著增强教育、金融等付费场景的用户留存。
与现有产品/工作流的接口
CADENCE 可作为训练阶段的模块嵌入现有的 LLM 微调管线:
- 使用教师模型生成的采样轨迹,替代标准 SFT 或 RLHF 中的二元奖励;
- 其 DRIFT 损失可直接替换 HuggingFace Trainer 中的损失函数,配合 COVA 等调度逻辑;
- 与 GRPO、PPO 等 RL 方法兼容,CCD 稠密信号可增强 reward 建模,LAP 可优化输出长度;
- 输出即为标准 PyTorch 模型,可直接用 vLLM 或 ONNX Runtime 部署到推理服务。
具体落地 Use Case
- 教育科技:一家在线数学辅导平台需要为学生提供实时解题步骤检查。使用 CADENCE 将 3B 模型蒸馏为 0.5B 模型并部署在 App 端,实现毫秒级响应,同时保护学生隐私(数据不上传云端)。
- 金融分析:投资分析工具内嵌一个轻量推理模块,用于解析用户输入的自然语言财报问题,并自动生成带计算逻辑的答复。CADENCE 使模型在消费级服务器上完成训练和推理,降低合规风险与基础设施支出。
局限
- 实验仅覆盖数学推理任务(GSM8K 和 MATH-500),未在其他推理领域(如代码生成、科学推理)或更广泛的语言任务上验证泛化性。论文未讨论该方法对多语言或不同难度分布的扩展能力,可能限制其作为通用 on-policy 蒸馏方案的适用性。
- 虽然方法在单机低资源硬件上表现优异,但未与大规模分布式训练下的同等或更强 baseline(如多卡多批次蒸馏)公平对比。这种比较缺失可能导致无法确认该方法在常规计算资源下的边际收益,也无法评估其在大规模学生模型或更大教师模型上的伸缩性。
- CADENCE 引入六个新组件和多个超参数(如 β 调度、forking token 阈值、全局熵参考等),虽然消融实验展示了各自贡献,但未充分报告超参数敏感性分析。在工业部署中,调参成本可能成为障碍,且各组件间的相互影响未量化,整体复杂度较高,增加了实际应用的工程负担。