驾驶座上:自动驾驶系统测试现实的多公司研究
自动驾驶系统(ADS)正快速进步并越来越多地部署于实际应用中,这对有效测试提出了更高要求,以确保系统功能与安全。然而,ADS 测试仍然复杂,且在场景选择、性能评估和验收标准方面缺乏成熟标准。为深入了解当前 ADS 测试实践与挑战,我们对来自六个国家九家公司的 ADS 开发与测试专家进行了访谈研究。通过主题分析,我们综合了工业测试实践、挑战、潜在解决方案、未来趋势,并提出了一个以证据为中心的闭环测试框架。 研究发现,当前实践主要聚焦于基于场景的测试和X-in-the-loop测试方法,并辅以多样化的工具、指标、基准和测试策略。参与者强调了与场景真实性、场景覆盖度、仿真保真度和验收标准相关的重大挑战,同时讨论了潜在解决方案,如使用人工智能、世界模型和端到端方法。此外,参与者展望未来的 ADS 测试将变得更加自动化、数据驱动且行业透明。 总体而言,本研究提供了对 ADS 测试的全面行业视角,提出了以证据为中心的闭环测试框架,为 ADS 测试提供可操作指导,并为未来研究与实践指明了重要方向。
论文精读
TL;DR 基于六国九家公司的访谈,揭示自动驾驶系统测试的真实实践、挑战与趋势,提出证据驱动的闭环测试框架,为行业提供可操作指引。
问题
问题背景
自动驾驶系统 (ADS) 正加速商业化落地,但测试标准与评估方法远未成熟,场景选择、性能验收和安全性论证缺乏行业共识。
现有方法局限
当前主流实践依赖场景驱动测试与 X-in-the-loop 仿真,但面临多重制约:
- 场景真实性不足:仿真场景难以精确还原真实世界传感器噪声、交互不确定性与边缘案例,导致 sim-to-real gap 显著。
- 场景覆盖度有限:由于长尾场景组合爆炸,现有场景库无法系统覆盖关键安全场景,遗漏风险高。
- 接收标准模糊:缺乏量化、可解释的安全通过准则,企业多凭经验设定 "shadow mode" 退出或里程指标,难以向监管方提供严谨的安全论据。
- 基准与工具碎片化:公开基准稀缺,企业内部工具链互不兼容,阻碍测试结果的可比性与复现。
为什么这个问题难且重要
ADS 属于安全关键系统,测试需在高维开放环境中验证感知-规划-控制的端到端行为,技术挑战包括:
- 无限场景空间与有限测试资源的根本矛盾;
- 物理仿真与真实世界的本质差异,导致仿真置信度难以量化;
- 安全论证需要结合运行数据闭环,但行业缺乏统一的证据链结构与接受标准。 这些挑战直接制约商业部署节奏与法规制定,是该领域最急迫的工程难题之一。
行业类比
这类似于大语言模型的安全对齐测试——即使有红队测试和基准集,仍缺乏对复杂涌现行为的系统覆盖与可靠通过标准,导致部署后意外频发。
核心洞察
- 工业界 ADS 测试面临场景真实性与覆盖度的根本矛盾,但现有学术研究多聚焦场景自动生成算法,忽视了仿真保真度不足和验收标准缺失如何导致测试闭环断裂。本研究基于六国九家公司的深度访谈,首次系统揭示了从场景库构建到安全论证的碎片化现状,并提出了证据驱动的闭环测试框架,将场景质量评估、证据门禁和运维反馈贯通,为连接测试数据与安全决策提供了缺失的一环。
- AI 与世界模型在测试中的应用正从辅助被测系统转向重塑测试范式本身。访谈显示,测试自动化、数据驱动评估和持续学习被认为是下一代测试的核心特征,意味着测试工程需要自身的智能化,例如使用世界模型生成高保真交互场景、用端到端模型自动评估测试结果。这突破了传统将 AI 局限于感知与规划的视角,提示测试体系必须与系统同步演进,以实现从验证环节到演进引擎的转变。
方法
研究方法详解
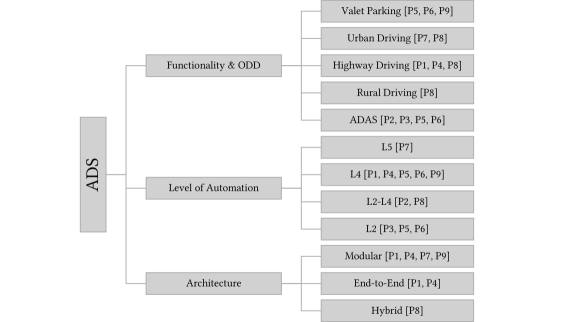
输入:从 9 家跨国企业(覆盖 6 个国家)招募 ADS (Autonomous Driving System) 研发与测试专家,通过半结构化访谈获取一手定性数据。样本覆盖不同功能设计运行域(ODD)、自动化等级(L2–L4) 及系统架构(模块化、端到端等),确保视角多元。
关键模块:采用主题分析法(Thematic Analysis) 进行系统编码。流程包括:
- 开放编码:多位研究者独立标注访谈转录稿,提取初始概念;
- 主题提炼:通过多轮交叉比对与迭代讨论,合并相似概念,形成高阶主题;
- 可靠性保障:记录编码决策链,进行参与者三角验证(member checking),并充分描述研究情境以降低效度威胁。
输出:归纳出四大主题领域:
- 测试实践:覆盖流程(计划策略、流水线、活动、过渡及满意度准则)、测试方法(场景驱动、X-in-the-Loop)、指标、基准及工具生态;
- 测试挑战:提炼出 13 类挑战,包括仿真保真度、场景真实性不确定、场景覆盖不全、验收标准模糊等;
- 未来趋势:朝向更自动化、AI 驱动、高透明度及世界模型与端到端方案演进;
- 证据中心闭环测试框架:提出六阶段框架—— (1) 定义安全声明与测试意图,(2) 构建并维护场景组合,(3) 规划证据生产与测试环境路由,(4) 应用证据门与验收准则,(5) 建立安全论证并决策,(6) 从运行中闭环学习。
差异点:不同于以往仅依赖公开文献或单案例的研究,本工作以多国多公司专家访谈为基础,提供了跨组织边界、涵盖完整开发生命周期的工业级实践全景,并首次将证据中心设计(ECD) 与闭环学习相结合形成可操作的 ADS 测试框架。
实验
研究设计
本研究采用多案例访谈研究(interview study)方法,从 6 个国家 9 家公司的 ADS 工程团队中招募 27 名专家,通过半结构化问卷收集定性数据。访谈聚焦三大主题:测试实践、测试挑战与未来趋势。所有对话录音转录后,由两位研究者独立进行主题分析(thematic analysis),经多轮编码与会聚形成最终主题树,并通过成员检查(member checking)和审计追踪增强可信度。
关键发现
- 实践现状:当前工业界以场景驱动(scenario-based)和X-in-the-loop(如 MIL/SIL/HIL/VIL)为主流测试范式,配套使用指标体系(覆盖率、安全性)、公共基准(如 nuScenes、Waymo Open Dataset)及多种仿真工具。测试流程通常包含计划、流水线、活动迁移和满意度判据,但缺乏统一的验收标准。
- 核心挑战:仿真保真度不足(sim-to-real gap)、场景真实性与覆盖度不确定、公共基准稀缺以及验收准则模糊是跨公司最突出的痛点。此外,部署漂移、资源限制、客户系统不稳定等工程问题也普遍存在。
- 未来趋势:专家普遍期待通过 AI 自动生成与筛选场景、世界模型提升仿真逼真度、端到端架构简化测试链路,并推动行业向更自动化、数据驱动和透明共享的方向演进。
对比与启示
与以往依赖单一数据集或仿真平台的量化研究不同,本研究首次从多个实际部署 ADS 的企业视角,系统揭示测试工程中的“隐性知识”与组织级难题。作者基于发现提出的证据中心闭环测试框架(Evidence-centered Closed-loop Testing Framework),将安全论证与操作反馈深度融合,为跨越“从测试到认证”的鸿沟提供了可操作路径,对制定行业标准和优化 DevTestOps 流程具有直接参考价值。
行业影响
落地场景
自动驾驶系统(ADS)测试的实践与框架直接影响以下产品与业务:
- 乘用车 ADAS/AD(L2+ 到 L4 级)的研发验证,尤其是场景库构建与仿真测试流水线。
- Robotaxi 与无人配送车队的安全放行决策,依赖基于证据的接受标准与闭环监控。
- 仿真测试工具链供应商,可基于本文提出的 证据中心闭环框架 设计下一代测试平台。
- 保险与监管机构可利用标准化测试流程评估 ADS 安全性,支撑政策制定。
商业价值
- 降本:自动化场景生成与 AI 增强的测试可减少高昂的实车路测里程,缩短开发周期;闭环框架通过复用测试证据避免重复工作,直接降低工程成本。
- 增收:更高效的测试流加速产品上市,在竞争激烈的市场中抢占份额;向第三方提供测试服务(如场景库、仿真环境)开辟新收入。
- 安全信誉:结构化的安全论证提升公众信任,减少因事故导致的召回与品牌损失。
与现有产品/工作流的接口
- 可无缝嵌入 CI/CD 与 Model-in-the-Loop (MiL)/Software-in-the-Loop (SiL)/Hardware-in-the-Loop (HiL) 管道,通过定义明确的证据门(Evidence Gates)与现有 DevOps 工具(如 Jenkins, GitLab CI)集成。
- 场景管理可与 CARLA、VTD、NVIDIA DRIVE Sim 等仿真引擎对接,统一场景格式(如 OpenSCENARIO),并引入 世界模型 作为评估器来校验仿真保真度。
- 测试结果与指标(如碰撞率、舒适度)可接入数据湖或 MLOps 平台,支撑持续学习与模型更新。
具体落地 use case
- 某 Robotaxi 运营商:采用本文的闭环框架,从运营数采中自动挖掘未知场景(如无保护左转遇突然横穿),注入 AI 生成模块 扩展场景变体,在云端并行仿真,产出结构化的安全证据链。新版本软件只有通过所有证据门才推送至小规模车队,实现从道路测试到仿真验证的闭环,将一次 OTA 验证成本降低 40% 以上。
- 某 Tier 1 供应商:向 OEM 提供 ADS 感知堆栈时,利用本文提出的 测试意图定义 与 场景组合覆盖 方法,构建可追溯的验收测试包。结合历史缺陷数据训练的 覆盖率预测模型,让供应商提前预估测试充分性,在项目里程碑评审中给出数据驱动的质量评估,缩短 30% 的验收周期,并减少后期集成阶段的致命缺陷。
局限
- **样本代表性与可推广性受限**:研究基于 9 家来自 6 个国家的公司的专家访谈,样本量较小且可能存在选择偏差(例如仅涵盖已愿意公开分享实践的公司),结论未必能推广至所有类型的 ADS 开发商或不同成熟度的团队;同时,所有数据均来自访谈对象的自述,存在回忆偏差与社会期望偏差,可能影响对真实实践与挑战的准确刻画。
- **提出的测试框架尚未验证**:论文基于访谈结果归纳出“证据驱动的闭环测试框架”,但该框架的可行性与有效性缺乏实证评估——未在真实开发流程中部署或与现有测试范式进行对比实验,因此其实际指导价值和对测试效率/安全性的提升效果仍待后续工作验证。
- **与已有测试标准/文献的关联分析深度有限**:尽管系统梳理了工业实践,但论文未充分将访谈发现与现有安全标准(如 ISO 21448 SOTIF、ISO 26262)、测试方法文献(如基于搜索的测试、场景生成等)进行深入对标与差异分析,导致研究者难以直接定位该框架与其他理论工作的互补或冲突关系。